Gérer les défaillances GPU dans Kubernetes pour les charges de travail IA
Kubernetes ne prend pas en charge nativement les défaillances partielles des périphériques, obligeant les ingénieurs à développer une logique de remédiation sur mesure pour les tâches coûteuses d'entraînement IA et ML.

Traduit automatiquement depuis l'original anglais.
Dans un article publié sur le blog Kubernetes en juillet 2025, Sergey Kanzhelev et Mrunal Patel ont décrit la complexité croissante de la gestion des pannes matérielles dans les environnements IA conteneurisés. Ils ont expliqué comment le modèle de ressources statique de Kubernetes peine à faire face à la nature dynamique et coûteuse des perturbations GPU dans les pipelines modernes d'apprentissage automatique.
Ce qui s'est passé
L'essor des charges de travail d'intelligence artificielle et d'apprentissage automatique a révélé des lacunes importantes dans la manière dont Kubernetes gère le matériel spécialisé. Bien que la plateforme excelle dans l'orchestration de services web standards, elle n'a pas été conçue à l'origine pour répondre aux exigences spécifiques des tâches intensives en GPU. Les auteurs ont souligné que les problèmes matériels, en particulier les défaillances GPU, sont désormais une cause majeure de perturbation dans l'entraînement IA, comme noté dans le papier Llama de 2024. Les données des équipes d'infrastructure de NVIDIA corroborent cela, montrant dix-neuf demandes de remédiation par millier de nœuds chaque jour, indiquant que la panne de périphérique est un événement opérationnel courant plutôt qu'une exception.
Kubernetes considère traditionnellement les ressources de manière binaire : une ressource est soit disponible, soit indisponible. Cette hypothèse statique échoue lorsqu'il s'agit de dégradation partielle du matériel ou d'erreurs transitoires courantes dans les centres de données à grande échelle. L'article met en contraste les hypothèses traditionnelles des charges de travail avec les réalités actuelles. Auparavant, les applications pouvaient tourner sur n'importe quel nœud, et les pods en échec étaient facilement remplacés. Aujourd'hui, les charges de travail IA nécessitent des classes de périphériques spécifiques, s'étendent souvent sur plusieurs nœuds dans des topologies complexes et impliquent des images de conteneurs massives rendant les redémarrages prohibitivement coûteux. Le temps d'inactivité sur ces nœuds spécialisés représente une perte financière significative, rendant une gestion efficace des défaillances critique.
Malgré ces défis, Kubernetes reste la plateforme dominante pour l'IA grâce à sa maturité, ses fonctionnalités de sécurité et son écosystème étendu. Les auteurs soutiennent que bien qu'il existe des plateformes alternatives, elles manquent des années de perfectionnement offertes par Kubernetes. Par conséquent, la communauté se concentre sur l'adaptation des mécanismes existants pour mieux supporter ces nouveaux types de charges de travail plutôt que de repartir de zéro.
Comment cela fonctionne
Comprendre les défaillances de périphériques nécessite d'examiner l'interaction entre plusieurs composants Kubernetes. Lorsqu'un pod est planifié, le plugin de périphérique s'enregistre auprès du kubelet, qui met à jour la capacité du nœud. Le planificateur place ensuite le pod utilisateur sur la base de cette information, et le kubelet demande au plugin d'allouer les périphériques spécifiques. Cette chaîne implique plusieurs appels réseau et changements d'état, créant de nombreux points où des interruptions peuvent se produire. Si une partie de cette séquence échoue, le pod peut échouer à l'admission, stagner pendant la planification ou tourner sur du matériel non sain.
Actuellement, Kubernetes dispose d'une logique intégrée limitée pour détecter et récupérer des défaillances spécifiques aux périphériques. Les plugins de périphériques signalent généralement les défaillances en réduisant le nombre de périphériques allouables, mais le système ne corrèle pas automatiquement cela avec les conteneurs en cours d'exécution. Des mécanismes standard tels que les sondes de vivacité peuvent détecter un plantage, mais Kubernetes redémarrera simplement le conteneur sur le même périphérique potentiellement défectueux. Cela conduit à des boucles de plantage où l'application ne peut pas se rétablir car le problème matériel sous-jacent persiste. Pour atténuer cela, les ingénieurs doivent compter sur des signaux externes et une logique personnalisée pour identifier quand un périphérique est réellement inutilisable et déclencher une stratégie de remédiation plus agressive.
Détails clés
- Les charges de travail IA/ML diffèrent des applications traditionnelles par leur besoin de matériel spécifique, leurs temps d'initialisation coûteux et leur fonctionnement en groupes coordonnés plutôt qu'en unités indépendantes.
- NVIDIA rapporte environ 19 demandes de remédiation de périphériques par 1 000 nœuds quotidiennement, soulignant la fréquence des problèmes matériels en production.
- Kubernetes manque actuellement de corrélation native entre l'état de santé des périphériques et les plantages de conteneurs, conduisant souvent à des redémarrages inefficaces sur du matériel défectueux.
- La compatibilité des pilotes est un nouveau mode de défaillance, nécessitant une correspondance stricte entre le matériel, les pilotes et les bibliothèques d'application comme NCCL.
- Les meilleures pratiques incluent la configuration d'une logique de terminaison gracieuse, la surveillance de la santé des plugins de périphériques et l'évitement de la surcharge des nœuds avec des charges de travail non critiques.
Pourquoi c'est important
Pour les ingénieurs logiciels et les responsables d'infrastructure, l'incapacité de Kubernetes à gérer nativement les défaillances partielles des périphériques signifie une surcharge opérationnelle plus élevée et des coûts accrus. Dans les services web traditionnels, un pod en échec est une mineure inconvenience. Dans l'entraînement IA, la défaillance d'un seul pod peut forcer le redémarrage d'une tâche entière de plusieurs jours, gaspillant des milliers de dollars en ressources de calcul. Le modèle de ressources statique force les équipes à construire des chiens de garde complexes et personnalisés pour surveiller la santé du matériel, détournant l'effort d'ingénierie du développement central du produit.
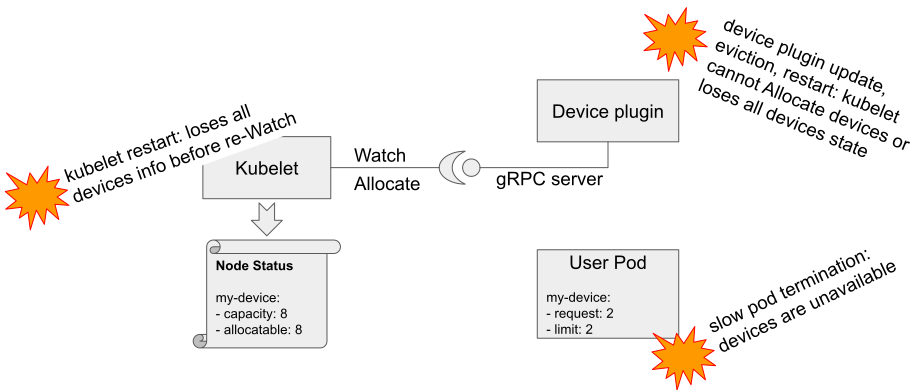
De plus, le manque de gestion normalisée des défaillances crée des problèmes de portabilité. Les solutions développées pour un cluster peuvent ne pas fonctionner dans un autre, surtout lors de l'utilisation de différents plugins de périphériques ou fournisseurs de matériel. À mesure que les organisations étendent leurs initiatives IA, ces correctifs faits maison deviennent difficiles à maintenir et à déboguer. Comprendre ces limitations est essentiel pour concevoir des architectures résilientes capables de tolérer la volatilité matérielle sans intervention manuelle.
Ce que vous pouvez faire
- Implémentez un contrôleur de santé des nœuds qui surveille la différence entre la capacité des périphériques et les compteurs allouables pour déclencher la recréation du nœud lorsque les seuils sont dépassés.
- Utilisez les politiques d'échec de pod dans les Jobs Kubernetes pour définir des codes de sortie spécifiques pour les erreurs de périphérique, permettant des tentatives ciblées plutôt que des redémarrages génériques.
- Déployez des observateurs de pods personnalisés qui utilisent l'API Pod Resources pour détecter les périphériques non sains et supprimer les pods attachés, forçant la replanification sur des nœuds sains.
- Assurez-vous que les pilotes et plugins de périphériques proviennent de sources fiables et planifiez soigneusement les mises à niveau pour maintenir la compatibilité avec votre pile d'application.
- Configurez des tolérances pour les instabilités de préparation des nœuds et mettez en place une logique de terminaison gracieuse pour empêcher les périphériques d'être verrouillés par des processus en échec.
- Évitez d'exécuter des charges de travail de faible priorité sur des nœuds dotés de matériel spécialisé pour réduire le risque d'interrompre les plugins de périphériques critiques et les opérations du kubelet.



