KubernetesにおけるAIワークロード向けGPU障害への対応
Kubernetesは部分的なデバイス障害に対するネイティブサポートを欠いており、エンジニアは高価なAIおよびMLトレーニングジョブのために独自の修復ロジックを構築せざるを得ない状況にあります。

英語の原文から自動翻訳されました。
2025年7月のKubernetes Blogの投稿で、Sergey Kanzhelev氏とMrunal Patel氏は、コンテナ化されたAI環境におけるハードウェア障害管理の複雑性が増していることを概説しました。彼らは、Kubernetesの静的リソースモデルが、現代の機械学習パイプラインにおけるGPU障害の動的かつコストのかかる性質に対処するのにいかに苦戦しているかを説明しました。
何が起きたか
人工知能(AI)および機械学習(ML)ワークロードの台頭により、Kubernetesが専用ハードウェアをどのように扱うかにおいて重要なギャップが明らかになりました。このプラットフォームは標準的なWebサービスのオーケストレーションには優れていますが、GPU集約型タスクの特定の要件に合わせて当初設計されたものではありません。著者らは、2024年のLlama論文でも指摘されている通り、ハードウェアの問題、特にGPU障害が現在AIトレーニングにおける混乱の主要な原因となっていることを強調しました。NVIDIAのインフラチームからのデータもこれを裏付けており、1,000ノードあたり毎日19件の修復リクエストが発生していることが示されています。これは、デバイス障害が例外ではなく、日常的な運用イベントであることを意味しています。
Kubernetesは従来、リソースをバイナリ(二値)として捉えていました。つまり、リソースは「利用可能」か「利用不可」かのいずれかです。この静的な前提は、大規模データセンターで一般的な部分的なハードウェア劣化や一時的なエラーに対処する際には機能しません。この記事では、従来のワークロードの仮定と現在の現実との対比が行われています。以前は、アプリケーションはどのノード上でも実行でき、失敗したPodは容易に置き換えることができました。しかし今日では、AIワークロードは特定のデバイスクラスを必要とし、多くの場合、複雑なトポロジーで複数のノードにまたがり、再起動 prohibitively expensive(極めて高額)にする巨大なコンテナイメージを含みます。これらの専用ノード上のアイドル時間は重大な経済的損失を意味するため、効率的な障害処理が不可欠です。
こうした課題があるにもかかわらず、成熟度、セキュリティ機能、そして広範なエコシステムにより、Kubernetesは依然としてAI向けの支配的なプラットフォームであり続けています。著者らは、代替プラットフォームが存在するものの、Kubernetesが提供する長年にわたる洗練さを欠いていると主張しています。その結果、コミュニティはゼロから始めるのではなく、既存のメカニズムを適応させ、これらの新しいワークロードタイプをより良くサポートすることに注力しています。
仕組み
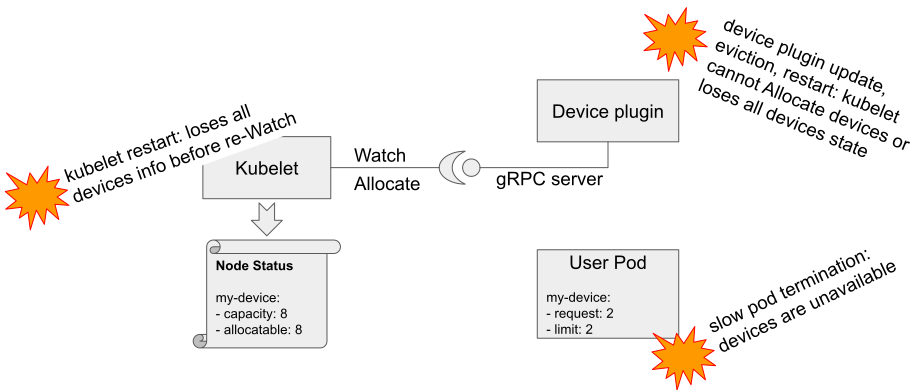
デバイス障害を理解するには、いくつかのKubernetesコンポーネント間の相互作用を見る必要があります。Podがスケジュールされると、デバイスプラグインがkubeletに登録され、kubeletはノードの容量を更新します。その後、スケジューラーはこの情報に基づいてユーザーPodを配置し、kubeletはプラグインに対して具体的なデバイスの割り当てを要求します。このチェーンには複数のネットワーク呼び出しと状態変更が含まれ、中断が発生しうる多数のポイントを生み出します。このシーケンスのどこかで失敗すると、Podはアドミッションに失敗したり、スケジューリング中に停止したり、不健全なハードウェア上で実行されたりする可能性があります。
現在、Kubernetesにはデバイス固有の障害を検出して回復するための組み込みロジックは限られています。デバイスプラグインは通常、割り当て可能なデバイスの数を減らすことで障害を報告しますが、システムはこれを稼働中のコンテナと自動的に相関付けしません。liveness probeなどの標準的なメカニズムはクラッシュを検出できる場合がありますが、Kubernetesは単に同じ潜在的に故障したデバイス上でコンテナを再起動するだけです。これにより、根本的なハードウェア問題が続くためアプリケーションが回復できないクラッシュループが発生します。これを緩和するために、エンジニアは外部シグナルとカスタムロジックに依存して、デバイスが本当に使用不能になった時期を特定し、より積極的な修復戦略をトリガーする必要があります。
主要な詳細
- AI/MLワークロードは、特定のハードウェアを必要とし、初期化時間が長く、独立したユニットではなく協調グループとして動作するという点で、従来のアプリとは異なります。
- NVIDIAは、本番環境でのハードウェア問題の頻度を浮き彫りにする、1,000ノードあたり毎日約19件のデバイス修復リクエストを報告しています。
- Kubernetesは現在、デバイスのヘルスステータスとコンテナクラッシュの間のネイティブな相関を欠いており、多くの場合、故障したハードウェア上での効果のない再起動につながります。
- ドライバー互換性は新たな障害モードであり、ハードウェア、ドライバー、NCCLなどのアプリケーションライブラリの間に厳格なマッチングが必要です。
- ベストプラクティスには、グレースフルターミネーションロジックの設定、デバイスプラグインのヘルス監視、および重要度の低いワークロードによるノードの過負荷回避が含まれます。
なぜ重要か
ソフトウェアエンジニアやインフラリードにとって、Kubernetesが部分的なデバイス障害をネイティブに処理できないことは、運用オーバーヘッドの増加とコスト上昇を意味します。従来のWebサービスでは、失敗したPodは些細な不便さに過ぎません。しかしAIトレーニングでは、単一のPod障害が数日かかるジョブ全体の再起動を強制し、数千ドル相当の計算リソースを無駄にする可能性があります。静的リソースモデルにより、チームはハードウェアのヘルスを監視するための複雑なカスタムウォッチドッグを構築せざるを得なくなり、コア製品開発へのエンジニアリングリソースがそがれます。
さらに、標準化された障害処理の欠如は移植性の問題を生み出します。あるクラスター用に開発されたソリューションが、異なるデバイスプラグインやハードウェアベンダーを使用する場合など、別のクラスターでは機能しないことがあります。組織がAIイニシアチブをスケールアップするにつれ、これらのDIY修正は維持およびデバッグが困難になります。これらの制限を理解することは、手動介入なしにハードウェアの変動に耐えうるレジリエントなアーキテクチャを設計するために不可欠です。
実施できること
- デバイス容量と割り当て可能数の差を監視し、閾値を超えた場合にノード再作成をトリガーするノードヘルスコントローラーを実装してください。
- Kubernetes JobsのPod失敗ポリシーを使用してデバイスエラー用の特定の終了コードを定義し、汎用的な再起動ではなくターゲットを絞ったリトライを可能にしてください。
- Pod Resources APIを活用して不健全なデバイスを検出し、アタッチされたPodを削除することで、健全なノード上での再スケジューリングを強制するカスタムPodウォッチャーを展開してください。
- デバイスドライバーとプラグインが信頼できるソースのものであることを確認し、アプリケーションスタックとの互換性を維持するためにアップグレードを慎重に計画してください。
- ノード準備完了の一時的な不安定性(flakes)に対するトレラションを設定し、プロセスの失敗によってデバイスがロックされるのを防ぐためにグレースフルターミネーションロジックを構成してください。
- 重要なデバイスプラグインやkubelet操作の中断リスクを低減するために、専用ハードウェアを搭載したノード上で優先度の低いワークロードを実行しないでください。



