Xử lý lỗi GPU trong Kubernetes cho các khối lượng công việc AI
Kubernetes thiếu hỗ trợ gốc cho các lỗi thiết bị một phần, buộc các kỹ sư phải xây dựng logic khắc phục tùy chỉnh cho các tác vụ huấn luyện AI và ML tốn kém.

Được dịch tự động từ bản gốc tiếng Anh.
Trong một bài đăng trên Kubernetes Blog vào tháng 7 năm 2025, Sergey Kanzhelev và Mrunal Patel đã phác thảo sự phức tạp ngày càng tăng của việc quản lý các lỗi phần cứng trong môi trường AI được đóng gói bằng container. Họ giải thích cách mô hình tài nguyên tĩnh của Kubernetes gặp khó khăn trong việc đối phó với bản chất động và đắt đỏ của các gián đoạn GPU trong các quy trình máy học hiện đại.
Chuyện gì đã xảy ra
Sự gia tăng của các khối lượng công việc trí tuệ nhân tạo (AI) và học máy (ML) đã phơi bày những khoảng trống đáng kể trong cách Kubernetes xử lý phần cứng chuyên dụng. Mặc dù nền tảng này xuất sắc trong việc điều phối các dịch vụ web tiêu chuẩn, nhưng nó không được thiết kế ban đầu cho các yêu cầu cụ thể của các tác vụ nặng về GPU. Các tác giả nhấn mạnh rằng các vấn đề phần cứng, đặc biệt là lỗi GPU, hiện là nguyên nhân chính gây gián đoạn trong quá trình huấn luyện AI, như được ghi nhận trong bài báo Llama năm 2024. Dữ liệu từ các nhóm hạ tầng của NVIDIA ủng hộ điều này, cho thấy có mười chín yêu cầu khắc phục mỗi nghìn nút (node) hàng ngày, chỉ ra rằng lỗi thiết bị là một sự kiện vận hành thường xuyên chứ không phải ngoại lệ.
Kubernetes truyền thống xem xét các tài nguyên theo dạng nhị phân: một tài nguyên hoặc là khả dụng hoặc là không. Giả định tĩnh này thất bại khi xử lý sự suy giảm phần cứng một phần hoặc các lỗi tạm thời phổ biến trong các trung tâm dữ liệu quy mô lớn. Bài viết so sánh các giả định khối lượng công việc truyền thống với thực tế hiện tại. Trước đây, các ứng dụng có thể chạy trên bất kỳ nút nào và các pod bị lỗi dễ dàng được thay thế. Ngày nay, các khối lượng công việc AI yêu cầu các lớp thiết bị cụ thể, thường trải rộng trên nhiều nút trong các cấu trúc liên kết phức tạp và liên quan đến các hình ảnh container khổng lồ khiến việc khởi động lại trở nên quá đắt đỏ. Thời gian nhàn rỗi trên các nút chuyên dụng này đại diện cho tổn thất tài chính đáng kể, làm cho việc xử lý lỗi hiệu quả trở nên then chốt.
Bất chấp những thách thức này, Kubernetes vẫn là nền tảng thống trị cho AI nhờ tính trưởng thành, các tính năng bảo mật và hệ sinh thái mở rộng. Các tác giả lập luận rằng mặc dù có các nền tảng thay thế tồn tại, chúng thiếu đi sự tinh chỉnh qua nhiều năm mà Kubernetes cung cấp. Do đó, cộng đồng tập trung vào việc thích nghi các cơ chế hiện có để hỗ trợ tốt hơn cho các loại khối lượng công việc mới này thay vì bắt đầu lại từ đầu.
Cách hoạt động
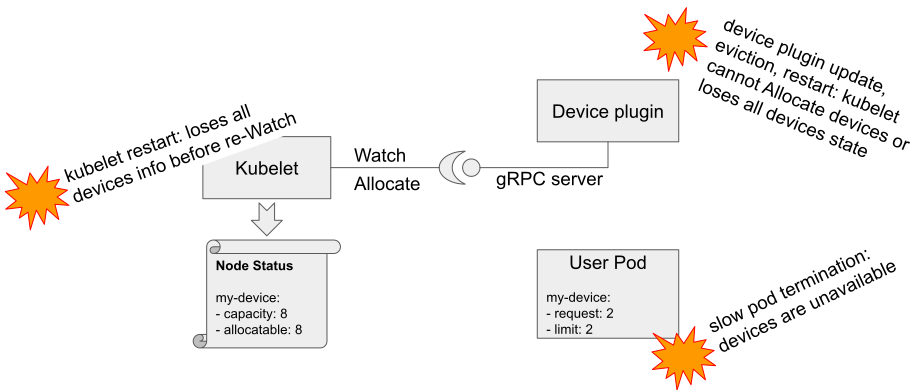
Để hiểu rõ các lỗi thiết bị, cần xem xét tương tác giữa một số thành phần Kubernetes. Khi một pod được lên lịch, plugin thiết bị đăng ký với kubelet, thành phần này cập nhật dung lượng của nút. Sau đó, bộ lập lịch đặt pod của người dùng dựa trên thông tin này, và kubelet yêu cầu plugin phân bổ các thiết bị cụ thể. Chuỗi này liên quan đến nhiều cuộc gọi mạng và thay đổi trạng thái, tạo ra vô số điểm nơi có thể xảy ra gián đoạn. Nếu bất kỳ phần nào của chuỗi này thất bại, pod có thể thất bại khi tiếp nhận, bị đình trệ trong quá trình lập lịch hoặc chạy trên phần cứng không khỏe mạnh.
Hiện tại, Kubernetes có logic tích hợp hạn chế để phát hiện và phục hồi từ các lỗi cụ thể của thiết bị. Các plugin thiết bị thường báo cáo lỗi bằng cách giảm số lượng thiết bị có thể phân bổ, nhưng hệ thống không tự động tương quan điều này với các container đang chạy. Các cơ chế tiêu chuẩn như liveness probes có thể phát hiện sự cố sập, nhưng Kubernetes sẽ đơn giản khởi động lại container trên cùng một thiết bị có thể bị lỗi. Điều này dẫn đến các vòng lặp sập (crash loops) nơi ứng dụng không thể phục hồi vì vấn đề phần cứng cơ bản vẫn còn tồn tại. Để giảm thiểu điều này, các kỹ sư phải dựa vào các tín hiệu bên ngoài và logic tùy chỉnh để xác định khi nào một thiết bị thực sự không sử dụng được và kích hoạt chiến lược khắc phục quyết liệt hơn.
Chi tiết chính
- Các khối lượng công việc AI/ML khác với các ứng dụng truyền thống ở chỗ chúng yêu cầu phần cứng cụ thể, có thời gian khởi tạo đắt đỏ và hoạt động như các nhóm phối hợp thay vì các đơn vị độc lập.
- NVIDIA báo cáo khoảng 19 yêu cầu khắc phục thiết bị trên mỗi 1.000 nút hàng ngày, làm nổi bật tần suất của các vấn đề phần cứng trong môi trường sản xuất.
- Kubernetes hiện thiếu tương quan gốc giữa trạng thái sức khỏe thiết bị và sự cố sập container, thường dẫn đến các lần khởi động lại không hiệu quả trên phần cứng bị lỗi.
- Tính tương thích của driver là một chế độ lỗi mới, đòi hỏi sự khớp chặt chẽ giữa phần cứng, driver và các thư viện ứng dụng như NCCL.
- Các thực hành tốt nhất bao gồm cấu hình logic chấm dứt nhẹ nhàng (graceful termination), giám sát sức khỏe plugin thiết bị và tránh làm quá tải các nút với các khối lượng công việc không quan trọng.
Tại sao điều này quan trọng
Đối với các kỹ sư phần mềm và lãnh đạo hạ tầng, việc Kubernetes không thể xử lý gốc các lỗi thiết bị một phần có nghĩa là chi phí vận hành cao hơn và tăng chi phí. Trong các dịch vụ web truyền thống, một pod bị lỗi là một sự bất tiện nhỏ. Trong huấn luyện AI, một lỗi pod duy nhất có thể buộc phải khởi động lại toàn bộ một tác vụ kéo dài nhiều ngày, lãng phí hàng nghìn đô la tài nguyên tính toán. Mô hình tài nguyên tĩnh buộc các đội ngũ phải xây dựng các watchdog phức tạp, tùy chỉnh để giám sát sức khỏe phần cứng, chuyển hướng nỗ lực kỹ thuật khỏi việc phát triển sản phẩm cốt lõi.
Hơn nữa, sự thiếu hụt trong việc xử lý lỗi tiêu chuẩn hóa tạo ra các vấn đề về tính di động. Các giải pháp được phát triển cho một cụm có thể không hoạt động ở cụm khác, đặc biệt là khi sử dụng các plugin thiết bị hoặc nhà cung cấp phần cứng khác nhau. Khi các tổ chức mở rộng quy mô các sáng kiến AI của họ, các bản sửa lỗi DIY (tự làm) trở nên khó duy trì và gỡ lỗi. Hiểu rõ những hạn chế này là điều cần thiết để thiết kế các kiến trúc chống chịu tốt, có thể dung nạp sự biến động của phần cứng mà không cần can thiệp thủ công.
Bạn có thể làm gì
- Triển khai một bộ điều khiển sức khỏe nút (node health controller) giám sát sự chênh lệch giữa dung lượng thiết bị và số lượng có thể phân bổ để kích hoạt việc tái tạo nút khi vượt quá ngưỡng.
- Sử dụng chính sách lỗi pod trong Kubernetes Jobs để xác định các mã thoát cụ thể cho lỗi thiết bị, cho phép thử lại có mục tiêu thay vì khởi động lại chung chung.
- Triển khai các pod watcher tùy chỉnh sử dụng Pod Resources API để phát hiện các thiết bị không khỏe mạnh và xóa các pod gắn liền, buộc phải lập lịch lại trên các nút khỏe mạnh.
- Đảm bảo các driver và plugin thiết bị đến từ các nguồn đáng tin cậy và lập kế hoạch nâng cấp cẩn thận để duy trì tính tương thích với stack ứng dụng của bạn.
- Cấu hình tolerations cho các sự cố sẵn sàng nút (node readiness flakes) và thiết lập logic chấm dứt nhẹ nhàng để ngăn thiết bị bị khóa bởi các quy trình đang thất bại.
- Tránh chạy các khối lượng công việc ưu tiên thấp trên các nút có phần cứng chuyên dụng để giảm rủi ro làm gián đoạn các plugin thiết bị quan trọng và các hoạt động của kubelet.



