Optimisation de l'inférence d'embeddings en contexte long sur Cloud TPU avec vLLM
Google détaille comment le support natif des TPUs dans vLLM permet une mise à l'échelle élastique et une inférence d'embeddings de haute précision pour les modèles Qwen3.

Traduit automatiquement depuis l'original anglais.
Dans un article publié sur le Google Developers Blog en août 2026, des ingénieurs ont décrit la manière dont ils ont intégré le support natif des Tensor Processing Units (TPU) dans vLLM. Cette mise à jour permet aux équipes d'infrastructure IA d'exécuter des modèles d'embeddings à grande échelle avec une précision de niveau entreprise, tout en tirant parti des capacités de calcul élastiques de Google Kubernetes Engine (GKE).
Ce qui s'est passé
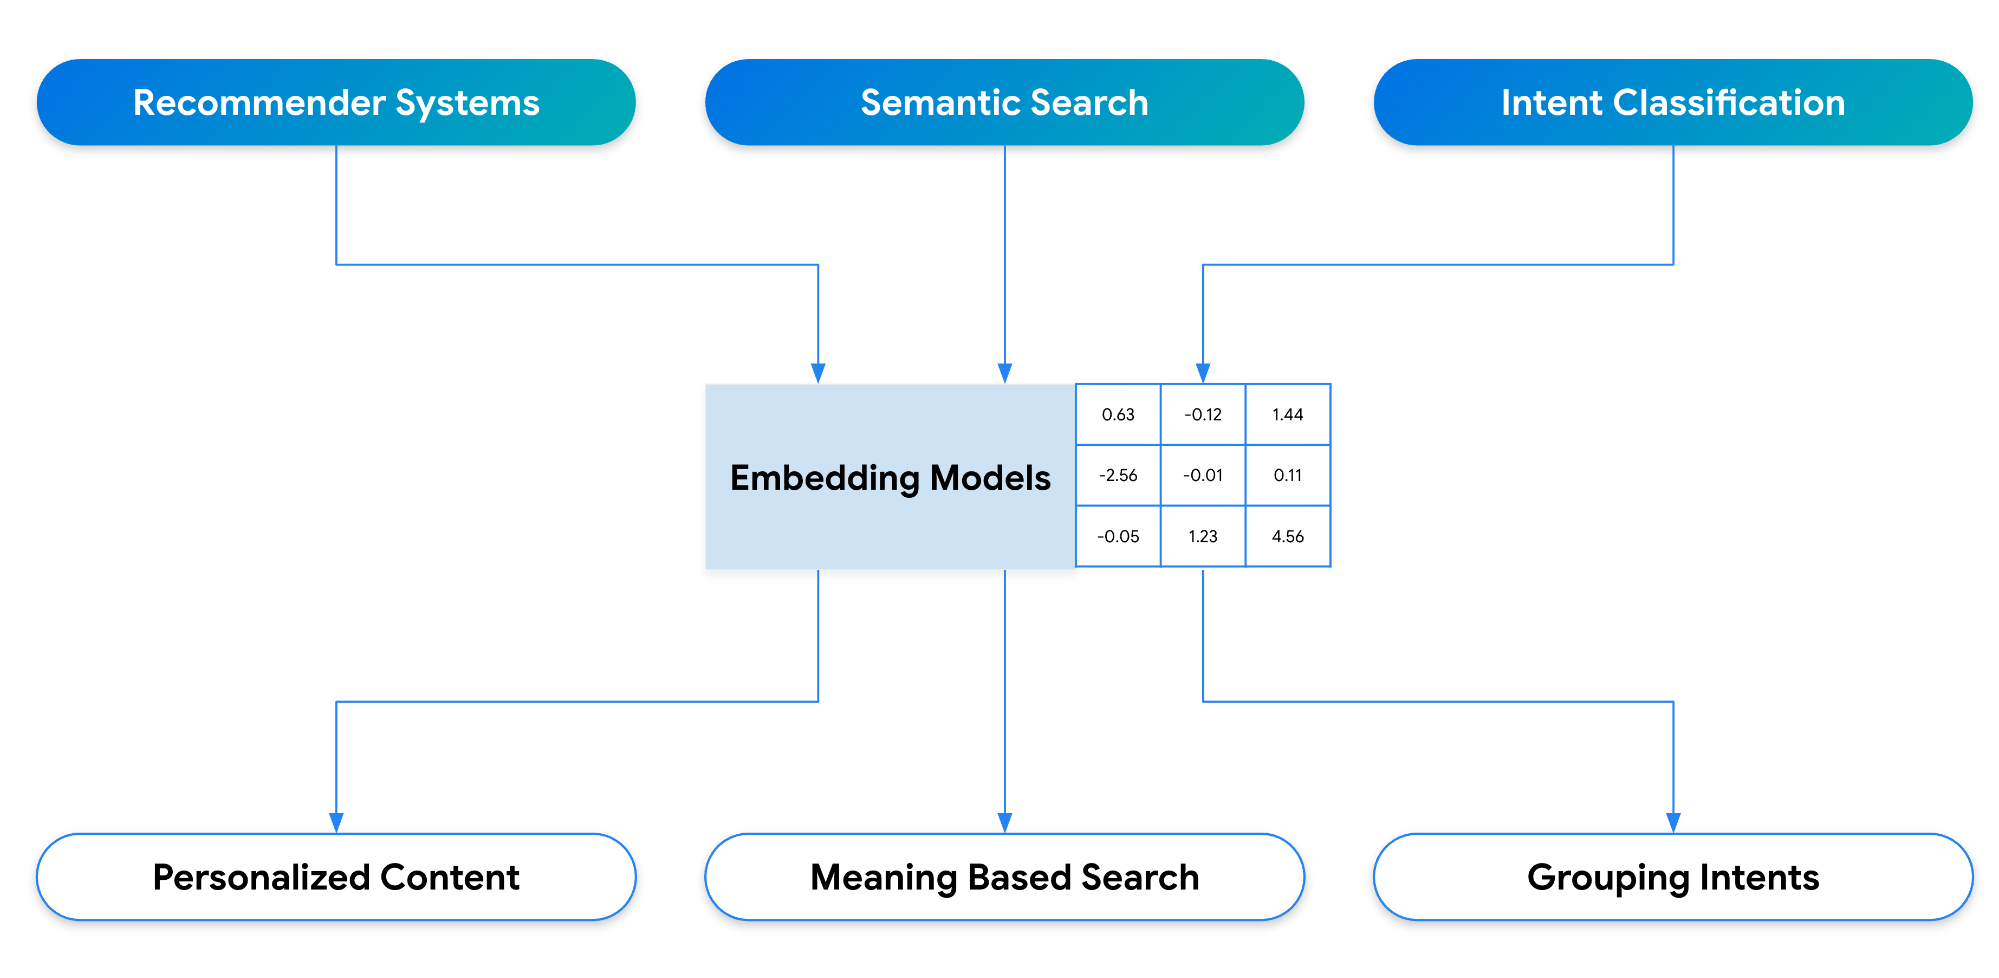
Les modèles d'embeddings sont des composants essentiels des systèmes d'IA modernes, traduisant des données non structurées telles que le texte, les images et l'audio en représentations vectorielles denses. Ces vecteurs alimentent la recherche sémantique, les moteurs de recommandation et le regroupement de contenu en capturant les relations mathématiques entre les concepts. Bien que le prototypage avec de petits modèles soit gérable, la mise à l'échelle de ces pipelines pour traiter des millions de requêtes introduit des goulets d'étranglement significatifs en matière de gestion de capacité et d'efficacité des coûts.
Pour relever ces défis, Google Cloud a ajouté le support natif des TPUs à vLLM, le moteur de service open-source populaire pour les grands modèles de langage. Cette intégration permet une véritable élasticité, permettant aux équipes d'ingénierie de faire évoluer dynamiquement la capacité de service. En approvisionnant des nœuds TPU aux côtés d'autres instances d'accélérateurs, les organisations peuvent mieux gérer les fluctuations du trafic. Si les réservations TPU principales sont entièrement utilisées, l'infrastructure peut automatiquement basculer vers des pools GPU spot ou à la demande secondaires sans interrompre le trafic d'inférence.
La mise en œuvre repose sur des primitives GKE telles que les Custom Compute Classes pour automatiser l'autoscaling des nœuds basé sur des règles de priorité strictes. Cela garantit que les charges de travail montent en charge sur différents types de capacité ou accélérateurs si la ressource préférée est indisponible. L'objectif est de maintenir une haute disponibilité et performance tout en optimisant les coûts lors des périodes de forte demande.
Comment cela fonctionne
Le service des modèles d'embeddings de nouvelle génération nécessite le traitement de contextes de séquence ultra-longs, allant de plus de 4 000 jetons pour le texte à plus de 15 000 jetons pour les entrées multimodales. Le maintien d'une parité mathématique stricte entre différents backends matériels est essentiel pour les applications d'entreprise. L'équipe s'est concentrée sur l'optimisation de la série de modèles Qwen3 Embedding sur le matériel TPU, répondant à trois défis d'ingénierie spécifiques.
Premièrement, les unités d'exécution matricielle des TPUs imposent des contraintes de divisibilité strictes lors du sharding des matrices de vocabulaire. Les ingénieurs ont mis en œuvre une stratégie de remplissage de vocabulaire sûre pour le matériel afin de garantir un alignement exact des tenseurs lors de l'exécution. Deuxièmement, ils ont renforcé le processus de matérialisation en introduisant la promotion d'attributs dans le pipeline de déquantification. Cette modification a rendu le chargement des poids compatible avec le chargeur paresseux TPU de vLLM, éliminant les échecs d'initialisation. Ils ont également implémenté un préchauffage conscient du sharding pour verrouiller les caches de compilation avant l'inférence, réduisant ainsi la latence d'exécution.
Troisièmement, la gestion des contextes ultra-longs nécessitait une nouvelle architecture pour prévenir l'épuisement de la mémoire. L'équipe a conçu un mécanisme hybride StepPool qui migre les métadonnées vers un état de requête mis en cache. Cela garantit que les états de pooling s'accumulent correctement au fil des étapes et survivent aux préemptions de requêtes. Ces optimisations permettent au système de gérer efficacement les opérations de préremplissage par blocs sans perdre l'intégrité de l'état.
Détails clés
- Le support natif des TPUs dans vLLM permet la mise à l'échelle dynamique des charges de travail d'embeddings aux côtés d'autres types d'accélérateurs.
- La solution cible les modèles Qwen3-Embedding-8B et Qwen3-VL-Embedding-8B pour les tâches textuelles et multimodales.
- Le remplissage de vocabulaire sûr pour le matériel garantit l'alignement des tenseurs à travers les maillages de topologie TPU lors de l'exécution parallèle.
- Le préchauffage conscient du sharding verrouille les caches de compilation JAX/XLA pour stabiliser les pipelines de production et réduire la latence.
- Les scores de similarité cosinus ont atteint ≥0,999 pour le texte et ≥0,995 pour les entrées multimodales par rapport aux références de base.
- Le service de Qwen3-Embedding-8B sur TPU Ironwood a atteint 83 996 jetons totaux par seconde et 5,13 requêtes par seconde.
Pourquoi c'est important
Pour les ingénieurs logiciels développant des produits d'IA, la capacité de mettre à l'échelle l'inférence d'embeddings de manière élastique est cruciale pour maintenir les accords de niveau de service (SLA) lors des pics de trafic. L'approvisionnement statique traditionnel conduit souvent à un surdimensionnement ou à une dégradation du service. En intégrant les TPUs avec vLLM et GKE, les équipes peuvent automatiser l'allocation des ressources en fonction de la demande en temps réel. Cela réduit la charge opérationnelle et améliore l'efficacité des coûts sans sacrifier la performance.
La précision est un autre facteur critique. Dans les environnements d'entreprise, même de légères divergences numériques entre les backends matériels peuvent dégrader la qualité de la recherche ou la précision des recommandations. Les évaluations rigoureuses de parité décrites dans l'article confirment que l'inférence basée sur TPU maintient un alignement quasi parfait avec les implémentations de référence. Cela donne aux développeurs confiance que la migration des charges de travail vers les TPUs ne compromettra pas la qualité de leurs fonctionnalités d'IA.
De plus, la prise en charge des entrées multimodales à contexte long ouvre de nouvelles possibilités pour les tâches de récupération complexes. Les applications ayant besoin de comprendre les relations entre de grands documents et les images associées peuvent désormais traiter ces entrées efficacement. L'architecture hybride StepPool garantit que ces charges de travail lourdes restent stables et réactives, même sous une charge élevée.
Ce que vous pouvez faire
- Consultez les recettes officielles AI-Hypercomputer Qwen3-Embedding-8B sur GitHub pour les scripts de configuration et les étapes de déploiement.
- Testez l'exemple Python fourni pour initialiser Qwen3-Embedding-8B sur Cloud TPU en utilisant le runner de pooling natif de vLLM.
- Évaluez la similarité cosinus entre vos sorties d'embeddings actuels et les vecteurs générés par TPU pour vérifier la parité numérique.
- Configurez les Custom Compute Classes dans GKE pour définir des règles de priorité pour l'autoscaling entre les ressources TPU et GPU.
- Implémentez le préchauffage conscient du sharding dans votre pipeline de déploiement pour minimiser les latences de démarrage à froid pour les charges de travail TPU.
- Explorez le dépôt public AI-Hypercomputer pour les recettes d'embeddings multimodaux si votre application traite des images et du texte.



