Kubernetes introduit une extension de l'API Gateway pour le routage de l'inférence LLM
Le projet Kubernetes a publié l'extension d'inférence de l'API Gateway afin de standardiser le routage des charges de travail d'IA générative, réduisant ainsi la latence et améliorant l'utilisation des GPU.

Traduit automatiquement depuis l'original anglais.
Dans un article publié sur le blog Kubernetes en juin 2025, des contributeurs de Solo.io, Google et Bytedance ont présenté l'extension d'inférence de l'API Gateway. Cette nouvelle extension standardisée répond aux défis spécifiques du routage du trafic pour les grands modèles de langage (LLM) auto-hébergés en ajoutant des capacités conscientes de l'inférence au framework existant de l'API Gateway.
Ce qui s'est passé
Les services modernes d'IA générative diffèrent considérablement des applications web traditionnelles. Alors que les requêtes HTTP standard sont souvent de courte durée et sans état, les sessions d'inférence LLM sont longues, gourmandes en ressources et partiellement avec état. Un serveur de modèle basé sur GPU peut maintenir des sessions d'inférence actives et conserver des caches de tokens en mémoire. Les équilibreurs de charge traditionnels, qui reposent généralement sur une simple correspondance de chemin HTTP ou une distribution round-robin, ne disposent pas de la logique spécialisée nécessaire pour gérer efficacement ces charges de travail complexes. Ils ne tiennent pas compte de l'identité du modèle ni de la criticité d'une requête, comme la distinction entre une session de chat interactive et un traitement par lots en arrière-plan.
Pour résoudre ce problème, la communauté a développé l'extension d'inférence de l'API Gateway. Ce projet s'appuie sur le modèle familier de l'API Gateway, permettant aux ingénieurs de plateforme de transformer une passerelle standard en une « Inference Gateway ». L'objectif est de fournir une approche standardisée pour le routage des charges de travail d'inférence dans l'écosystème, en s'éloignant des solutions ad hoc personnalisées. En permettant un routage conscient du modèle et en prenant en charge les niveaux de criticité par requête, l'extension vise à réduire la latence et à optimiser l'utilisation des accélérateurs tels que les GPU.
Comment cela fonctionne
L'architecture introduit deux nouvelles définitions de ressources personnalisées (CRD) qui séparent les responsabilités entre les opérateurs de plateforme et les propriétaires d'IA/ML. La première, InferencePool, définit un groupe de pods exécutant des serveurs de modèles sur des ressources de calcul partagées. Les administrateurs de plateforme utilisent cette ressource pour configurer les politiques de déploiement, de mise à l'échelle et d'équilibrage, garantissant une utilisation cohérente des ressources dans tout le cluster. Elle fonctionne de manière similaire à un Service Kubernetes, mais est spécifiquement consciente des protocoles de service de modèles.
La seconde ressource, InferenceModel, est gérée par les équipes d'IA/ML. Elle associe un nom de point de terminaison public, tel que "gpt-4-chat", à un modèle spécifique au sein d'un InferencePool. Cela permet aux propriétaires de charges de travail de définir quels modèles sont servis, y compris les variantes ajustées finement (fine-tuning), et de définir des politiques de répartition du trafic ou de priorisation. Cette séparation garantit que les équipes de plateforme gèrent l'infrastructure tandis que les équipes d'application gèrent l'exposition des modèles.
Lorsqu'un client envoie une requête, la Gateway examine l'HTTPRoute pour identifier la cible InferencePool. Au lieu de transférer le trafic vers n'importe quel pod disponible, la Gateway consulte une Extension de Sélection de Point de Terminaison. Ce composant analyse les métriques en temps réel provenant des pods, telles que la longueur des files d'attente, l'utilisation de la mémoire et les adaptateurs chargés. Il sélectionne ensuite le pod optimal en fonction des conditions en temps réel, garantissant que la requête soit traitée avec la latence la plus faible possible ou une efficacité maximale. Ce processus reste transparent pour le client, apparaissant comme une requête unique standard.
Détails clés
- Deux nouvelles CRD :
InferencePoolpour la gestion des ressources au niveau de la plateforme etInferenceModelpour les points de terminaison de modèles destinés aux utilisateurs. - Extension de Sélection de Point de Terminaison : Remplace le simple round-robin par un routage conscient des métriques qui prend en compte la profondeur de la file d'attente et l'état de la mémoire.
- Environnement de benchmark : Les tests ont utilisé vLLM version 1 sur des pods GPU H100 (80 Go) avec 10 répliques Llama2.
- Améliorations de la latence : L'extension a montré une latence p90 significativement plus faible à forte charge (plus de 500 QPS) par rapport aux Services Kubernetes standards.
- Parité de débit : Le débit est resté comparable aux services standards sur la plage testée de 100 à 1000 Requêtes par Seconde.
- Conception extensible : Le framework prend en charge des extensions supplémentaires pour de nouvelles stratégies de routage ou des besoins matériels spécialisés.
Pourquoi c'est important
Pour les équipes d'ingénierie développant des produits d'IA, cette extension offre une voie vers un service de modèles auto-hébergés plus fiable et efficace. En routant les requêtes en fonction des métriques des pods en temps réel plutôt que de règles statiques, les organisations peuvent éviter les points chauds qui surviennent lorsque la mémoire GPU approche de la saturation. Cela conduit à des latences de queue plus prévisibles, ce qui est crucial pour maintenir une expérience utilisateur fluide dans les applications interactives. La capacité de prioriser le trafic en fonction de la criticité garantit également que les interactions à haute valeur ne sont pas bloquées par des traitements par lots de priorité inférieure.
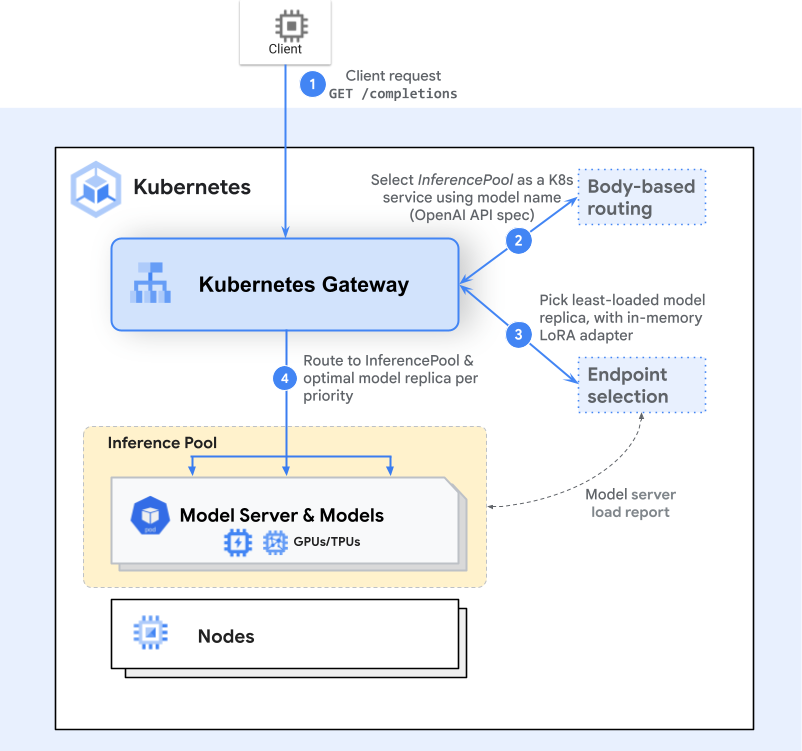
Du point de vue opérationnel, la standardisation réduit la charge de maintenance liée à la logique de routage personnalisée. Les équipes de plateforme peuvent appliquer des politiques cohérentes à travers différents modèles et équipes en utilisant les outils natifs Kubernetes. À mesure que le projet évolue vers une disponibilité générale, des fonctionnalités comme l'équilibrage de charge conscient du cache de préfixe et la prise en charge des accélérateurs hétérogènes renforceront encore son utilité. Cet alignement avec les outils natifs Kubernetes simplifie l'intégration des services GenAI dans l'infrastructure existante.
Ce que vous pouvez faire
- Consultez la documentation officielle du projet pour comprendre les spécifications de l'API et les exigences d'installation.
- Déployez une Inference Gateway de test dans un environnement non de production pour évaluer l'Extension de Sélection de Point de Terminaison.
- Mappez les services de modèles existants vers les ressources
InferencePooletInferenceModelpour tester le chemin de migration. - Surveillez les métriques de latence p90 et d'utilisation du GPU lors de tests de charge pour quantifier les gains de performance.
- Contribuez au projet en développant de nouvelles extensions pour des stratégies de routage spécifiques ou des types de matériel.
- Fournissez des retours sur les éléments de la feuille de route, tels que les pipelines d'adaptateurs LoRA et la prise en charge du service désagrégé.



