La reproduction d'OLMo 3 7B sur TPUs révèle des bugs cachés dans le chargeur de données
Une étude de cas Google reproduit le modèle OLMo 3 d'AI2 sur TPUs, égalant les métriques de performance tout en découvrant des erreurs critiques de partitionnement des données qui masquaient la mémorisation sous couvert d'amélioration.

Traduit automatiquement depuis l'original anglais.
Dans un article publié sur le Google Developers Blog en septembre 2026, des ingénieurs ont détaillé leur reproduction réussie du modèle de langage OLMo 3 7B de l'Allen Institute for AI à l'aide de MaxText sur les Google Cloud TPUs. L'équipe a correspondu aux courbes d'apprentissage originales et aux benchmarks aval, prouvant qu'une recette basée sur PyTorch pour GPU pouvait être exécutée fidèlement dans un environnement TPU basé sur JAX.
Ce qui s'est passé
L'équipe d'ingénierie s'est fixé pour objectif de valider les capacités de MaxText, un framework haute performance destiné à l'entraînement de grands modèles de langage sur TPUs. Ils ont choisi OLMo 3 car il s'agit de l'un des rares modèles de classe frontière dont les poids, les données et les recettes d'entraînement sont entièrement ouverts. Cette transparence a permis une comparaison rigoureuse avec une exécution de référence indépendante, plutôt que de se reposer uniquement sur les courbes de perte. La reproduction a couvert la pré-formation de l'étape 1 et le recuit de mi-formation de l'étape 2, utilisant les checkpoints PyTorch initiaux (step-0) d'AI2 convertis au format Orbax pour JAX.
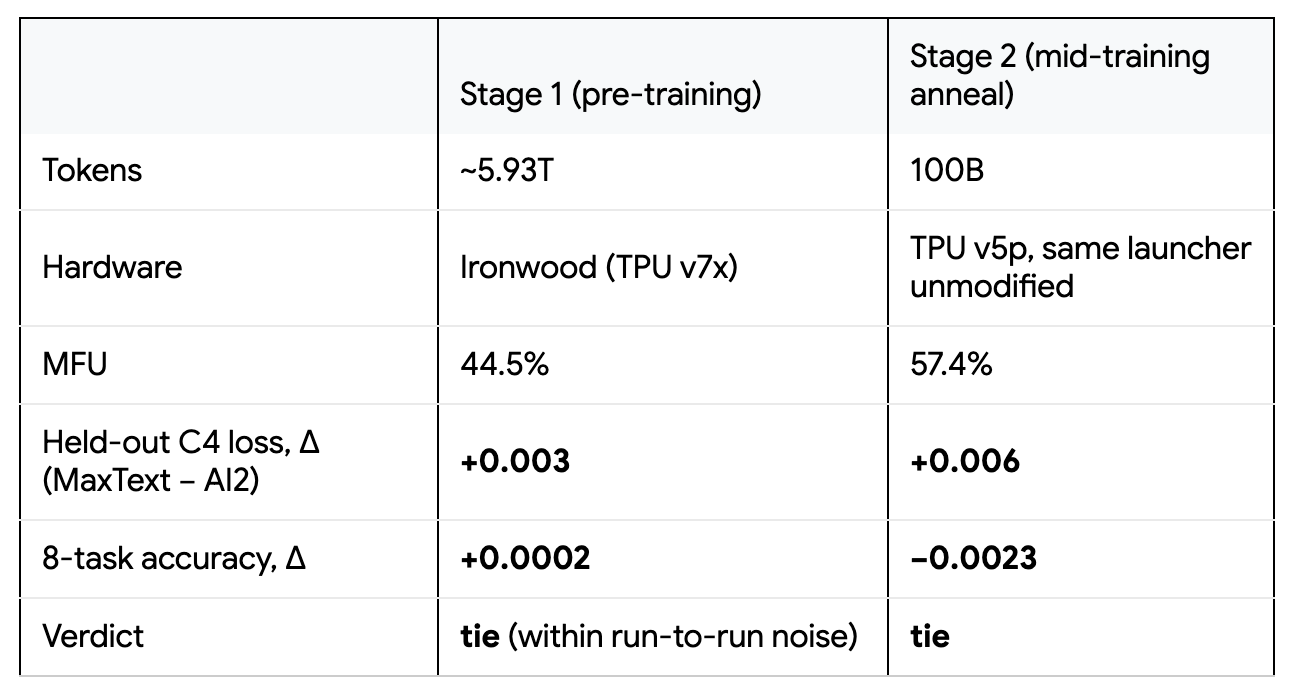
Les résultats ont montré que MaxText pouvait suivre la courbe de perte publiée par AI2 sur l'intégralité du budget de 5,93 billions de tokens. Cependant, le processus n'a pas été exempt de complications. Lors des dernières étapes de l'entraînement, l'exécution MaxText semblait surpasser la référence, la perte d'entraînement chutant nettement en dessous des niveaux d'AI2. Une investigation plus approfondie a révélé qu'il ne s'agissait pas d'une véritable amélioration de la qualité du modèle, mais d'un artefact dû à un bug de chargement des données. L'équipe a également démontré la résilience du système en redimensionnant la tâche d'entraînement en cours après avoir perdu de la capacité matérielle et en changeant de génération de TPU entre les étapes d'entraînement sans modifier la recette principale.
Comment cela fonctionne
Pour garantir la fidélité, l'équipe a porté les choix architecturaux spécifiques d'OLMo 3, notamment les blocs reordered-norm, QK-norm et un motif mixte d'attention glissante et globale, dans MaxText. Ils ont vérifié la conversion en contrôlant la parité des logits, s'assurant que le modèle converti correspondait à la référence HuggingFace dans la limite de bruit attendue pour différents frameworks. Le pipeline de données a été reconstruit à l'aide de Grain, implémentant des lectures à accès aléatoire, un mélange global des indices et un filtrage des répétitions de n-grams pour refléter exactement la configuration originale.
L'optimisation des performances a joué un rôle crucial pour rendre la reproduction réalisable. L'équipe a atteint une utilisation des flops du modèle (MFU) de 44,5 % sur les TPUs Ironwood en déchargeant les collectifs vers le SparseCore et en ajustant les stratégies de rematérialisation. Ils ont également exploré des opportunités de co-conception, telles que la reconfiguration des têtes d'attention pour mieux utiliser les unités de multiplication matricielle du TPU, ce qui a permis d'accélérer l'entraînement sans sacrifier la qualité. Ces ajustements d'ingénierie ont permis au système de maintenir son débit même lorsque les ressources matérielles changeaient dynamiquement pendant la formation multi-semaines.
Détails clés
- Correspondance des métriques : Le modèle reproduit a égalé les métriques d'évaluation hors échantillon d'AI2, y compris la perte C4 et huit tâches aval, avec des différences de précision jamais supérieures à ±0,005.
- Découverte du bug de données : Une erreur de double partitionnement dans le chargeur de données Grain a provoqué la répétition d'instances de données, abaissant artificiellement la perte d'entraînement jusqu'à 0,25 point sans améliorer la généralisation.
- Résilience matérielle : La tâche d'entraînement a repris avec succès sur une tranche de cluster un quart de la taille originale après une perte de capacité, maintenant le débit par périphérique à moins de 1 % près.
- Conversion de framework : Les poids PyTorch ont été convertis en Orbax avec une divergence KL d'environ 1,5e-3, confirmant que les modèles étaient identiques à l'initialisation.
- Recette simplifiée : L'équipe a utilisé un seul planificateur de taux d'apprentissage cosinus au lieu de l'approche à deux courbes cousues d'AI2, tout en obtenant des résultats comparables.
Pourquoi c'est important
Pour les développeurs construisant des systèmes d'IA à grande échelle, cette étude de cas met en évidence le danger de se fier exclusivement à la perte d'entraînement comme indicateur de la qualité du modèle. L'incident où MaxText semblait battre la référence en raison de la mémorisation des données sert de rappel sévère qu'une perte plus faible ne signifie pas toujours une meilleure performance. Cela souligne la nécessité d'évaluations hors échantillon rigoureuses et d'étapes de vérification indépendantes pour détecter les bugs subtils dans les pipelines de données qui peuvent autrement passer inaperçus pendant des semaines.
De plus, la reproduction réussie démontre la maturité des écosystèmes JAX et TPU pour gérer des architectures de transformeurs complexes et non standard. Elle fournit un plan directeur pour les équipes cherchant à migrer des piles PyTorch/GPU vers des environnements JAX/TPU, montrant qu'une reproduction fidèle est possible même avec des différences architecturales significatives. La capacité de redimensionner les tâches et de changer de génération de matériel en cours d'entraînement offre également des perspectives pratiques pour gérer les coûts et la fiabilité dans les tâches d'entraînement cloud de longue durée.
Ce que vous pouvez faire
- Implémentez des évaluations hors échantillon régulières parallèlement à la surveillance de la perte d'entraînement pour détecter précocement la mémorisation ou la fuite de données.
- Vérifiez la logique de partitionnement du chargeur de données avec des tests unitaires simulant des environnements multi-workers pour prévenir les duplications silencieuses de données.
- Utilisez des contrôles de parité des logits lors de la conversion de modèles entre frameworks pour assurer la cohérence de l'initialisation avant de commencer l'entraînement.
- Concevez des scripts d'entraînement capables de gérer les changements dynamiques de ressources, permettant une reprise transparente sur différentes tranches matérielles en cas de préemption.
- Comparez la précision des tâches aval à plusieurs checkpoints, et pas seulement à la fin de l'entraînement, pour garantir une croissance cohérente des capacités.
- Examinez les configurations du pipeline de données pour repérer les opérations de partitionnement redondantes, surtout lors de l'utilisation de bibliothèques comme Grain qui peuvent gérer le partitionnement en interne.



