Google démontre des boucles d'ajustement fin LLM autonomes sur TPUs
Le blog Google Developers détaille autofinetune, un système piloté par agents qui automatise le réglage des hyperparamètres pour l'apprentissage supervisé (SFT) et l'affinage post-apprentissage par renforcement (RL) sur Cloud TPUs.

Traduit automatiquement depuis l'original anglais.
Dans un article publié sur le blog Google Developers en septembre 2026, des ingénieurs ont décrit une nouvelle approche de l'optimisation des grands modèles de langage appelée autofinetune. Ce système utilise des agents IA autonomes pour gérer le cycle répétitif de l'apprentissage supervisé (fine-tuning) et de l'apprentissage par renforcement, en exécutant des expériences sur les Cloud TPUs de Google sans supervision humaine constante.
Ce qui s'est passé
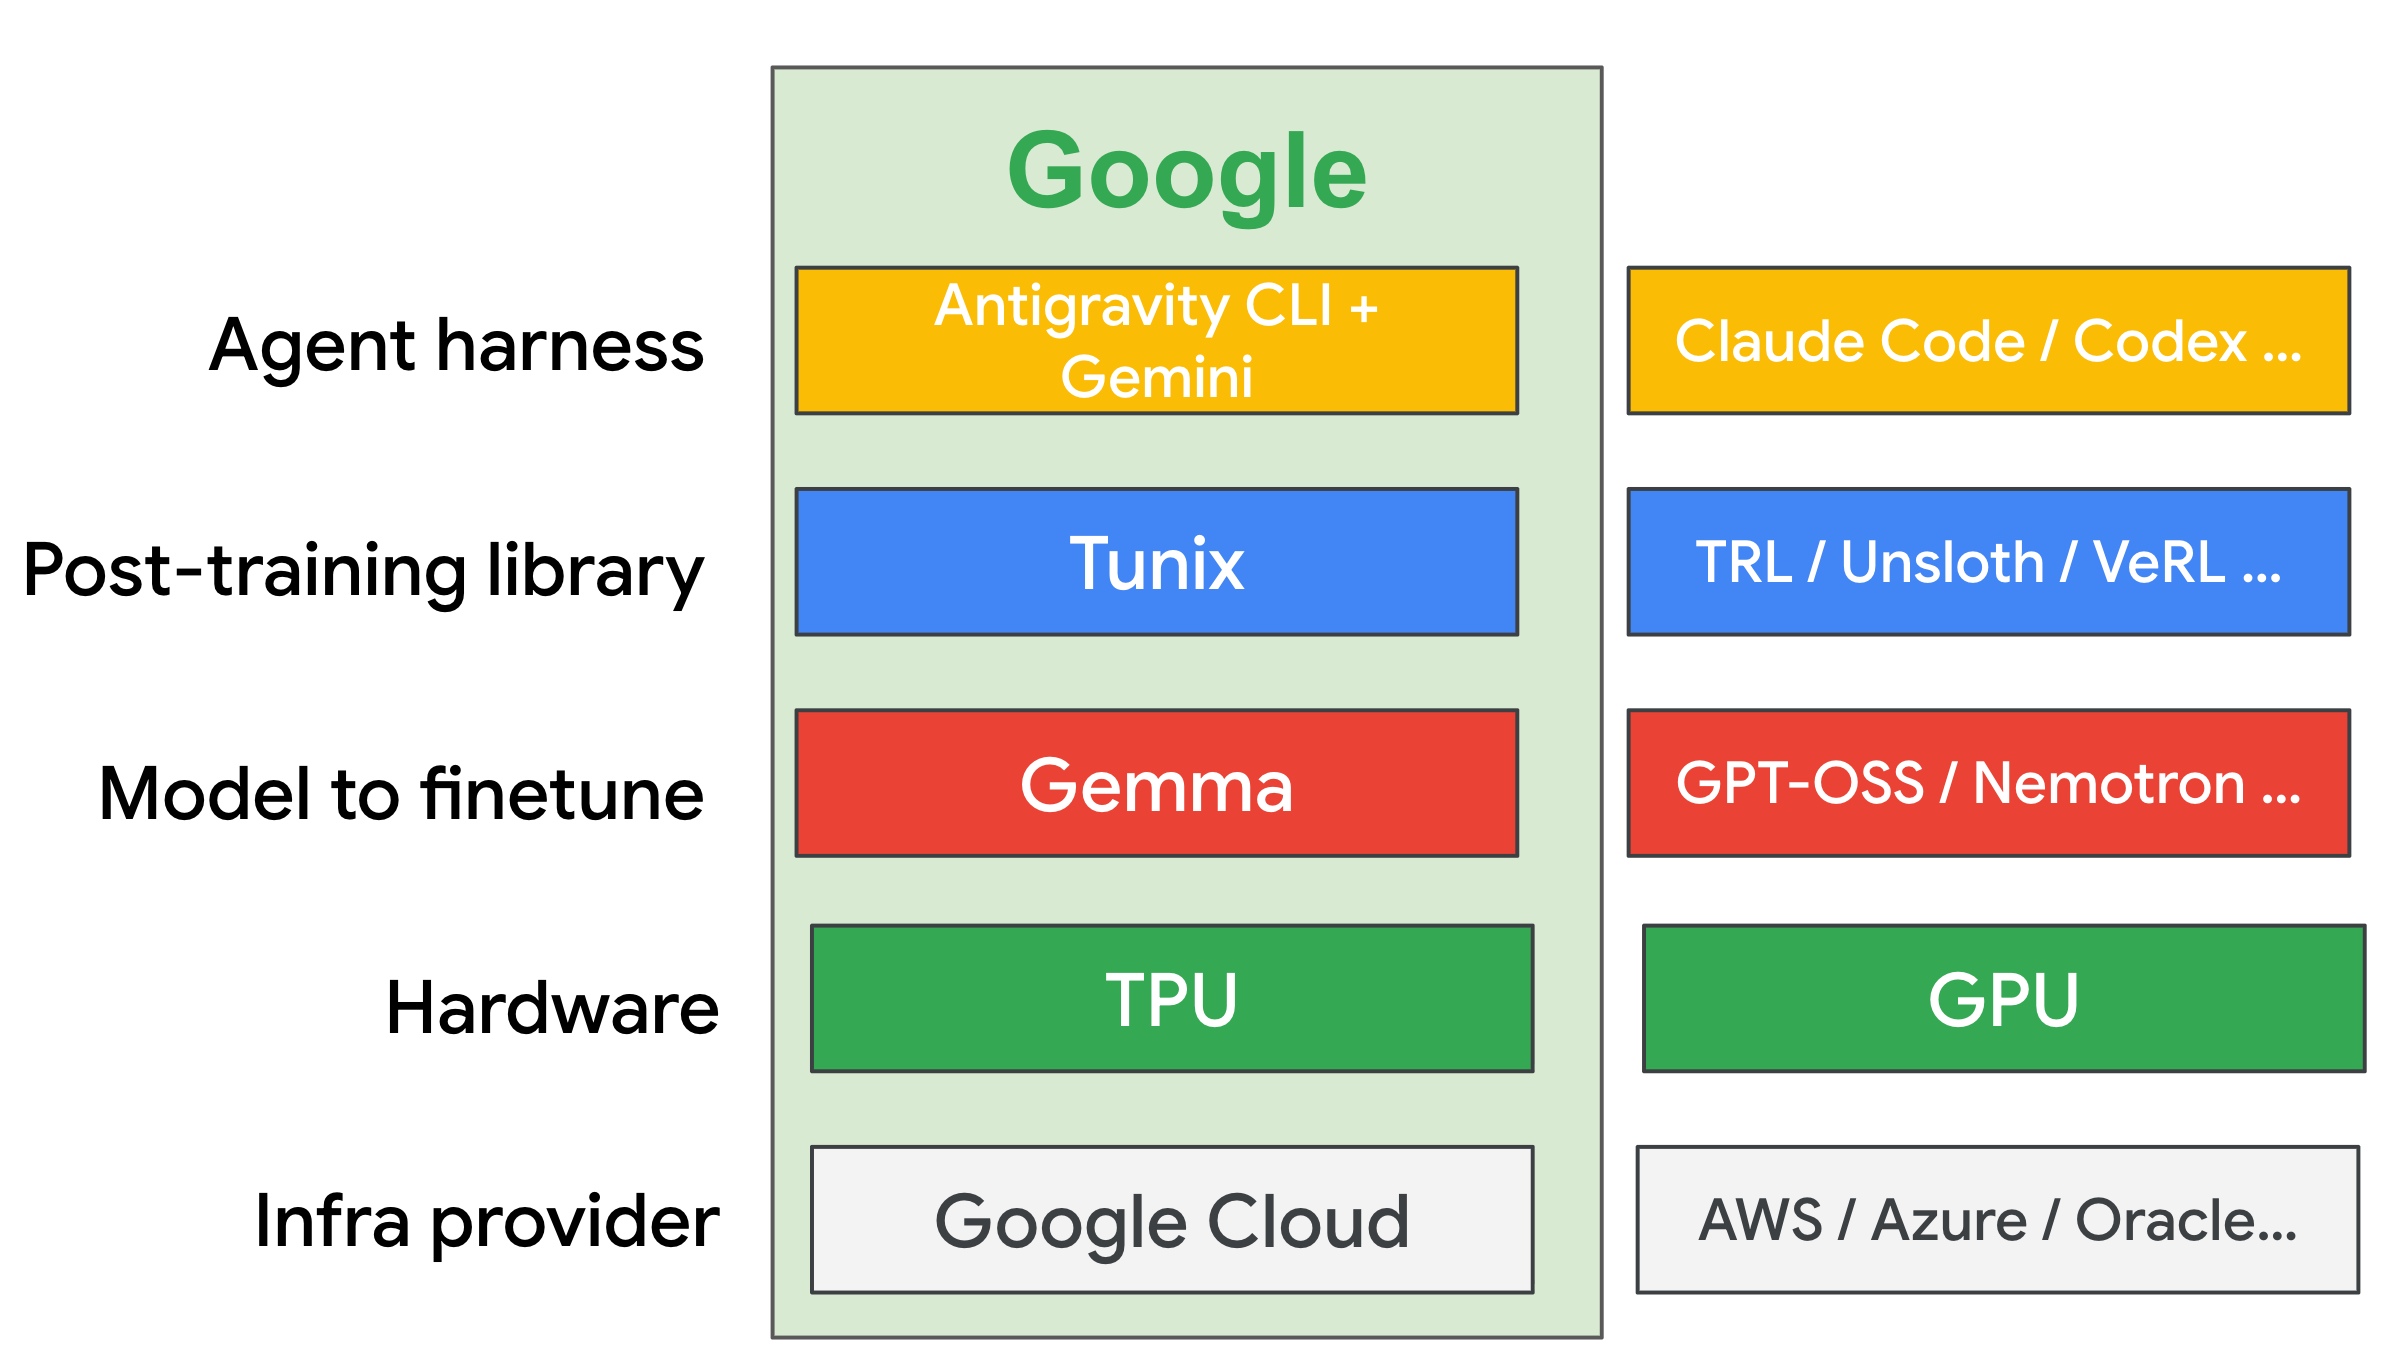
Les workflows traditionnels d'affinage post-apprentissage obligent les développeurs à formuler manuellement des hypothèses, modifier des scripts, lancer des jobs et surveiller les résultats. Ce processus est lent et sujet aux erreurs humaines. Le nouveau projet autofinetune automatise ce cycle complet en exploitant la pile IA complète de Google, incluant Tunix, les modèles Gemma et les Cloud TPUs, orchestrés via l'interface CLI Antigravity et Gemini Flash 3.7. L'objectif est de permettre aux ingénieurs de définir des contraintes de haut niveau et de laisser un agent découvrir les configurations optimales pendant la nuit.
L'équipe a démontré cette capacité à travers deux études de cas distinctes. La première portait sur l'apprentissage supervisé (SFT) utilisant le modèle google/functiongemma-270m-it sur le jeu de données google/mobile-actions. Exécutée sur un seul Cloud TPU v5e, l'agent a réalisé 20 expériences automatisées en quelques heures seulement. Il a ajusté des variables telles que le rang LoRA, les taux d'apprentissage et les optimiseurs, tout en maintenant fixes le jeu de données et l'architecture. L'agent a réussi à améliorer la précision dans la génération d'appels de fonction en affinant itérativement ces paramètres.
La deuxième étude de cas a abordé l'apprentissage par renforcement via l'optimisation de politique relative par groupe (GRPO), une méthode d'entraînement plus complexe et instable. En utilisant Gemma 3 1B sur le jeu de données de raisonnement mathématique GSM8K, l'agent a effectué 40 expériences sur deux à trois jours sur un Cloud TPU v6e. Malgré les temps d'itération plus longs et la sensibilité du RL, l'agent a identifié de meilleures configurations LoRA et températures de rollout. Cela s'est traduit par une amélioration d'environ 10 % de la métrique combinée de précision numérique et de format.
Comment cela fonctionne
Le système repose sur un changement de paradigme passant du réglage manuel à une boucle de recherche autonome. Les humains définissent le cadre en créant un fichier program.md qui établit les conditions limites, les critères d'évaluation et les contraintes. Ils fournissent également un script d'exécution propre et autonome appelé run.py. L'agent IA prend ensuite le relais, lisant les instructions dans program.md pour modifier run.py, lancer des jobs d'entraînement et mesurer les métriques cibles.
Si une expérience apporte des améliorations, l'agent valide les modifications dans Git et consigne les résultats dans un fichier results.tsv. Si une modification entraîne une régression, l'agent revient en arrière. Ce système en boucle fermée permet une ascension continue vers de meilleures performances sans intervention manuelle. L'agent explore un espace de recherche défini, comme les optimiseurs ou tailles de batch autorisés, tout en respectant les changements interdits, tels que la modification de l'architecture centrale du modèle.
Détails clés
- Le projet utilise la bibliothèque Tunix de Google, les modèles Gemma et les Cloud TPUs, orchestrés avec l'interface CLI Antigravity et Gemini Flash 3.7.
- Dans l'étude de cas SFT, l'agent a lancé 20 expériences en quelques heures sur un Cloud TPU v5e-1, optimisant les rangs LoRA et les taux d'apprentissage.
- Pour l'étude de cas GRPO, l'agent a mené 40 expériences sur 2–3 jours sur un Cloud TPU v6e-1, améliorant la récompense totale d'environ 10 %.
- Les opérateurs humains définissent les contraintes dans
program.md, spécifiant les paramètres autorisés comme la taille de batch et les changements interdits comme les échanges de jeux de données. - L'agent gère automatiquement le contrôle de version, validant les configurations réussies dans Git et consignant les métriques dans
results.tsv. - La métrique objective pour l'expérience RL était une somme simplifiée de la précision numérique et de la précision de format.
Pourquoi c'est important
Pour les équipes logicielles développant des produits IA, le goulot d'étranglement ne réside souvent pas dans l'architecture du modèle, mais dans le processus fastidieux de réglage des hyperparamètres. L'expérimentation manuelle est gourmande en ressources et difficile à mettre à l'échelle. En automatisant ce cycle, les ingénieurs peuvent récupérer le temps consacré à la surveillance des courbes de perte et à la gestion des tableurs. Ce changement permet aux équipes de se concentrer sur la définition de problèmes de plus haut niveau et la qualité des données plutôt que sur les aspects mécaniques des sessions d'entraînement.
De plus, les agents autonomes peuvent explorer les espaces de configuration plus minutieusement que les humains ne pourraient le tenter en raison de la fatigue ou des contraintes de temps. La capacité de lancer des dizaines d'expériences pendant la nuit signifie des cycles d'itération plus rapides et potentiellement des modèles mieux performants. Ceci est particulièrement précieux pour l'apprentissage par renforcement, où l'instabilité rend le réglage manuel particulièrement difficile. L'intégration avec des outils existants comme Git garantit que les expériences réussies sont suivies et reproductibles, maintenant ainsi la rigueur d'ingénierie.
Ce que vous pouvez faire
- Consultez le dépôt GitHub
autofinetunepour accéder au code, aux exemples d'exécution et aux modèlesprogram.mdfournis par l'équipe. - Définissez clairement les conditions limites et les métriques d'évaluation pour vos propres tâches d'affinage avant de tenter l'automatisation.
- Commencez par des expériences simples d'apprentissage supervisé pour comprendre comment l'agent interagit avec vos scripts d'entraînement.
- Utilisez la bibliothèque Tunix et les Cloud TPUs pour reproduire l'environnement matériel décrit dans les études de cas.
- Surveillez les journaux
results.tsvpour comprendre le processus de prise de décision de l'agent et identifier les motifs dans les configurations réussies. - Expérimentez avec différents ensembles de contraintes dans
program.mdpour équilibrer la vitesse d'exploration avec le coût computationnel.



