Gestión de fallos de GPU en Kubernetes para cargas de trabajo de IA
Kubernetes carece de soporte nativo para fallos parciales de dispositivos, lo que obliga a los ingenieros a crear lógica de remediación personalizada para costosos trabajos de entrenamiento de IA y ML.

Traducido automáticamente del original en inglés.
En una publicación en el blog de Kubernetes en julio de 2025, Sergey Kanzhelev y Mrunal Patel describieron la creciente complejidad de gestionar fallos de hardware en entornos de IA contenedorizados. Explicaron cómo el modelo de recursos estático de Kubernetes tiene dificultades para hacer frente a la naturaleza dinámica y costosa de las interrupciones de GPU en los pipelines modernos de aprendizaje automático.
Qué ocurrió
El auge de las cargas de trabajo de inteligencia artificial y aprendizaje automático ha expuesto brechas significativas en la forma en que Kubernetes gestiona el hardware especializado. Si bien la plataforma destaca en la orquestación de servicios web estándar, no fue diseñada originalmente para las demandas específicas de tareas intensivas en GPU. Los autores destacaron que los problemas de hardware, particularmente los fallos de GPU, son ahora una causa principal de interrupción en el entrenamiento de IA, como se señala en el artículo sobre Llama de 2024. Los datos de los equipos de infraestructura de NVIDIA respaldan esto, mostrando diecinueve solicitudes de remediación por cada mil nodos diarios, lo que indica que el fallo de dispositivo es un evento operativo rutinario y no una excepción.
Kubernetes tradicionalmente ve los recursos como binarios: un recurso está disponible o no lo está. Esta suposición estática falla al tratar con la degradación parcial del hardware o los errores transitorios comunes en centros de datos a gran escala. El artículo contrasta las suposiciones tradicionales de carga de trabajo con las realidades actuales. Anteriormente, las aplicaciones podían ejecutarse en cualquier nodo y los pods fallidos se reemplazaban fácilmente. Hoy en día, las cargas de trabajo de IA requieren clases de dispositivos específicos, a menudo abarcan múltiples nodos en topologías complejas e involucran imágenes de contenedores masivas que hacen que los reinicios sean prohibitivamente costosos. El tiempo de inactividad en estos nodos especializados representa una pérdida financiera significativa, lo que hace crítico un manejo eficiente de los fallos.
A pesar de estos desafíos, Kubernetes sigue siendo la plataforma dominante para IA debido a su madurez, características de seguridad y extenso ecosistema. Los autores argumentan que, aunque existen plataformas alternativas, carecen de los años de refinamiento que ofrece Kubernetes. En consecuencia, la comunidad se centra en adaptar los mecanismos existentes para apoyar mejor estos nuevos tipos de carga de trabajo en lugar de empezar desde cero.
Cómo funciona
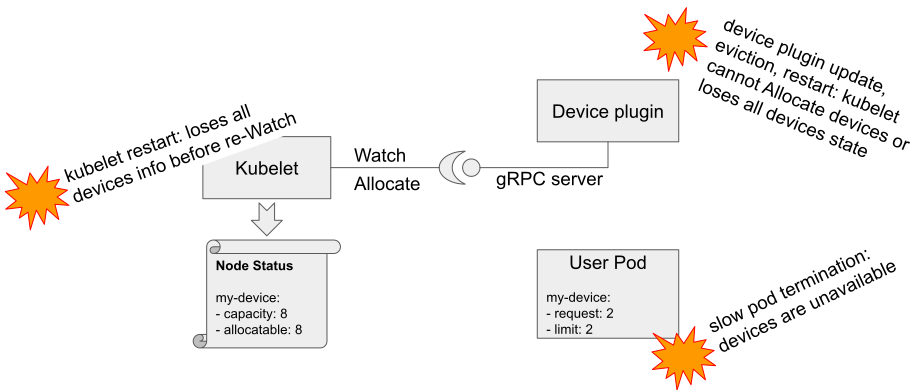
Comprender los fallos de dispositivos requiere examinar la interacción entre varios componentes de Kubernetes. Cuando se programa un pod, el plugin de dispositivo se registra con el kubelet, que actualiza la capacidad del nodo. Luego, el planificador coloca el pod del usuario basándose en esta información, y el kubelet solicita al plugin asignar los dispositivos específicos. Esta cadena implica múltiples llamadas de red y cambios de estado, creando numerosos puntos donde pueden ocurrir interrupciones. Si alguna parte de esta secuencia falla, el pod puede fallar en la admisión, estancarse durante la programación o ejecutarse en hardware no saludable.
Actualmente, Kubernetes tiene una lógica integrada limitada para detectar y recuperarse de fallos específicos de dispositivos. Los plugins de dispositivo suelen reportar fallos reduciendo el recuento de dispositivos asignables, pero el sistema no correlaciona automáticamente esto con los contenedores en ejecución. Mecanismos estándar como las sondas de vitalidad pueden detectar un bloqueo, pero Kubernetes simplemente reiniciará el contenedor en el mismo dispositivo potencialmente defectuoso. Esto conduce a bucles de bloqueo donde la aplicación no puede recuperarse porque persiste el problema subyacente de hardware. Para mitigar esto, los ingenieros deben depender de señales externas y lógica personalizada para identificar cuándo un dispositivo es realmente inutilizable y desencadenar una estrategia de remediación más agresiva.
Detalles clave
- Las cargas de trabajo de IA/ML difieren de las aplicaciones tradicionales al requerir hardware específico, tener tiempos de inicialización costosos y operar como grupos coordinados en lugar de unidades independientes.
- NVIDIA reporta aproximadamente 19 solicitudes de remediación de dispositivos por cada 1.000 nodos diariamente, destacando la frecuencia de los problemas de hardware en producción.
- Kubernetes actualmente carece de una correlación nativa entre el estado de salud del dispositivo y los bloqueos de contenedores, lo que a menudo lleva a reinicios ineficaces en hardware defectuoso.
- La compatibilidad de controladores es un nuevo modo de fallo, requiriendo una coincidencia estricta entre hardware, controladores y bibliotecas de aplicaciones como NCCL.
- Las mejores prácticas incluyen configurar lógica de terminación elegante, monitorear la salud del plugin de dispositivo y evitar sobrecargar los nodos con cargas de trabajo no críticas.
Por qué importa
Para ingenieros de software y líderes de infraestructura, la incapacidad de Kubernetes para manejar nativamente los fallos parciales de dispositivos significa mayor sobrecarga operativa y costos incrementados. En servicios web tradicionales, un pod fallido es una molestia menor. En el entrenamiento de IA, un solo fallo de pod puede forzar el reinicio de un trabajo completo de varios días, desperdiciando miles de dólares en recursos de cómputo. El modelo de recursos estático obliga a los equipos a construir vigilantes personalizados complejos para monitorear la salud del hardware, desviando el esfuerzo de ingeniería del desarrollo central del producto.
Además, la falta de manejo estandarizado de fallos crea problemas de portabilidad. Las soluciones desarrolladas para un clúster pueden no funcionar en otro, especialmente cuando se usan diferentes plugins de dispositivo o proveedores de hardware. A medida que las organizaciones escalan sus iniciativas de IA, estas soluciones caseras se vuelven difíciles de mantener y depurar. Comprender estas limitaciones es esencial para diseñar arquitecturas resilientes que puedan tolerar la volatilidad del hardware sin intervención manual.
Qué puedes hacer
- Implementa un controlador de salud de nodos que monitoree la diferencia entre la capacidad del dispositivo y los recuentos asignables para desencadenar la recreación del nodo cuando se superen los umbrales.
- Usa políticas de fallo de pod en Jobs de Kubernetes para definir códigos de salida específicos para errores de dispositivo, permitiendo reintentos dirigidos en lugar de reinicios genéricos.
- Despliega observadores de pods personalizados que utilicen la API de Recursos de Pod para detectar dispositivos no saludables y eliminar los pods adjuntos, forzando la reprogramación en nodos sanos.
- Asegúrate de que los controladores y plugins de dispositivos provengan de fuentes confiables y planifica las actualizaciones cuidadosamente para mantener la compatibilidad con tu pila de aplicaciones.
- Configura tolerancias para fluctuaciones de preparación de nodos y establece lógica de terminación elegante para evitar que los procesos fallidos bloqueen los dispositivos.
- Evita ejecutar cargas de trabajo de baja prioridad en nodos con hardware especializado para reducir el riesgo de interrumpir plugins de dispositivos críticos y operaciones del kubelet.



