Umgang mit GPU-Ausfällen in Kubernetes für AI-Workloads
Kubernetes bietet keine native Unterstützung für partielle Geräteausfälle, was Ingenieure dazu zwingt, benutzerdefinierte Wiederherstellungslogiken für kostspielige AI- und ML-Trainingsjobs zu entwickeln.

Automatisch aus dem englischen Original übersetzt.
In einem Beitrag im Kubernetes Blog vom Juli 2025 skizzierten Sergey Kanzhelev und Mrunal Patel die wachsende Komplexität bei der Verwaltung von Hardwareausfällen in containerisierten KI-Umgebungen. Sie erläuterten, wie das statische Ressourcenmodell von Kubernetes Schwierigkeiten hat, mit der dynamischen und kostspieligen Natur von GPU-Störungen in modernen Machine-Learning-Pipelines umzugehen.
Was passiert ist
Der Anstieg von Workloads im Bereich künstliche Intelligenz und maschinelles Lernen hat erhebliche Lücken in der Art und Weise aufgezeigt, wie Kubernetes spezialisierte Hardware verwaltet. Während die Plattform hervorragend darin ist, Standard-Web-Services zu orchestrieren, wurde sie ursprünglich nicht für die spezifischen Anforderungen von GPU-intensiven Aufgaben entwickelt. Die Autoren hoben hervor, dass Hardwareprobleme, insbesondere GPU-Ausfälle, nun eine Hauptursache für Störungen beim KI-Training sind, wie im Llama-Paper von 2024 vermerkt. Daten aus den Infrastrukturteams von NVIDIA unterstützen dies und zeigen neunzehn Wiederherstellungsanfragen pro Tausend Knoten täglich, was darauf hindeutet, dass Geräteausfälle ein routinemäßiges betriebliches Ereignis und keine Ausnahme sind.
Kubernetes betrachtet Ressourcen traditionell als binär: Eine Ressource ist entweder verfügbar oder nicht. Diese statische Annahme versagt bei der Bewältigung von teilweiser Hardware-Degradation oder transienten Fehlern, die in großen Rechenzentren üblich sind. Der Artikel stellt herkömmliche Workload-Anahmen den aktuellen Realitäten gegenüber. Früher konnten Anwendungen auf jedem Knoten ausgeführt werden, und fehlgeschlagene Pods wurden einfach ersetzt. Heute erfordern KI-Workloads bestimmte Geräteklassen, erstrecken sich oft über mehrere Knoten in komplexen Topologien und beinhalten massive Container-Images, die Neustarts prohibitiv teuer machen. Leerlaufzeiten auf diesen spezialisierten Knoten stellen einen erheblichen finanziellen Verlust dar, was eine effiziente Fehlerbehandlung kritisch macht.
Trotz dieser Herausforderungen bleibt Kubernetes aufgrund seiner Reife, Sicherheitsfunktionen und des umfangreichen Ökosystems die dominierende Plattform für KI. Die Autoren argumentieren, dass alternative Plattformen zwar existieren, ihnen aber die jahrelange Verfeinerung fehlt, die Kubernetes bietet. Folglich konzentriert sich die Community darauf, bestehende Mechanismen anzupassen, um diese neuen Workload-Typen besser zu unterstützen, anstatt bei Null anzufangen.
Wie es funktioniert
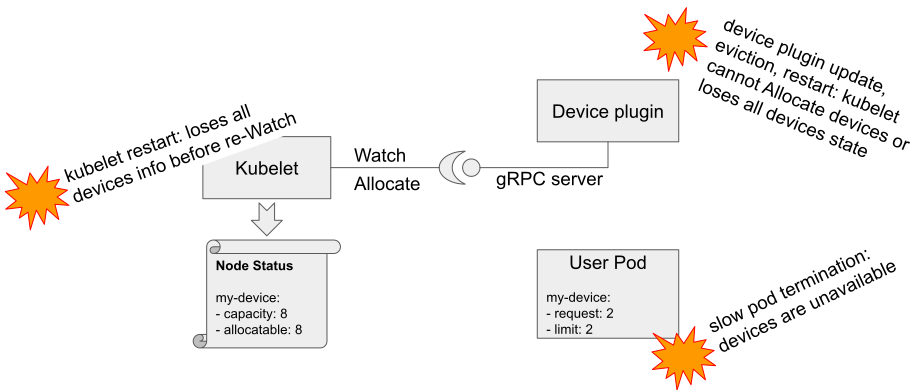
Das Verständnis von Geräteausfällen erfordert einen Blick auf die Interaktion zwischen mehreren Kubernetes-Komponenten. Wenn ein Pod geplant wird, registriert sich das Device Plugin beim Kubelet, das die Kapazität des Knotens aktualisiert. Der Scheduler platziert dann den Benutzer-Pod basierend auf diesen Informationen, und das Kubelet bittet das Plugin, die spezifischen Geräte zuzuweisen. Diese Kette umfasst mehrere Netzwerkanrufe und Zustandsänderungen, was zahlreiche Punkte schafft, an denen Unterbrechungen auftreten können. Wenn ein Teil dieser Sequenz fehlschlägt, kann der Pod die Zulassung verweigern, während der Planung stecken bleiben oder auf ungesunder Hardware laufen.
Derzeit verfügt Kubernetes nur über begrenzte integrierte Logik zur Erkennung und Wiederherstellung nach gerätespezifischen Ausfällen. Device Plugins melden Ausfälle typischerweise durch Verringerung der Anzahl der zuweisbaren Geräte, aber das System korreliert dies nicht automatisch mit laufenden Containern. Standardmechanismen wie Liveness Probes können einen Absturz erkennen, aber Kubernetes startet den Container einfach auf demselben potenziell fehlerhaften Gerät neu. Dies führt zu Crash-Loops, bei denen die Anwendung nicht wiederhergestellt werden kann, weil das zugrunde liegende Hardwareproblem weiterhin besteht. Um dies abzumildern, müssen Ingenieure auf externe Signale und benutzerdefinierte Logik zurückgreifen, um festzustellen, wann ein Gerät tatsächlich unbrauchbar ist, und eine aggressivere Wiederherstellungsstrategie auszulösen.
Wichtige Details
- AI/ML-Workloads unterscheiden sich von traditionellen Apps dadurch, dass sie spezifische Hardware erfordern, teure Initialisierungszeiten haben und als koordinierte Gruppen statt als unabhängige Einheiten operieren.
- NVIDIA meldet ungefähr 19 Geräte-Wiederherstellungsanfragen pro 1.000 Knoten täglich, was die Häufigkeit von Hardwareproblemen in der Produktion unterstreicht.
- Kubernetes mangelt es derzeit an einer nativen Korrelation zwischen dem Gesundheitsstatus des Geräts und Container-Abstürzen, was oft zu ineffektiven Neustarts auf fehlerhafter Hardware führt.
- Treiberkompatibilität ist ein neuer Fehlermodus, der eine strikte Übereinstimmung zwischen Hardware, Treibern und Anwendungs-Bibliotheken wie NCCL erfordert.
- Best Practices umfassen die Konfiguration von Graceful Termination Logic, die Überwachung der Gesundheit der Device Plugins und die Vermeidung der Überlastung von Knoten mit unkritischen Workloads.
Warum es wichtig ist
Für Software-Ingenieure und Infrastructure Leads bedeutet die Unfähigkeit von Kubernetes, partielle Geräteausfälle nativ zu behandeln, höheren operativen Overhead und steigende Kosten. In traditionellen Web-Services ist ein fehlgeschlagener Pod eine geringfügige Unannehmlichkeit. Im KI-Training kann ein einzelner Pod-Ausfall einen Neustart eines gesamten mehrtägigen Jobs erzwingen und Tausende von Dollar an Compute-Ressourcen verschwenden. Das statische Ressourcenmodell zwingt Teams dazu, komplexe, benutzerdefinierte Watchdogs zu entwickeln, um die Hardware-Gesundheit zu überwachen, und lenkt Engineering-Aufwand von der Kernproduktentwicklung ab.
Darüber hinaus schafft der Mangel an standardisierter Fehlerbehandlung Portabilitätsprobleme. Lösungen, die für einen Cluster entwickelt wurden, funktionieren möglicherweise nicht in einem anderen, insbesondere wenn unterschiedliche Device Plugins oder Hardware-Anbieter verwendet werden. Wenn Organisationen ihre KI-Initiativen skalieren, werden diese DIY-Fixes schwer zu warten und zu debuggen. Das Verständnis dieser Einschränkungen ist entscheidend für die Gestaltung widerstandsfähiger Architekturen, die Hardware-Volatilität ohne manuelle Eingriffe tolerieren können.
Was Sie tun können
- Implementieren Sie einen Node Health Controller, der die Differenz zwischen Gerätekapazität und zuweisbaren Counts überwacht, um die Knoten-Recreation auszulösen, wenn Schwellenwerte überschritten werden.
- Verwenden Sie Pod Failure Policies in Kubernetes Jobs, um spezifische Exit Codes für Gerätefehler zu definieren, was gezielte Retries statt generischer Neustarts ermöglicht.
- Stellen Sie benutzerdefinierte Pod Watchers bereit, die die Pod Resources API nutzen, um ungesunde Geräte zu erkennen und angehängte Pods zu löschen, was eine Neuplanung auf gesunden Knoten erzwingt.
- Stellen Sie sicher, dass Gerätetreiber und Plugins aus vertrauenswürdigen Quellen stammen, und planen Sie Upgrades sorgfältig, um die Kompatibilität mit Ihrem Application Stack zu gewährleisten.
- Konfigurieren Sie Tolerations für Node Readiness Flakes und richten Sie Graceful Termination Logic ein, um zu verhindern, dass Geräte durch fehlerhafte Prozesse gesperrt werden.
- Vermeiden Sie die Ausführung von Low-Priority Workloads auf Knoten mit spezialisierter Hardware, um das Risiko zu reduzieren, kritische Device Plugins und Kubelet-Operationen zu unterbrechen.



