Optimierung der Inferenz für Long-Context-Embeddings auf Cloud TPU mit vLLM
Google erläutert, wie die native TPU-Unterstützung in vLLM elastische Skalierung und hochpräzise Embedding-Inferenz für Qwen3-Modelle ermöglicht.

Automatisch aus dem englischen Original übersetzt.
In einem Beitrag im Google Developers Blog im August 2026 beschrieben Ingenieure, wie sie die native Unterstützung für Tensor Processing Units (TPU) in vLLM integriert haben. Dieses Update ermöglicht es Teams für KI-Infrastruktur, große Embedding-Modelle mit Präzision im Enterprise-Bereich auszuführen und dabei die elastischen Rechenkapazitäten von Google Kubernetes Engine (GKE) zu nutzen.
Was passiert ist
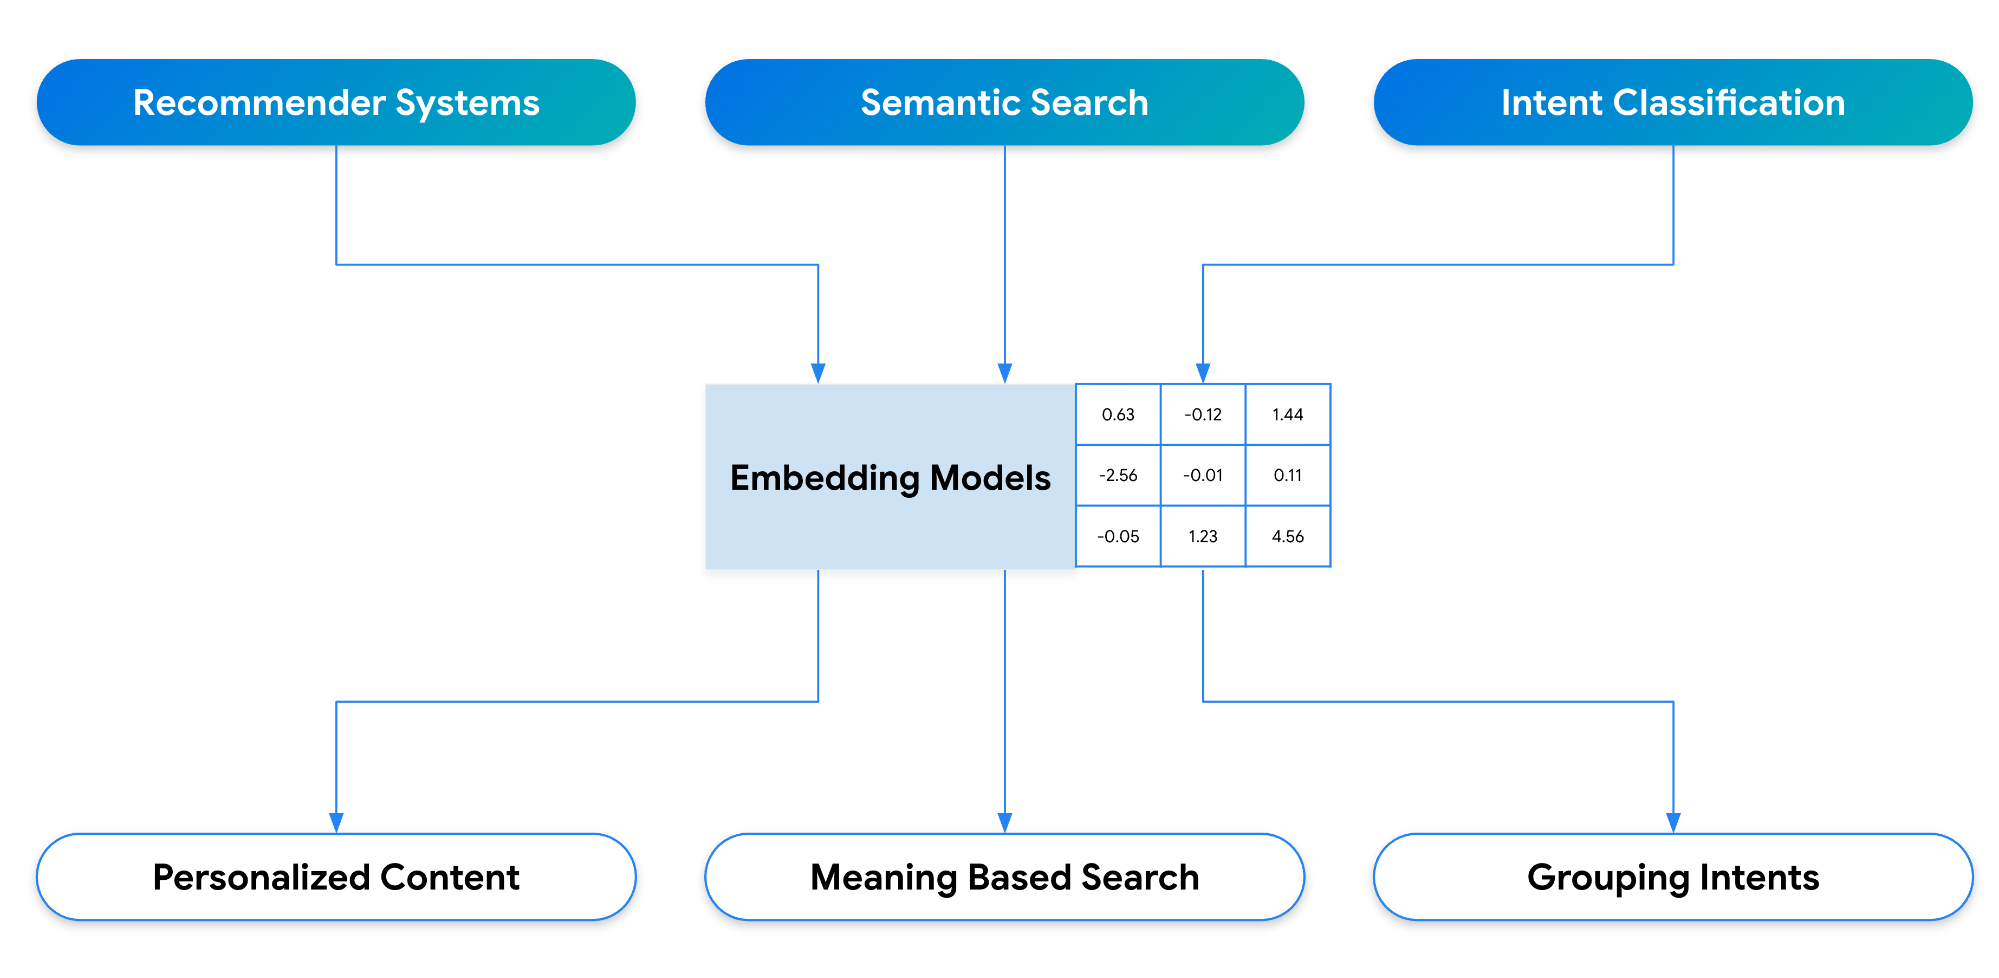
Embedding-Modelle sind entscheidende Komponenten moderner KI-Systeme, die unstrukturierte Daten wie Text, Bilder und Audio in dichte Vektorrepräsentationen übersetzen. Diese Vektoren treiben semantische Suche, Empfehlungssysteme und Content-Clustering an, indem sie mathematische Beziehungen zwischen Konzepten erfassen. Während das Prototyping mit kleinen Modellen handhabbar ist, führen die Skalierung dieser Pipelines zur Verarbeitung von Millionen von Anfragen zu erheblichen Engpässen beim Kapazitätsmanagement und bei der Kosteneffizienz.
Um diese Herausforderungen anzugehen, hat Google Cloud native TPU-Unterstützung zu vLLM hinzugefügt, dem beliebten Open-Source-Serving-Engine für große Sprachmodelle. Diese Integration ermöglicht echte Elastizität, sodass Engineering-Teams die Serving-Kapazität dynamisch skalieren können. Durch die Bereitstellung von TPU-Knoten neben anderen Beschleunigerinstanzen können Organisationen Traffic-Schwankungen effektiver verwalten. Wenn primäre TPU-Reservierungen vollständig ausgelastet sind, kann die Infrastruktur automatisch auf sekundäre GPU-Spot- oder On-Demand-Pools zurückgreifen, ohne den Inferenz-Traffic zu unterbrechen.
Die Implementierung basiert auf GKE-Primitiven wie Custom Compute Classes, um die automatische Skalierung von Knoten basierend auf strengen Prioritätsregeln zu automatisieren. Dies stellt sicher, dass Workloads über verschiedene Kapazitätstypen oder Beschleuniger hinweg skalieren, wenn die bevorzugte Ressource nicht verfügbar ist. Das Ziel ist es, hohe Verfügbarkeit und Leistung aufrechtzuerhalten und gleichzeitig die Kosten während Spitzenlastzeiten zu optimieren.
Wie es funktioniert
Das Serving von Embedding-Modellen der nächsten Generation erfordert die Verarbeitung ultra-langer Sequenzkontexte, die von über 4.000 Tokens für Text bis hin zu mehr als 15.000 Tokens für multimodale Eingaben reichen. Die Aufrechterhaltung einer strikten mathematischen Parität über verschiedene Hardware-Backends hinweg ist für Unternehmensanwendungen unerlässlich. Das Team konzentrierte sich auf die Optimierung der Qwen3-Embedding-Modellserie auf TPU-Hardware und adressierte drei spezifische Engineering-Herausforderungen.
Erstens legen die Matrix Execution Units der TPUs strenge Teilbarkeitsbeschränkungen fest, wenn Vokabular-Matrizen gesharded werden. Die Ingenieure implementierten eine hardware-sichere Strategie zum Auffüllen des Vokabulars, um eine exakte Tensor-Ausrichtung während der Ausführung sicherzustellen. Zweitens härteten sie den Materialisierungsprozess ab, indem sie Attribut-Promotion in die Unquantization-Pipeline einführten. Diese Änderung machte das Laden von Gewichten kompatibel mit dem TPU-Lazy-Loader von vLLM und eliminierte Initialisierungsfehler. Sie implementierten auch sharding-bewusstes Pre-Warming, um Kompilierungscaches vor der Inferenz zu sperren und so die Laufzeitlatenz zu reduzieren.
Drittens erforderte die Handhabung ultra-langer Kontexte eine neue Architektur, um Speichererschöpfung zu verhindern. Das Team entwickelte einen hybriden StepPool-Mechanismus, der Metadaten in einen gecachten Request-Zustand migriert. Dies stellt sicher, dass Pooling-Zustände korrekt über Schritte hinweg akkumuliert werden und Request-Preemptions überleben. Diese Optimierungen ermöglichen es dem System, Chunked-Prefill-Operationen effizient zu verarbeiten, ohne die Integrität des Zustands zu verlieren.
Wichtige Details
- Native TPU-Unterstützung in vLLM ermöglicht die dynamische Skalierung von Embedding-Workloads neben anderen Beschleunigertypen.
- Die Lösung zielt auf die Modelle Qwen3-Embedding-8B und Qwen3-VL-Embedding-8B für Text- und multimodale Aufgaben ab.
- Hardware-sicheres Vokabular-Auffüllen stellt die Tensor-Ausrichtung über TPU-Topologie-Meshes hinweg bei paralleler Ausführung sicher.
- Sharding-bewusstes Pre-Warming sperrt JAX/XLA-Kompilierungscaches, um Produktionspipelines zu stabilisieren und die Latenz zu reduzieren.
- Cosine-Similarity-Scores erreichten ≥0,999 für Text und ≥0,995 für multimodale Eingaben im Vergleich zu Referenz-Baselines.
- Das Serving von Qwen3-Embedding-8B auf TPU Ironwood erreichte 83.996 Gesamt-Tokens pro Sekunde und 5,13 Requests pro Sekunde.
Warum es wichtig ist
Für Software-Ingenieure, die KI-Produkte entwickeln, ist die Fähigkeit, die Embedding-Inferenz elastisch zu skalieren, entscheidend für die Einhaltung von Service Level Agreements während Traffic-Spitzen. Traditionelle statische Provisionierung führt oft zu Überprovisionierung oder Dienstverschlechterung. Durch die Integration von TPUs mit vLLM und GKE können Teams die Ressourcenallokation basierend auf Echtzeit-Nachfrage automatisieren. Dies reduziert den operativen Overhead und verbessert die Kosteneffizienz, ohne Einbußen bei der Leistung.
Präzision ist ein weiterer kritischer Faktor. In Unternehmensumgebungen können selbst geringfügige numerische Abweichungen zwischen Hardware-Backends die Suchqualität oder die Genauigkeit von Empfehlungen beeinträchtigen. Die rigorosen Paritätsbewertungen, die im Beitrag beschrieben werden, bestätigen, dass die TPU-basierte Inferenz nahezu perfekte Übereinstimmung mit Referenzimplementierungen beibehält. Dies gibt Entwicklern die Gewissheit, dass die Migration von Workloads auf TPUs die Qualität ihrer KI-Funktionen nicht kompromittiert.
Darüber hinaus eröffnet die Unterstützung für Long-Context-multimodale Eingaben neue Möglichkeiten für komplexe Retrieval-Aufgaben. Anwendungen, die Beziehungen zwischen großen Dokumenten und zugehörigen Bildern verstehen müssen, können diese Eingaben nun effizient verarbeiten. Die hybride StepPool-Architektur stellt sicher, dass diese schweren Workloads auch unter hoher Last stabil und reaktionsfähig bleiben.
Was Sie tun können
- Prüfen Sie die offiziellen AI-Hypercomputer Qwen3-Embedding-8B Recipes auf GitHub für Setup-Skripte und Deployment-Schritte.
- Testen Sie das bereitgestellte Python-Beispiel, um Qwen3-Embedding-8B auf Cloud TPU unter Verwendung des nativen Pooling-Runners von vLLM zu initialisieren.
- Bewerten Sie die Cosine-Similarity zwischen Ihren aktuellen Embedding-Ausgaben und TPU-generierten Vektoren, um die numerische Parität zu überprüfen.
- Konfigurieren Sie Custom Compute Classes in GKE, um Prioritätsregeln für die Autoskalierung über TPU- und GPU-Ressourcen hinweg zu definieren.
- Implementieren Sie sharding-bewusstes Pre-Warming in Ihrer Deployment-Pipeline, um Cold-Start-Latenzen für TPU-Workloads zu minimieren.
- Erkunden Sie die AI-Hypercomputer Public Repository für weitere Informationen.



