Reproduktion von OLMo 3 7B auf TPUs deckt versteckte Fehler im Datenlader auf
Eine Fallstudie von Google reproduziert das AI2-Modell OLMo 3 auf TPUs, erreicht vergleichbare Leistungsmetriken und deckt dabei kritische Fehler beim Data Sharding auf, die Memorization als Verbesserung tarnten.

Automatisch aus dem englischen Original übersetzt.
In einem Beitrag im Google Developers Blog im September 2026 beschrieben Ingenieure ihre erfolgreiche Reproduktion des Sprachmodells OLMo 3 7B vom Allen Institute for AI unter Verwendung von MaxText auf Google Cloud TPUs. Das Team konnte die ursprünglichen Trainingskurven und nachgelagerten Benchmarks exakt abbilden und bewies damit, dass ein PyTorch-basiertes GPU-Rezept getreu in einer JAX-basierten TPU-Umgebung ausgeführt werden kann.
Was passiert ist
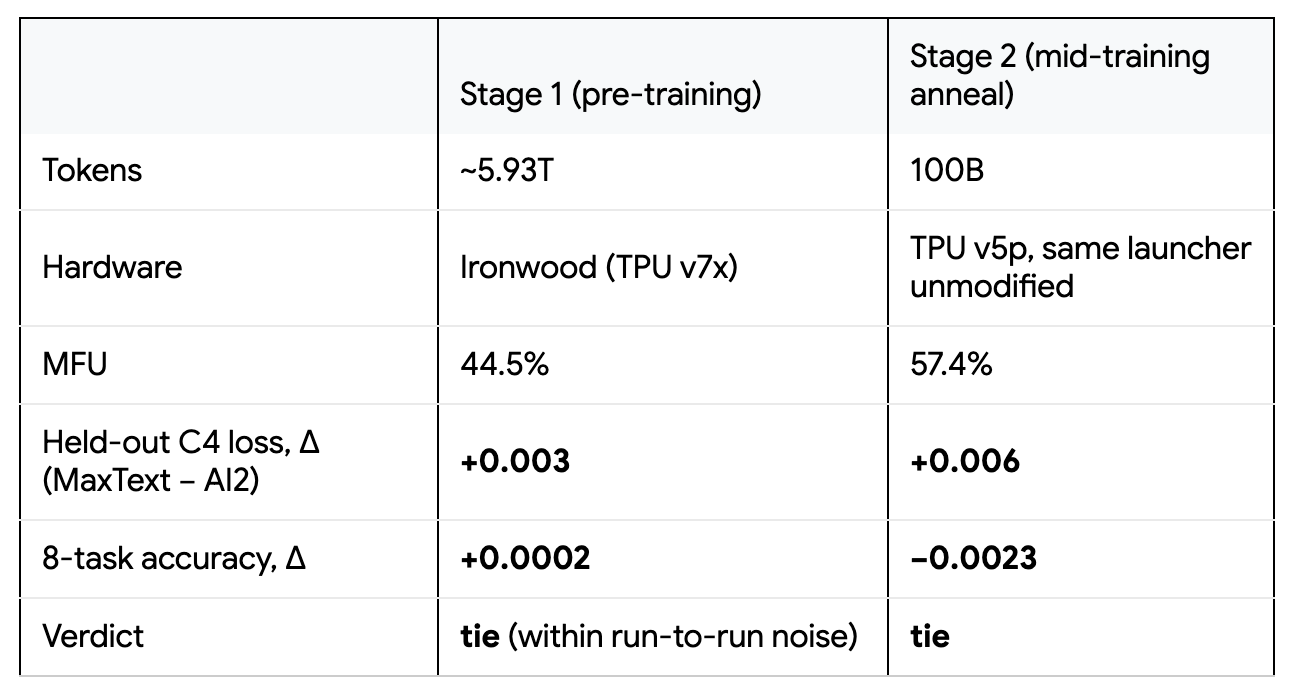
Das Engineering-Team hatte sich zum Ziel gesetzt, die Fähigkeiten von MaxText zu validieren, einem Hochleistungs-Framework für das Training großer Sprachmodelle auf TPUs. Sie wählten OLMo 3 aus, da es eines der wenigen Frontier-Klasse-Modelle mit vollständig offenen Gewichten, Daten und Trainingsrezepten ist. Diese Transparenz ermöglichte einen rigorosen Vergleich mit einem unabhängigen Referenzlauf, anstatt sich ausschließlich auf Loss-Kurven zu verlassen. Die Reproduktion umfasste das Pre-Training der Stufe 1 und das Mid-Training-Annealing der Stufe 2, wobei die Step-0-PyTorch-Checkpoints von AI2 in das Orbax-Format für JAX konvertiert wurden.
Die Ergebnisse zeigten, dass MaxText die von AI2 veröffentlichte Loss-Kurve über das gesamte Budget von 5,93 Billionen Tokens verfolgen konnte. Der Prozess war jedoch nicht frei von Komplikationen. In den späteren Phasen des Trainings schien der MaxText-Lauf die Referenz zu übertreffen, wobei der Trainings-Loss deutlich unter die Werte von AI2 fiel. Weitere Untersuchungen ergaben, dass dies keine echte Verbesserung der Modellqualität war, sondern ein Artefakt eines Fehlers im Datenlader. Das Team demonstrierte zudem die Widerstandsfähigkeit des Systems, indem es den Trainingsjob mitten im Betrieb neu dimensionierte, nachdem Hardwarekapazität verloren gegangen war, und zwischen den Trainingsphasen die TPU-Generation wechselte, ohne das Kernrezept zu ändern.
Wie es funktioniert
Um die Treue zur Vorlage sicherzustellen, portierte das Team die spezifischen architektonischen Entscheidungen von OLMo 3, einschließlich Reordered-Norm-Blöcken, QK-Norm und einem gemischten Muster aus Sliding-Window- und Global-Attention, in MaxText. Sie verifizierten die Konvertierung durch Logit-Paritätsprüfungen und stellten sicher, dass das konvertierte Modell innerhalb der erwarteten Rauschgrenze für verschiedene Frameworks mit der HuggingFace-Referenz übereinstimmte. Die Datenpipeline wurde mit Grain neu aufgebaut und implementierte Random-Access-Lesungen, globales Index-Shuffling sowie N-Gram-Wiederholungsfilterung, um das ursprüngliche Setup exakt abzubilden.
Die Leistungsoptimierung spielte eine entscheidende Rolle bei der Machbarkeit der Reproduktion. Das Team erreichte auf Ironwood-TPUs eine Model-Flops-Auslastung (MFU) von 44,5 %, indem es Kollektive auf den SparseCore auslagerte und Rematerialisierungsstrategien abstimmte. Sie untersuchten auch Co-Design-Möglichkeiten, wie das Umgestalten von Attention-Heads zur besseren Ausnutzung der Matrixmultiplikationseinheiten der TPU, was schnellere Trainingsgeschwindigkeiten ohne Qualitätsverluste brachte. Diese technischen Anpassungen ermöglichten es dem System, den Durchsatz auch dann aufrechtzuerhalten, wenn sich die Hardware-Ressourcen während des mehrwöchigen Trainingslaufs dynamisch änderten.
Wichtige Details
- Metrikabgleich: Das reproduzierte Modell entsprach den Holdout-Evaluationsmetriken von AI2, einschließlich C4-Loss und acht nachgelagerten Aufgaben, wobei die Genauigkeitsunterschiede nie ±0,005 überschritten.
- Entdeckung des Datenfehlers: Ein doppelter Sharding-Fehler im Grain-Datenlader führte zu wiederholten Dateninstanzen, was den Trainings-Loss künstlich um bis zu 0,25 Punkte senkte, ohne die Generalisierungsfähigkeit zu verbessern.
- Hardware-Resilienz: Der Trainingsjob konnte erfolgreich auf einem Cluster-Slice mit einem Viertel der ursprünglichen Größe nach einem Kapazitätsverlust fortgesetzt werden, wobei der Durchsatz pro Gerät innerhalb von 1 % gehalten wurde.
- Framework-Konvertierung: PyTorch-Gewichte wurden mit einer KL-Divergenz von etwa 1,5e-3 in Orbax konvertiert, was bestätigte, dass die Modelle bei der Initialisierung identisch waren.
- Vereinfachtes Rezept: Das Team verwendete einen einzelnen Cosine-Learning-Rate-Schedule anstelle des von AI2 genutzten Ansatzes mit zwei zusammengesetzten Kurven, erzielte aber dennoch vergleichbare Ergebnisse.
Warum das wichtig ist
Für Entwickler, die große KI-Systeme bauen, hebt diese Fallstudie die Gefahr hervor, sich ausschließlich auf den Trainings-Loss als Stellvertreter für die Modellqualität zu verlassen. Der Vorfall, bei dem MaxText aufgrund von Daten-Memorization scheinbar besser als die Referenz abschnitt, dient als deutliche Erinnerung daran, dass ein niedrigerer Loss nicht immer bessere Leistung bedeutet. Er unterstreicht die Notwendigkeit rigoroser Holdout-Evaluationen und unabhängiger Verifikationsschritte, um subtile Fehler in Datenpipelines zu erkennen, die sonst wochenlang unbemerkt bleiben könnten.
Darüber hinaus zeigt die erfolgreiche Reproduktion die Reife der JAX- und TPU-Ökosysteme für die Handhabung komplexer, nicht-standardisierter Transformer-Architekturen. Sie bietet einen Bauplan für Teams, die von PyTorch/GPU-Stacks auf JAX/TPU-Umgebungen migrieren möchten, und zeigt, dass eine getreue Reproduktion selbst bei signifikanten architektonischen Unterschieden möglich ist. Die Fähigkeit, Jobs neu zu dimensionieren und Hardware-Generationen mitten im Training zu wechseln, liefert zudem praktische Erkenntnisse für das Management von Kosten und Zuverlässigkeit bei lang laufenden Cloud-Trainingsjobs.
Was Sie tun können
- Implementieren Sie regelmäßige Holdout-Evaluationen parallel zum Monitoring des Trainings-Loss, um Memorization oder Daten-Leakage frühzeitig zu erkennen.
- Überprüfen Sie die Sharding-Logik des Datenladers mit Unit-Tests, die Multi-Worker-Umgebungen simulieren, um stille Datenverdopplungen zu verhindern.
- Verwenden Sie Logit-Paritätsprüfungen bei der Konvertierung von Modellen zwischen Frameworks, um die Konsistenz der Initialisierung vor Beginn des Trainings sicherzustellen.
- Gestalten Sie Trainings-Skripte so, dass sie dynamische Ressourcenänderungen handhaben können, um nahtlose Fortsetzungen auf unterschiedlichen Hardware-Slices bei Preemptions zu ermöglichen.
- Vergleichen Sie die Genauigkeit bei nachgelagerten Aufgaben an mehreren Checkpoints, nicht nur am Ende des Trainings, um ein konsistentes Wachstum der Fähigkeiten sicherzustellen.
- Prüfen Sie die Konfigurationen der Datenpipeline auf redundante Sharding-Operationen, insbesondere bei der Verwendung von Bibliotheken wie Grain, die Sharding möglicherweise intern behandeln.



