Optimización de la inferencia de embeddings en contextos largos en Cloud TPU con vLLM
Google detalla cómo el soporte nativo para TPU en vLLM permite un escalado elástico y una inferencia de embeddings de alta precisión para los modelos Qwen3.

Traducido automáticamente del original en inglés.
En una publicación en el Google Developers Blog en agosto de 2026, los ingenieros describieron cómo integraron el soporte nativo para Tensor Processing Unit (TPU) en vLLM. Esta actualización permite a los equipos de infraestructura de IA ejecutar modelos de embeddings a gran escala con precisión de nivel empresarial, aprovechando al mismo tiempo las capacidades de cómputo elástico de Google Kubernetes Engine (GKE).
Qué ocurrió
Los modelos de embeddings son componentes críticos en los sistemas de IA modernos, ya que traducen datos no estructurados como texto, imágenes y audio en representaciones vectoriales densas. Estos vectores impulsan la búsqueda semántica, los motores de recomendación y la agrupación de contenido al capturar relaciones matemáticas entre conceptos. Si bien es manejable prototipar con modelos pequeños, escalar estos flujos de trabajo para manejar millones de consultas introduce cuellos de botella significativos en la gestión de capacidad y la eficiencia de costos.
Para abordar estos desafíos, Google Cloud añadió soporte nativo para TPU a vLLM, el popular motor de servicio de código abierto para grandes modelos de lenguaje. Esta integración habilita una verdadera elasticidad, permitiendo a los equipos de ingeniería escalar dinámicamente la capacidad de servicio. Al aprovisionar nodos TPU junto con otras instancias de aceleradores, las organizaciones pueden gestionar mejor las fluctuaciones del tráfico. Si las reservas principales de TPU están completamente utilizadas, la infraestructura puede cambiar automáticamente a pools secundarios de GPU spot o bajo demanda sin interrumpir el tráfico de inferencia.
La implementación se basa en primitivas de GKE como Custom Compute Classes para automatizar el autoescalado de nodos según reglas estrictas de prioridad. Esto garantiza que las cargas de trabajo escalen horizontalmente entre diferentes tipos de capacidad o aceleradores si el recurso preferido no está disponible. El objetivo es mantener una alta disponibilidad y rendimiento mientras se optimizan los costos durante períodos de demanda máxima.
Cómo funciona
Servir modelos de embeddings de próxima generación requiere procesar contextos de secuencia ultra largos, que van desde más de 4.000 tokens para texto hasta más de 15.000 tokens para entradas multimodales. Mantener una paridad matemática estricta entre diferentes backends de hardware es esencial para aplicaciones empresariales. El equipo se centró en optimizar la serie de modelos Qwen3 Embedding en hardware TPU, abordando tres desafíos de ingeniería específicos.
En primer lugar, las Unidades de Ejecución Matricial de TPU imponen restricciones estrictas de divisibilidad al fragmentar matrices de vocabulario. Los ingenieros implementaron una estrategia de relleno de vocabulario segura para el hardware para garantizar la alineación exacta de tensores durante la ejecución. En segundo lugar, endurecieron el proceso de materialización introduciendo la promoción de atributos en el pipeline de descuantización. Este cambio hizo compatible la carga de pesos con el cargador perezoso (lazy-loader) de TPU de vLLM, eliminando fallos de inicialización. También implementaron un precalentamiento consciente del sharding para bloquear las cachés de compilación antes de la inferencia, reduciendo la latencia de ejecución.
En tercer lugar, el manejo de contextos ultra largos requería una nueva arquitectura para evitar el agotamiento de memoria. El equipo diseñó un mecanismo híbrido StepPool que migra los metadatos a un estado de solicitud cacheado. Esto asegura que los estados de pooling se acumulen correctamente a través de los pasos y sobrevivan a las preemptions de solicitudes. Estas optimizaciones permiten al sistema manejar operaciones de prefill por bloques de manera eficiente sin perder la integridad del estado.
Detalles clave
- El soporte nativo para TPU en vLLM permite el escalado dinámico de cargas de trabajo de embeddings junto con otros tipos de aceleradores.
- La solución apunta a los modelos Qwen3-Embedding-8B y Qwen3-VL-Embedding-8B para tareas de texto y multimodales.
- El relleno de vocabulario seguro para el hardware garantiza la alineación de tensores a través de las mallas de topología TPU durante la ejecución paralela.
- El precalentamiento consciente del sharding bloquea las cachés de compilación JAX/XLA para estabilizar los pipelines de producción y reducir la latencia.
- Las puntuaciones de similitud coseno alcanzaron ≥0.999 para texto y ≥0.995 para entradas multimodales en comparación con las líneas base de referencia.
- Servir Qwen3-Embedding-8B en TPU Ironwood logró 83.996 tokens totales por segundo y 5.13 solicitudes por segundo.
Por qué importa
Para los ingenieros de software que construyen productos de IA, la capacidad de escalar la inferencia de embeddings de manera elástica es crucial para mantener los acuerdos de nivel de servicio (SLA) durante picos de tráfico. El aprovisionamiento estático tradicional a menudo conduce a sobreaprovisionamiento o degradación del servicio. Al integrar TPUs con vLLM y GKE, los equipos pueden automatizar la asignación de recursos basándose en la demanda en tiempo real. Esto reduce la sobrecarga operativa y mejora la eficiencia de costos sin sacrificar el rendimiento.
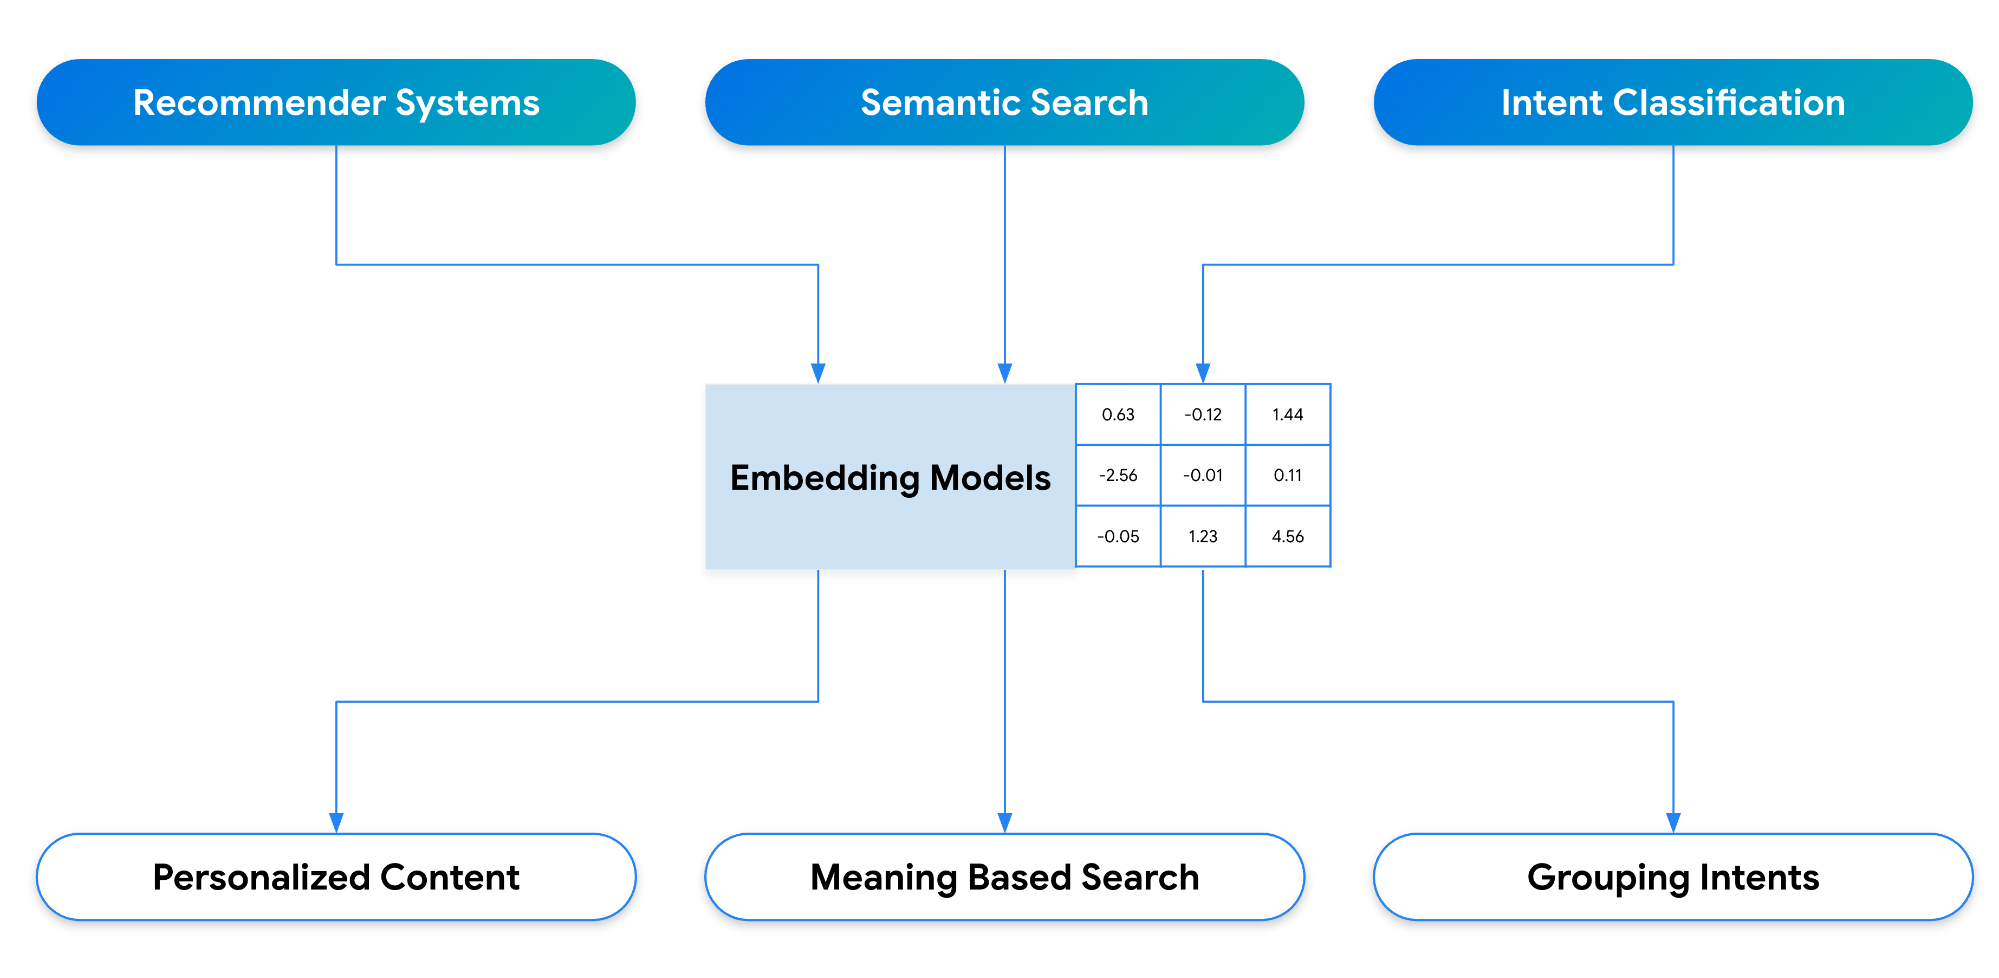
La precisión es otro factor crítico. En entornos empresariales, incluso discrepancias numéricas menores entre backends de hardware pueden degradar la calidad de búsqueda o la precisión de las recomendaciones. Las rigurosas evaluaciones de paridad descritas en la publicación confirman que la inferencia basada en TPU mantiene una alineación casi perfecta con las implementaciones de referencia. Esto da a los desarrolladores confianza en que migrar cargas de trabajo a TPUs no comprometerá la calidad de sus funciones de IA.
Además, el soporte para entradas multimodales de contexto largo abre nuevas posibilidades para tareas complejas de recuperación. Las aplicaciones que necesitan entender relaciones entre documentos grandes e imágenes asociadas ahora pueden procesar estas entradas eficientemente. La arquitectura híbrida StepPool asegura que estas cargas de trabajo pesadas permanezcan estables y receptivas, incluso bajo alta carga.
Qué puedes hacer
- Revisa las recetas oficiales AI-Hypercomputer Qwen3-Embedding-8B en GitHub para obtener scripts de configuración y pasos de despliegue.
- Prueba el ejemplo en Python proporcionado para inicializar Qwen3-Embedding-8B en Cloud TPU usando el runner de pooling nativo de vLLM.
- Evalúa la similitud coseno entre tus salidas actuales de embeddings y los vectores generados por TPU para verificar la paridad numérica.
- Configura Custom Compute Classes en GKE para definir reglas de prioridad para el autoescalado entre recursos TPU y GPU.
- Implementa el precalentamiento consciente del sharding en tu pipeline de despliegue para minimizar las latencias de arranque en frío para cargas de trabajo TPU.
- Explora el Repositorio Público AI-Hypercomputer para recetas de embeddings multimodales.



