Kubernetes stellt Gateway-API-Erweiterung für das Routing von LLM-Inferenz vor
Das Kubernetes-Projekt hat die Gateway API Inference Extension veröffentlicht, um das Routing für generative KI-Workloads zu standardisieren, die Latenz zu reduzieren und die GPU-Auslastung zu verbessern.

Automatisch aus dem englischen Original übersetzt.
In einem Beitrag im Kubernetes Blog vom Juni 2025 stellten Mitwirkende von Solo.io, Google und Bytedance die Gateway API Inference Extension vor. Diese neue standardisierte Erweiterung adressiert die spezifischen Traffic-Routing-Herausforderungen bei selbst gehosteten großen Sprachmodellen (LLMs), indem sie inferenzbewusste Funktionen zum bestehenden Gateway-API-Framework hinzufügt.
Was passiert ist
Moderne generative KI-Dienste unterscheiden sich erheblich von traditionellen Webanwendungen. Während Standard-HTTP-Anfragen oft kurzlebig und zustandslos sind, sind LLM-Inferenz-Sitzungen langlebig, ressourcenintensiv und teilweise zustandsbehaftet. Ein einzelner, GPU-gestützter Modellserver kann aktive Inferenz-Sitzungen aufrechterhalten und Token-Caches im Speicher halten. Traditionelle Load Balancer, die typischerweise auf einfacher HTTP-Pfadzuordnung oder Round-Robin-Verteilung basieren, verfügen nicht über die spezialisierte Logik, die erforderlich ist, um diese komplexen Workloads effektiv zu handhaben. Sie berücksichtigen weder die Modellidentität noch die Kritikalität einer Anfrage, wie etwa die Unterscheidung zwischen einer interaktiven Chat-Sitzung und einem Hintergrund-Batch-Job.
Um dies zu lösen, entwickelte die Community die Gateway API Inference Extension. Dieses Projekt baut auf dem vertrauten Gateway-API-Modell auf und ermöglicht es Plattformingenieuren, ein Standard-Gateway in ein "Inference Gateway" umzuwandeln. Das Ziel ist es, einen standardisierten Ansatz für das Routing von Inferenz-Workloads im gesamten Ökosystem bereitzustellen und sich von ad-hoc, individuellen Lösungen zu entfernen. Durch die Ermöglichung modellbewussten Routings und die Unterstützung von per-Anfrage-Kritikalitäten zielt die Erweiterung darauf ab, die Latenz zu reduzieren und die Auslastung von Beschleunigern wie GPUs zu optimieren.
Wie es funktioniert
Die Architektur führt zwei neue Custom Resource Definitions (CRDs) ein, die die Zuständigkeiten zwischen Plattformbetreibern und AI/ML-Verantwortlichen trennen. Die erste, InferencePool, definiert eine Gruppe von Pods, die Modellservers auf gemeinsamen Rechenressourcen ausführen. Plattformadministratoren nutzen diese Ressource, um Deployment-, Skalierungs- und Balancing-Richtlinien zu konfigurieren und so eine konsistente Ressourcennutzung im gesamten Cluster sicherzustellen. Sie funktioniert ähnlich wie ein Kubernetes Service, ist jedoch speziell auf Modellbereitstellungsprotokolle ausgerichtet.
Die zweite Ressource, InferenceModel, wird von AI/ML-Teams verwaltet. Sie bildet einen öffentlichen Endpunktnamen, wie z. B. "gpt-4-chat", auf ein spezifisches Modell innerhalb eines InferencePool ab. Dies ermöglicht es Workload-Eigentümern, festzulegen, welche Modelle bereitgestellt werden, einschließlich Feinabstimmungs-Varianten, sowie Richtlinien für Traffic-Splitting oder Priorisierung zu definieren. Diese Trennung stellt sicher, dass Plattformteams die Infrastruktur verwalten, während Anwendungsteams die Modellexposition steuern.
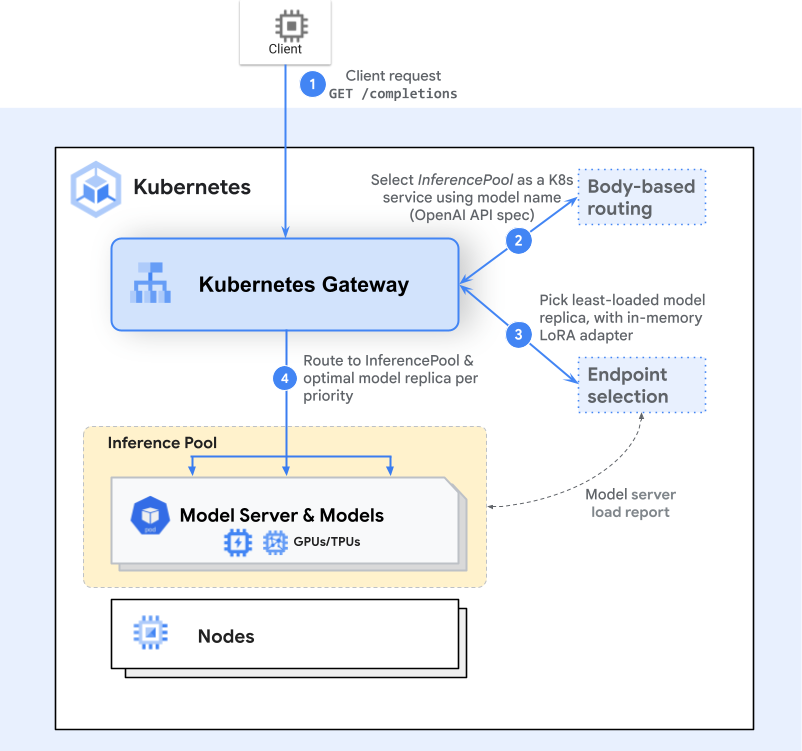
Wenn ein Client eine Anfrage sendet, prüft das Gateway die HTTPRoute, um den Ziel-InferencePool zu identifizieren. Anstatt den Traffic an einen beliebigen verfügbaren Pod weiterzuleiten, konsultiert das Gateway eine Endpoint Selection Extension. Diese Komponente analysiert Live-Metriken von den Pods, wie Warteschlangenlängen, Speichernutzung und geladene Adapter. Anschließend wählt sie den optimalen Pod basierend auf Echtzeitbedingungen aus, um sicherzustellen, dass die Anfrage mit der niedrigstmöglichen Latenz oder höchsten Effizienz bearbeitet wird. Dieser Prozess bleibt für den Client transparent und erscheint als eine einzelne Standardanfrage.
Wichtige Details
- Zwei neue CRDs:
InferencePoolfür die Ressourcenverwaltung auf Plattformebene undInferenceModelfür benutzerseitige Modellendpunkte. - Endpoint Selection Extension: Ersetzt einfaches Round-Robin durch metrikbewusstes Routing, das Warteschlangentiefe und Speicherzustand berücksichtigt.
- Benchmark-Umgebung: Tests verwendeten vLLM Version 1 auf H100 (80 GB) GPU-Pods mit 10 Llama2-Replikas.
- Latenzverbesserungen: Die Erweiterung zeigte bei hoher Last (500+ QPS) eine signifikant niedrigere p90-Latenz im Vergleich zu Standard-Kubernetes-Services.
- Durchsatzparität: Der Durchsatz blieb im getesteten Bereich von 100 bis 1000 Queries pro Sekunde vergleichbar mit Standard-Services.
- Erweiterbares Design: Das Framework unterstützt zusätzliche Erweiterungen für neue Routing-Strategien oder spezielle Hardwareanforderungen.
Warum es wichtig ist
Für Engineering-Teams, die KI-Produkte entwickeln, bietet diese Erweiterung einen Weg zu zuverlässigerem und effizienterem Self-Hosting von Modellen. Durch das Routing von Anfragen basierend auf Echtzeit-Pod-Metriken statt statischer Regeln können Organisationen Hotspots vermeiden, die auftreten, wenn der GPU-Speicher die Sättigung erreicht. Dies führt zu vorhersagbareren Tail-Latenzen, was für die Aufrechterhaltung einer reibungslosen Benutzererfahrung in interaktiven Anwendungen entscheidend ist. Die Fähigkeit, Traffic basierend auf Kritikalität zu priorisieren, stellt zudem sicher, dass hochwertige Interaktionen nicht durch Batch-Prozesse mit niedrigerer Priorität blockiert werden.
Aus operativer Sicht reduziert die Standardisierung den Wartungsaufwand für individuelles Routing-Logik. Plattformteams können konsistente Richtlinien über verschiedene Modelle und Teams hinweg unter Verwendung nativer Kubernetes-Tools durchsetzen. Da das Projekt auf die allgemeine Verfügbarkeit zusteuert, werden Funktionen wie prefix-cache-bewusstes Load Balancing und Unterstützung für heterogene Beschleuniger den Nutzen weiter steigern. Diese Ausrichtung auf Kubernetes-native Tools vereinfacht die Integration von GenAI-Diensten in bestehende Infrastrukturen.
Was Sie tun können
- Prüfen Sie die offizielle Projektdokumentation, um die API-Spezifikationen und Installationsanforderungen zu verstehen.
- Stellen Sie ein Test-Inference-Gateway in einer Nicht-Produktionsumgebung bereit, um die Endpoint Selection Extension zu evaluieren.
- Mappen Sie bestehende Modell-Services auf
InferencePool- undInferenceModel-Ressourcen, um den Migrationspfad zu testen. - Überwachen Sie p90-Latenz- und GPU-Auslastungsmetriken während des Lasttests, um Leistungsverbesserungen zu quantifizieren.
- Tragen Sie zum Projekt bei, indem Sie neue Erweiterungen für spezifische Routing-Strategien oder Hardware-Typen entwickeln.
- Geben Sie Feedback zu Roadmap-Elementen, wie LoRA-Adapter-Pipelines und Unterstützung für disaggregiertes Serving.



