Tối ưu hóa suy luận embedding ngữ cảnh dài trên Cloud TPU với vLLM
Google mô tả cách hỗ trợ TPU gốc trong vLLM cho phép mở rộng linh hoạt và suy luận embedding độ chính xác cao cho các mô hình Qwen3.

Được dịch tự động từ bản gốc tiếng Anh.
Trong một bài đăng trên Google Developers Blog vào tháng 8 năm 2026, các kỹ sư đã mô tả cách họ tích hợp hỗ trợ Tensor Processing Unit (TPU) gốc vào vLLM. Bản cập nhật này cho phép các nhóm hạ tầng AI chạy các mô hình embedding quy mô lớn với độ chính xác cấp doanh nghiệp, đồng thời tận dụng khả năng tính toán linh hoạt của Google Kubernetes Engine (GKE).
Chuyện gì đã xảy ra
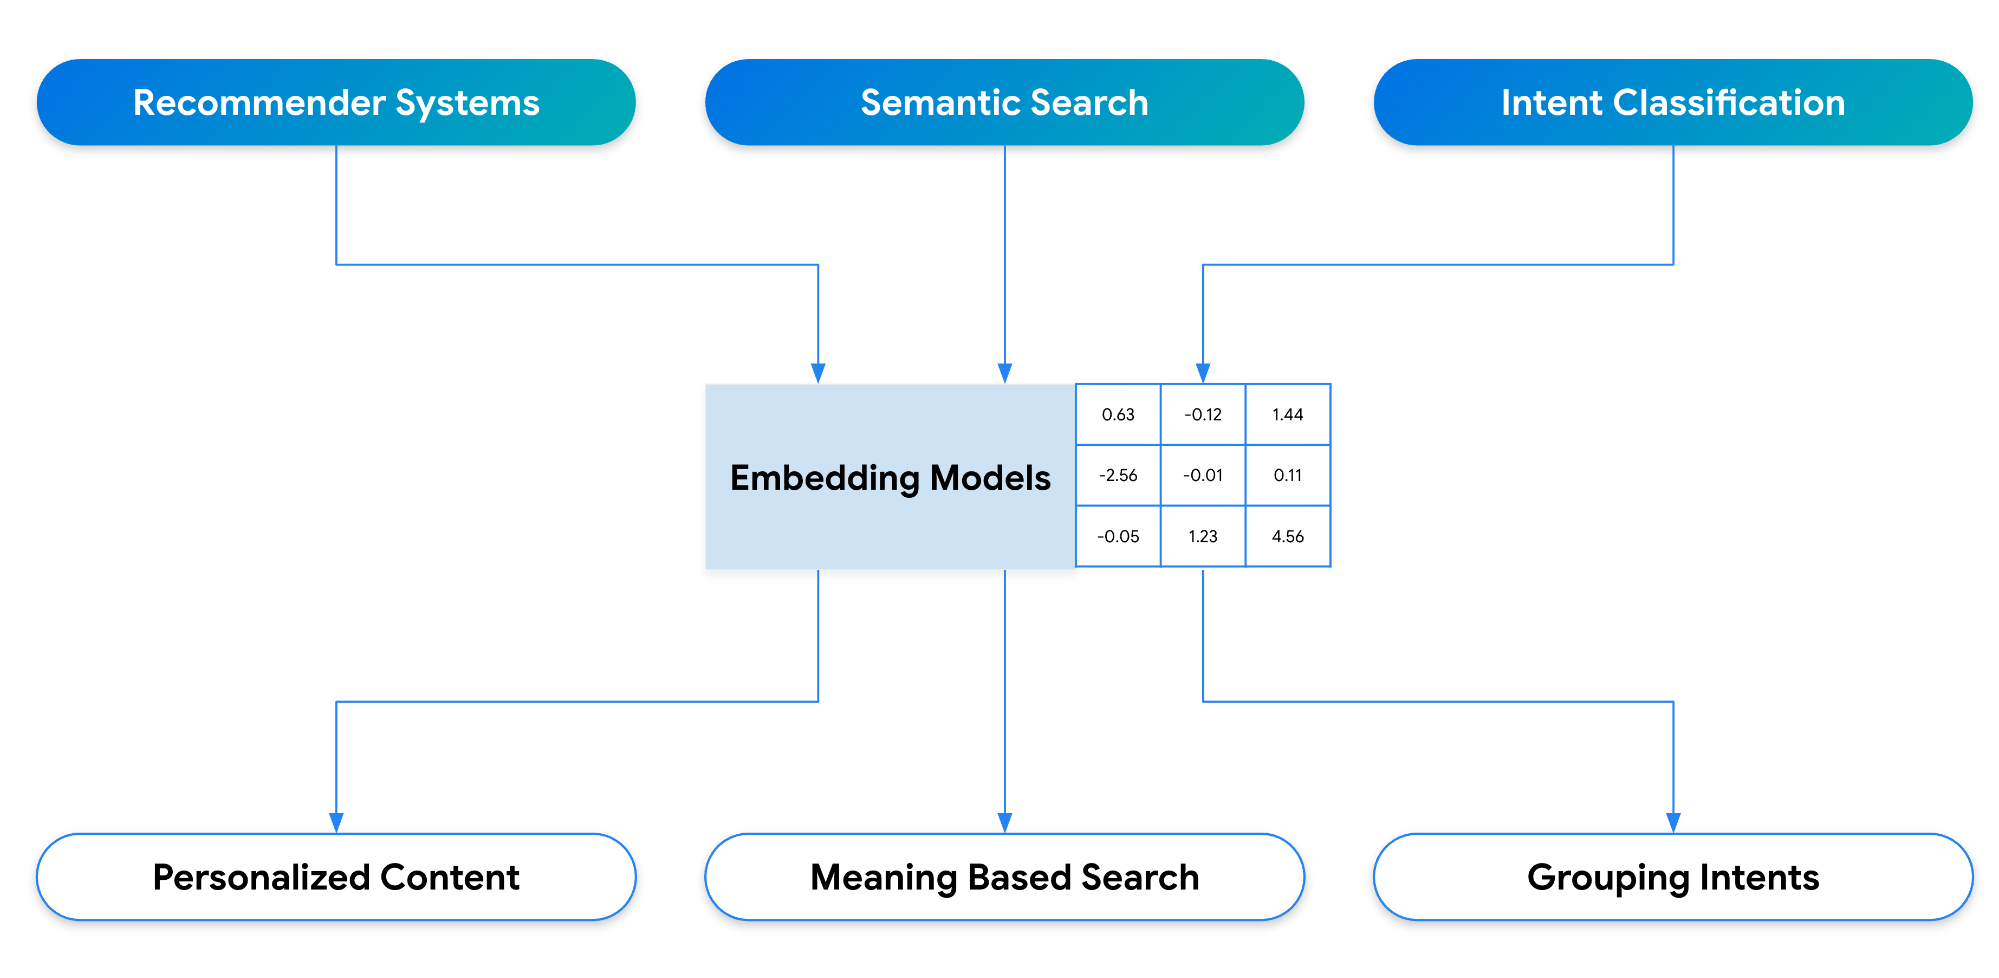
Các mô hình embedding là thành phần quan trọng trong hệ thống AI hiện đại, chuyển đổi dữ liệu phi cấu trúc như văn bản, hình ảnh và âm thanh thành các biểu diễn vector dày đặc. Những vector này cung cấp năng lượng cho tìm kiếm ngữ nghĩa, công cụ gợi ý và phân cụm nội dung bằng cách nắm bắt các mối quan hệ toán học giữa các khái niệm. Trong khi việc thử nghiệm nguyên mẫu với các mô hình nhỏ là dễ quản lý, thì việc mở rộng các pipeline này để xử lý hàng triệu truy vấn gây ra những nút thắt đáng kể về quản lý năng lực và hiệu quả chi phí.
Để giải quyết những thách thức này, Google Cloud đã thêm hỗ trợ TPU gốc vào vLLM, engine phục vụ mã nguồn mở phổ biến cho các mô hình ngôn ngữ lớn. Tích hợp này cho phép tính đàn hồi thực sự, giúp các nhóm kỹ thuật mở rộng năng lực phục vụ một cách động. Bằng cách cung cấp các node TPU cùng với các instance bộ tăng tốc khác, các tổ chức có thể quản lý biến động lưu lượng hiệu quả hơn. Nếu các đặt chỗ TPU chính được sử dụng hết, hạ tầng có thể tự động chuyển sang các pool GPU spot hoặc on-demand thứ cấp mà không làm gián đoạn lưu lượng suy luận.
Việc triển khai dựa trên các primitive của GKE như Custom Compute Classes để tự động hóa autoscaling node dựa trên các quy tắc ưu tiên nghiêm ngặt. Điều này đảm bảo rằng khối lượng công việc sẽ mở rộng qua các loại năng lực hoặc bộ tăng tốc khác nhau nếu tài nguyên ưu tiên không khả dụng. Mục tiêu là duy trì tính sẵn sàng cao và hiệu suất trong khi tối ưu hóa chi phí trong các giai đoạn nhu cầu đỉnh điểm.
Cách thức hoạt động
Phục vụ các mô hình embedding thế hệ tiếp theo đòi hỏi xử lý các ngữ cảnh chuỗi cực dài, từ hơn 4.000 token đối với văn bản đến hơn 15.000 token đối với đầu vào đa phương thức. Duy trì sự tương đương toán học nghiêm ngặt giữa các backend phần cứng khác nhau là điều thiết yếu cho các ứng dụng doanh nghiệp. Nhóm tập trung vào việc tối ưu hóa loạt mô hình Qwen3 Embedding trên phần cứng TPU, giải quyết ba thách thức kỹ thuật cụ thể.
Thứ nhất, các Đơn vị Thực thi Ma trận TPU áp đặt các ràng buộc chia hết nghiêm ngặt khi sharding các ma trận từ vựng. Các kỹ sư đã triển khai chiến lược padding từ vựng an toàn cho phần cứng để đảm bảo căn chỉnh tensor chính xác trong quá trình thực thi. Thứ hai, họ củng cố quá trình vật chất hóa bằng cách giới thiệu thuộc tính promotion trong pipeline unquantization. Thay đổi này làm cho việc tải trọng số tương thích với lazy-loader TPU của vLLM, loại bỏ các lỗi khởi tạo. Họ cũng triển khai pre-warming nhận biết sharding để khóa các cache biên dịch trước khi suy luận, giảm độ trễ runtime.
Thứ ba, việc xử lý các ngữ cảnh cực dài yêu cầu một kiến trúc mới để ngăn chặn cạn kiệt bộ nhớ. Nhóm đã thiết kế cơ chế StepPool lai di chuyển metadata sang trạng thái request được cache. Điều này đảm bảo rằng các trạng thái pooling tích lũy đúng cách qua các bước và sống sót sau các lần preempt request. Những tối ưu hóa này cho phép hệ thống xử lý các thao tác chunked prefill hiệu quả mà không mất đi tính toàn vẹn của trạng thái.
Chi tiết chính
- Hỗ trợ TPU gốc trong vLLM cho phép mở rộng động các khối lượng công việc embedding cùng với các loại bộ tăng tốc khác.
- Giải pháp nhắm mục tiêu vào các mô hình Qwen3-Embedding-8B và Qwen3-VL-Embedding-8B cho các tác vụ văn bản và đa phương thức.
- Padding từ vựng an toàn cho phần cứng đảm bảo căn chỉnh tensor qua các mesh topo TPU trong quá trình thực thi song song.
- Pre-warming nhận biết sharding khóa các cache biên dịch JAX/XLA để ổn định các pipeline sản xuất và giảm độ trễ.
- Điểm tương đồng cosine đạt ≥0,999 đối với văn bản và ≥0,995 đối với đầu vào đa phương thức so với các baseline tham chiếu.
- Phục vụ Qwen3-Embedding-8B trên TPU Ironwood đạt 83.996 tổng token mỗi giây và 5,13 request mỗi giây.
Tại sao điều này quan trọng
Đối với các kỹ sư phần mềm xây dựng sản phẩm AI, khả năng mở rộng suy luận embedding một cách đàn hồi là rất quan trọng để duy trì các thỏa thuận mức dịch vụ (SLA) trong các đợt tăng đột biến lưu lượng. Việc cung cấp tĩnh truyền thống thường dẫn đến over-provisioning hoặc suy giảm dịch vụ. Bằng cách tích hợp TPUs với vLLM và GKE, các nhóm có thể tự động hóa phân bổ tài nguyên dựa trên nhu cầu thời gian thực. Điều này giảm bớt gánh nặng vận hành và cải thiện hiệu quả chi phí mà không hy sinh hiệu suất.
Độ chính xác là một yếu tố quan trọng khác. Trong môi trường doanh nghiệp, ngay cả những sai lệch số học nhỏ giữa các backend phần cứng cũng có thể làm giảm chất lượng tìm kiếm hoặc độ chính xác của gợi ý. Các đánh giá tương đương nghiêm ngặt được mô tả trong bài đăng xác nhận rằng suy luận dựa trên TPU duy trì sự căn chỉnh gần như hoàn hảo với các triển khai tham chiếu. Điều này mang lại cho các nhà phát triển sự tự tin rằng việc di chuyển khối lượng công việc sang TPUs sẽ không làm giảm chất lượng các tính năng AI của họ.
Hơn nữa, hỗ trợ cho các đầu vào đa phương thức ngữ cảnh dài mở ra những khả năng mới cho các tác vụ truy xuất phức tạp. Các ứng dụng cần hiểu mối quan hệ giữa các tài liệu lớn và hình ảnh liên kết giờ đây có thể xử lý các đầu vào này một cách hiệu quả. Kiến trúc StepPool lai đảm bảo rằng các khối lượng công việc nặng nề này vẫn ổn định và phản hồi nhanh, ngay cả dưới tải cao.
Bạn có thể làm gì
- Xem xét các Recipe Qwen3-Embedding-8B chính thức của AI-Hypercomputer trên GitHub để lấy các script thiết lập và bước triển khai.
- Kiểm tra ví dụ Python được cung cấp để khởi tạo Qwen3-Embedding-8B trên Cloud TPU sử dụng runner pooling gốc của vLLM.
- Đánh giá tương đồng cosine giữa các đầu ra embedding hiện tại của bạn và các vector do TPU tạo ra để xác minh sự tương đương số học.
- Cấu hình Custom Compute Classes trong GKE để xác định các quy tắc ưu tiên cho autoscaling qua các tài nguyên TPU và GPU.
- Triển khai pre-warming nhận biết sharding trong pipeline triển khai của bạn để giảm thiểu độ trễ cold-start cho các khối lượng công việc TPU.
- Khám phá AI-Hypercomputer Public để tìm hiểu thêm.



