Cloud TPUでのvLLMを用いた長文コンテキスト埋め込み推論の最適化
Googleは、vLLMにおけるネイティブTPUサポートがQwen3モデル向けに弾力的なスケーリングと高精度な埋め込み推論をどのように可能にするかについて詳述しています。

英語の原文から自動翻訳されました。
2026年8月のGoogle Developers Blogの投稿で、エンジニアたちはTensor Processing Unit(TPU)のネイティブサポートをvLLMに統合する方法について説明しました。このアップデートにより、AIインフラチームはGoogle Kubernetes Engine(GKE)の弾力的なコンピューティング機能を活用しつつ、エンタープライズグレードの精度で大規模な埋め込みモデルを実行できるようになります。
何が起きたのか
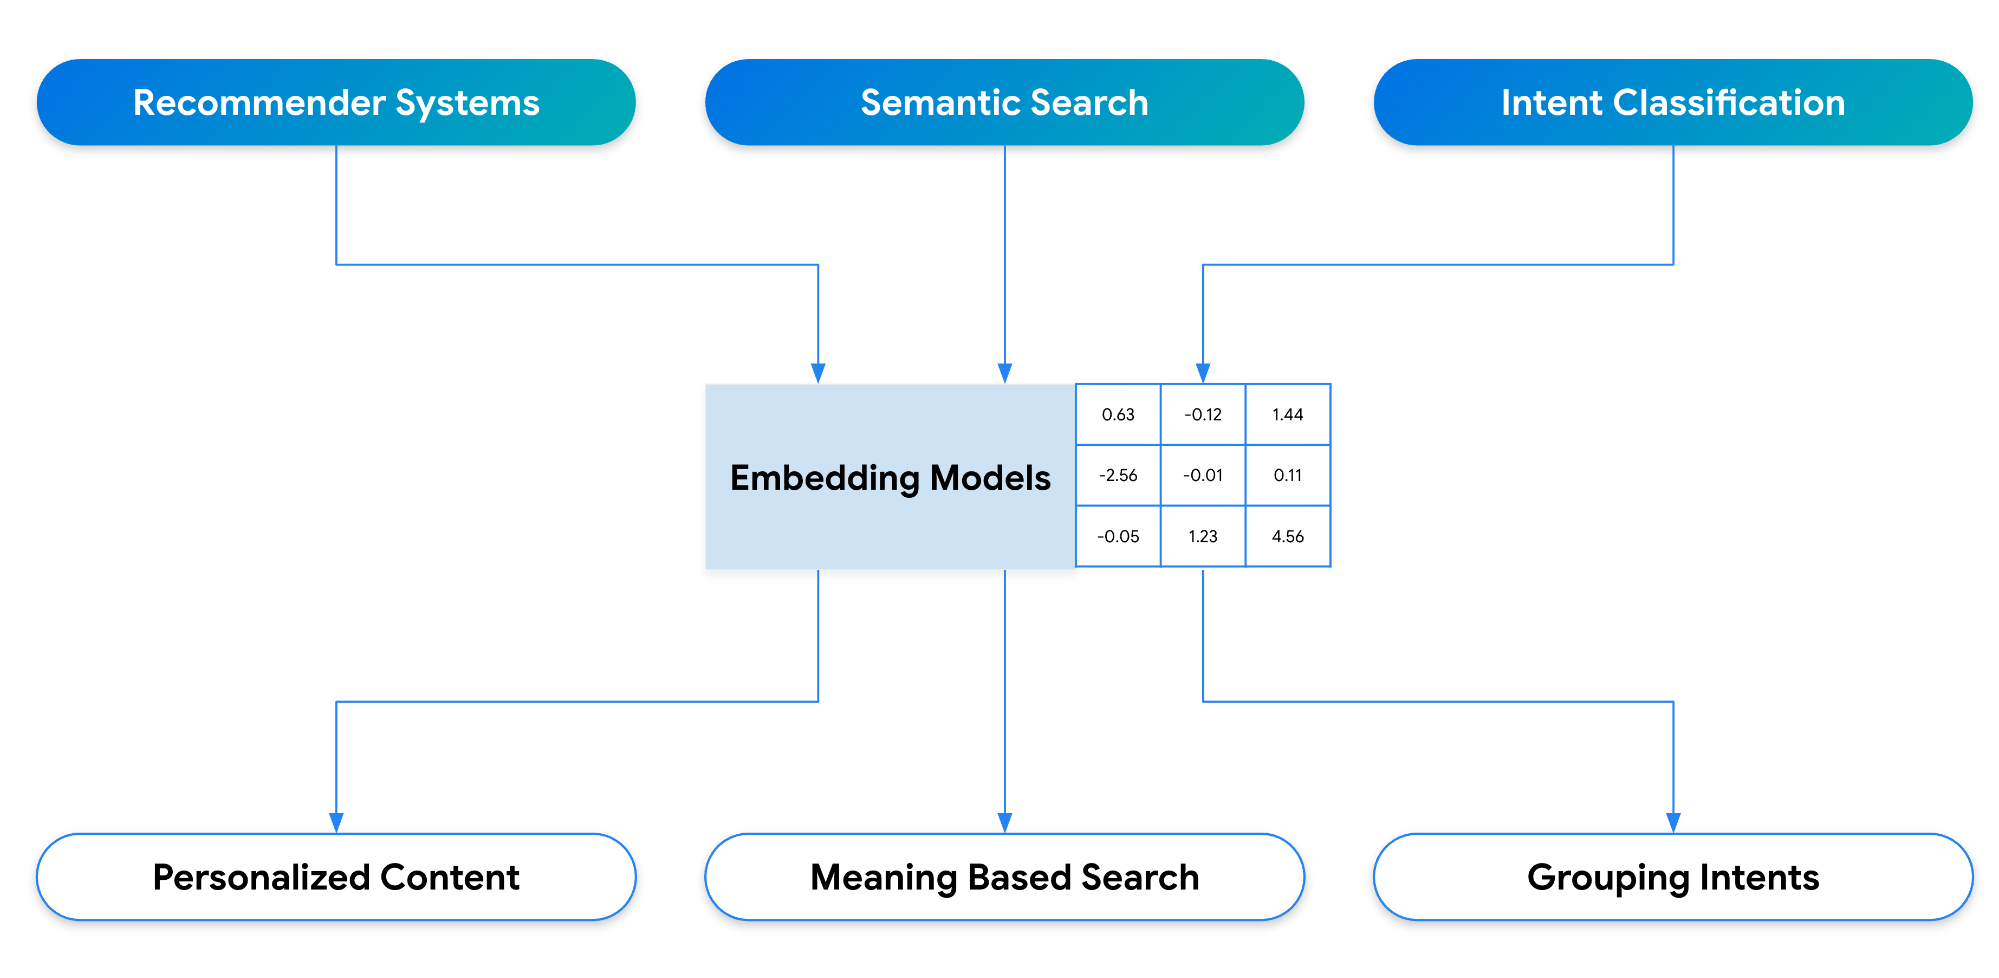
埋め込みモデルは、テキスト、画像、音声などの非構造化データを密なベクトル表現に変換する、現代のAIシステムにおける重要な構成要素です。これらのベクトルは概念間の数学的な関係を捉えることで、セマンティック検索、レコメンデーションエンジン、コンテンツクラスタリングを支えています。小規模なモデルによるプロトタイピングは管理しやすいものの、数百万件のクエリを処理するためにパイプラインをスケールすると、容量管理とコスト効率において重大なボトルネックが発生します。
これらの課題に対処するため、Google Cloudは大規模言語モデル向けの人気オープンソースサービングエンジンであるvLLMに、ネイティブTPUサポートを追加しました。この統合により真の弾力性が実現し、エンジニアリングチームはサービング容量を動的にスケールできるようになります。TPUノードを他のアクセラレーターインスタンスとともにプロビジョニングすることで、組織はトラフィックの変動をより効果的に管理できます。プライマリTPU予約が完全に使用されている場合、インフラストラクチャは推論トラフィックを中断することなく、自動的にセカンダリのGPUスポットまたはオンデマンドプールへフォールバックできます。
この実装では、厳格な優先順位ルールに基づいてノードの自動スケーリングを自動化するために、Custom Compute ClassesなどのGKEプリミティブを利用しています。これにより、優先リソースが利用できない場合でも、異なる容量タイプやアクセラレーター間でワークロードがスケールアップすることが保証されます。目標は、ピーク需要期間中にコストを最適化しながら、高い可用性とパフォーマンスを維持することです。
仕組み
次世代の埋め込みモデルを提供するには、テキストで4,000トークン超、マルチモーダル入力では15,000トークン超といった、極めて長いシーケンスコンテキストを処理する必要があります。エンタープライズアプリケーションにとって、異なるハードウェアバックエンド間での厳密な数学的パリティの維持は不可欠です。チームはTPUハードウェア上のQwen3 Embeddingモデルシリーズの最適化に焦点を当て、3つの具体的なエンジニアリング課題に対処しました。
第一に、TPU Matrix Execution Unitsは語彙行列をシャーディングする際に厳格な整除性制約を課します。エンジニアたちは実行中の正確なテンソルアライメントを保証するために、ハードウェア安全な語彙パディング戦略を実装しました。第二に、逆量子化パイプラインにおける属性昇格を導入することで、マテリアライゼーションプロセスを強化しました。この変更により、重み読み込みがvLLMのTPU遅延ローダーと互換性を持つようになり、初期化失敗が解消されました。また、シャーディング対応のプレウォームを実装して推論前にコンパイルキャッシュをロックし、ランタイムレイテンシを削減しました。
第三に、極めて長いコンテキストの処理には、メモリ枯渇を防ぐための新しいアーキテクチャが必要でした。チームはメタデータをキャッシュされたリクエスト状態へ移行するハイブリッドStepPool機構を開発しました。これにより、プーリング状態がステップ間で正しく蓄積され、リクエストのプリエンプション(先取り)後も保持されるようになります。これらの最適化により、システムは状態の整合性を失うことなく、チャンク化されたプリフィル操作を効率的に処理できます。
主要な詳細
- vLLMにおけるネイティブTPUサポートにより、他のアクセラレータータイプとともに埋め込みワークロードの動的スケーリングが可能になります。
- このソリューションは、テキストおよびマルチモーダルタスク向けのQwen3-Embedding-8BおよびQwen3-VL-Embedding-8Bモデルを対象としています。
- ハードウェア安全な語彙パディングにより、並列実行中のTPUトポロジーメッシュ全体でテンソルのアライメントが保証されます。
- シャーディング対応のプレウォームによりJAX/XLAコンパイルキャッシュがロックされ、本番パイプラインの安定化とレイテンシ削減が図られます。
- テキスト入力では≥0.999、マルチモーダル入力では≥0.995のコサイン類似度スコアが、参照ベースラインと比較して達成されました。
- TPU Ironwood上でQwen3-Embedding-8Bを提供した結果、合計83,996トークン/秒、5.13リクエスト/秒の性能が記録されました。
なぜ重要なのか
AI製品を開発するソフトウェアエンジニアにとって、トラフィック急増時にサービスレベルアグリーメント(SLA)を維持するためには、埋め込み推論を弾力的にスケールできる能力が極めて重要です。従来の静的プロビジョニングは、過剰プロビジョニングやサービス品質の低下につながることがよくあります。TPUをvLLMおよびGKEと統合することで、チームはリアルタイムの需要に基づいてリソース割り当てを自動化できます。これにより、パフォーマンスを犠牲にすることなく、運用オーバーヘッドが削減され、コスト効率が向上します。
精度もまた重要な要因です。エンタープライズ環境では、ハードウェアバックエンド間のわずかな数値的不一致でも、検索品質やレコメンデーションの精度を低下させる可能性があります。投稿で説明されている厳格なパリティ評価により、TPUベースの推論が参照実装とほぼ完全な整合性を保つことが確認されています。これにより、開発者はワークロードをTPUへ移行してもAI機能の品質が損なわれないという確信を持てます。
さらに、長文コンテキストのマルチモーダル入力への対応は、複雑なリトリーバルタスクに対する新たな可能性を開きます。大規模ドキュメントと関連画像との間の関係を理解する必要があるアプリケーションは、これらの入力を効率的に処理できるようになりました。ハイブリッドStepPoolアーキテクチャにより、高負荷下でもこれらの重いワークロードが安定かつ応答性を保ちます。
実施可能なこと
- GitHub上の公式AI-Hypercomputer Qwen3-Embedding-8B Recipesを確認し、セットアップスクリプトとデプロイ手順を把握してください。
- 提供されているPython例をテストし、vLLMのネイティブプーニングランナーを使用してCloud TPU上でQwen3-Embedding-8Bを初期化してみてください。
- 現在の埋め込み出力とTPU生成ベクトル間のコサイン類似度を評価し、数値パリティを検証してください。
- GKEでCustom Compute Classesを設定し、TPUおよびGPUリソース間の自動スケーリングに関する優先順位ルールを定義してください。
- デプロイパイプラインにシャーディング対応のプレウォームを実装し、TPUワークロードのコールドスタートレイテンシを最小限に抑えてください。
- AI-HypercomputerプロジェクトのGitHubリポジトリを探索し、さらなる情報を見つけてください。



