Google demonstriert autonome LLM-Fine-Tuning-Schleifen auf TPUs
Der Google Developers Blog stellt autofinetune vor, ein agentengesteuertes System, das die Hyperparameter-Optimierung für SFT und RL-Nachtraining auf Cloud TPUs automatisiert.

Automatisch aus dem englischen Original übersetzt.
In einem Beitrag im Google Developers Blog vom September 2026 beschrieben Ingenieure einen neuen Ansatz zur Optimierung großer Sprachmodelle namens autofinetune. Dieses System nutzt autonome KI-Agenten, um den wiederkehrenden Zyklus aus überwachtem Fine-Tuning (Supervised Fine-Tuning) und Reinforcement Learning zu steuern, wobei Experimente auf Googles Cloud TPUs ohne ständige menschliche Aufsicht durchgeführt werden.
Was passiert ist
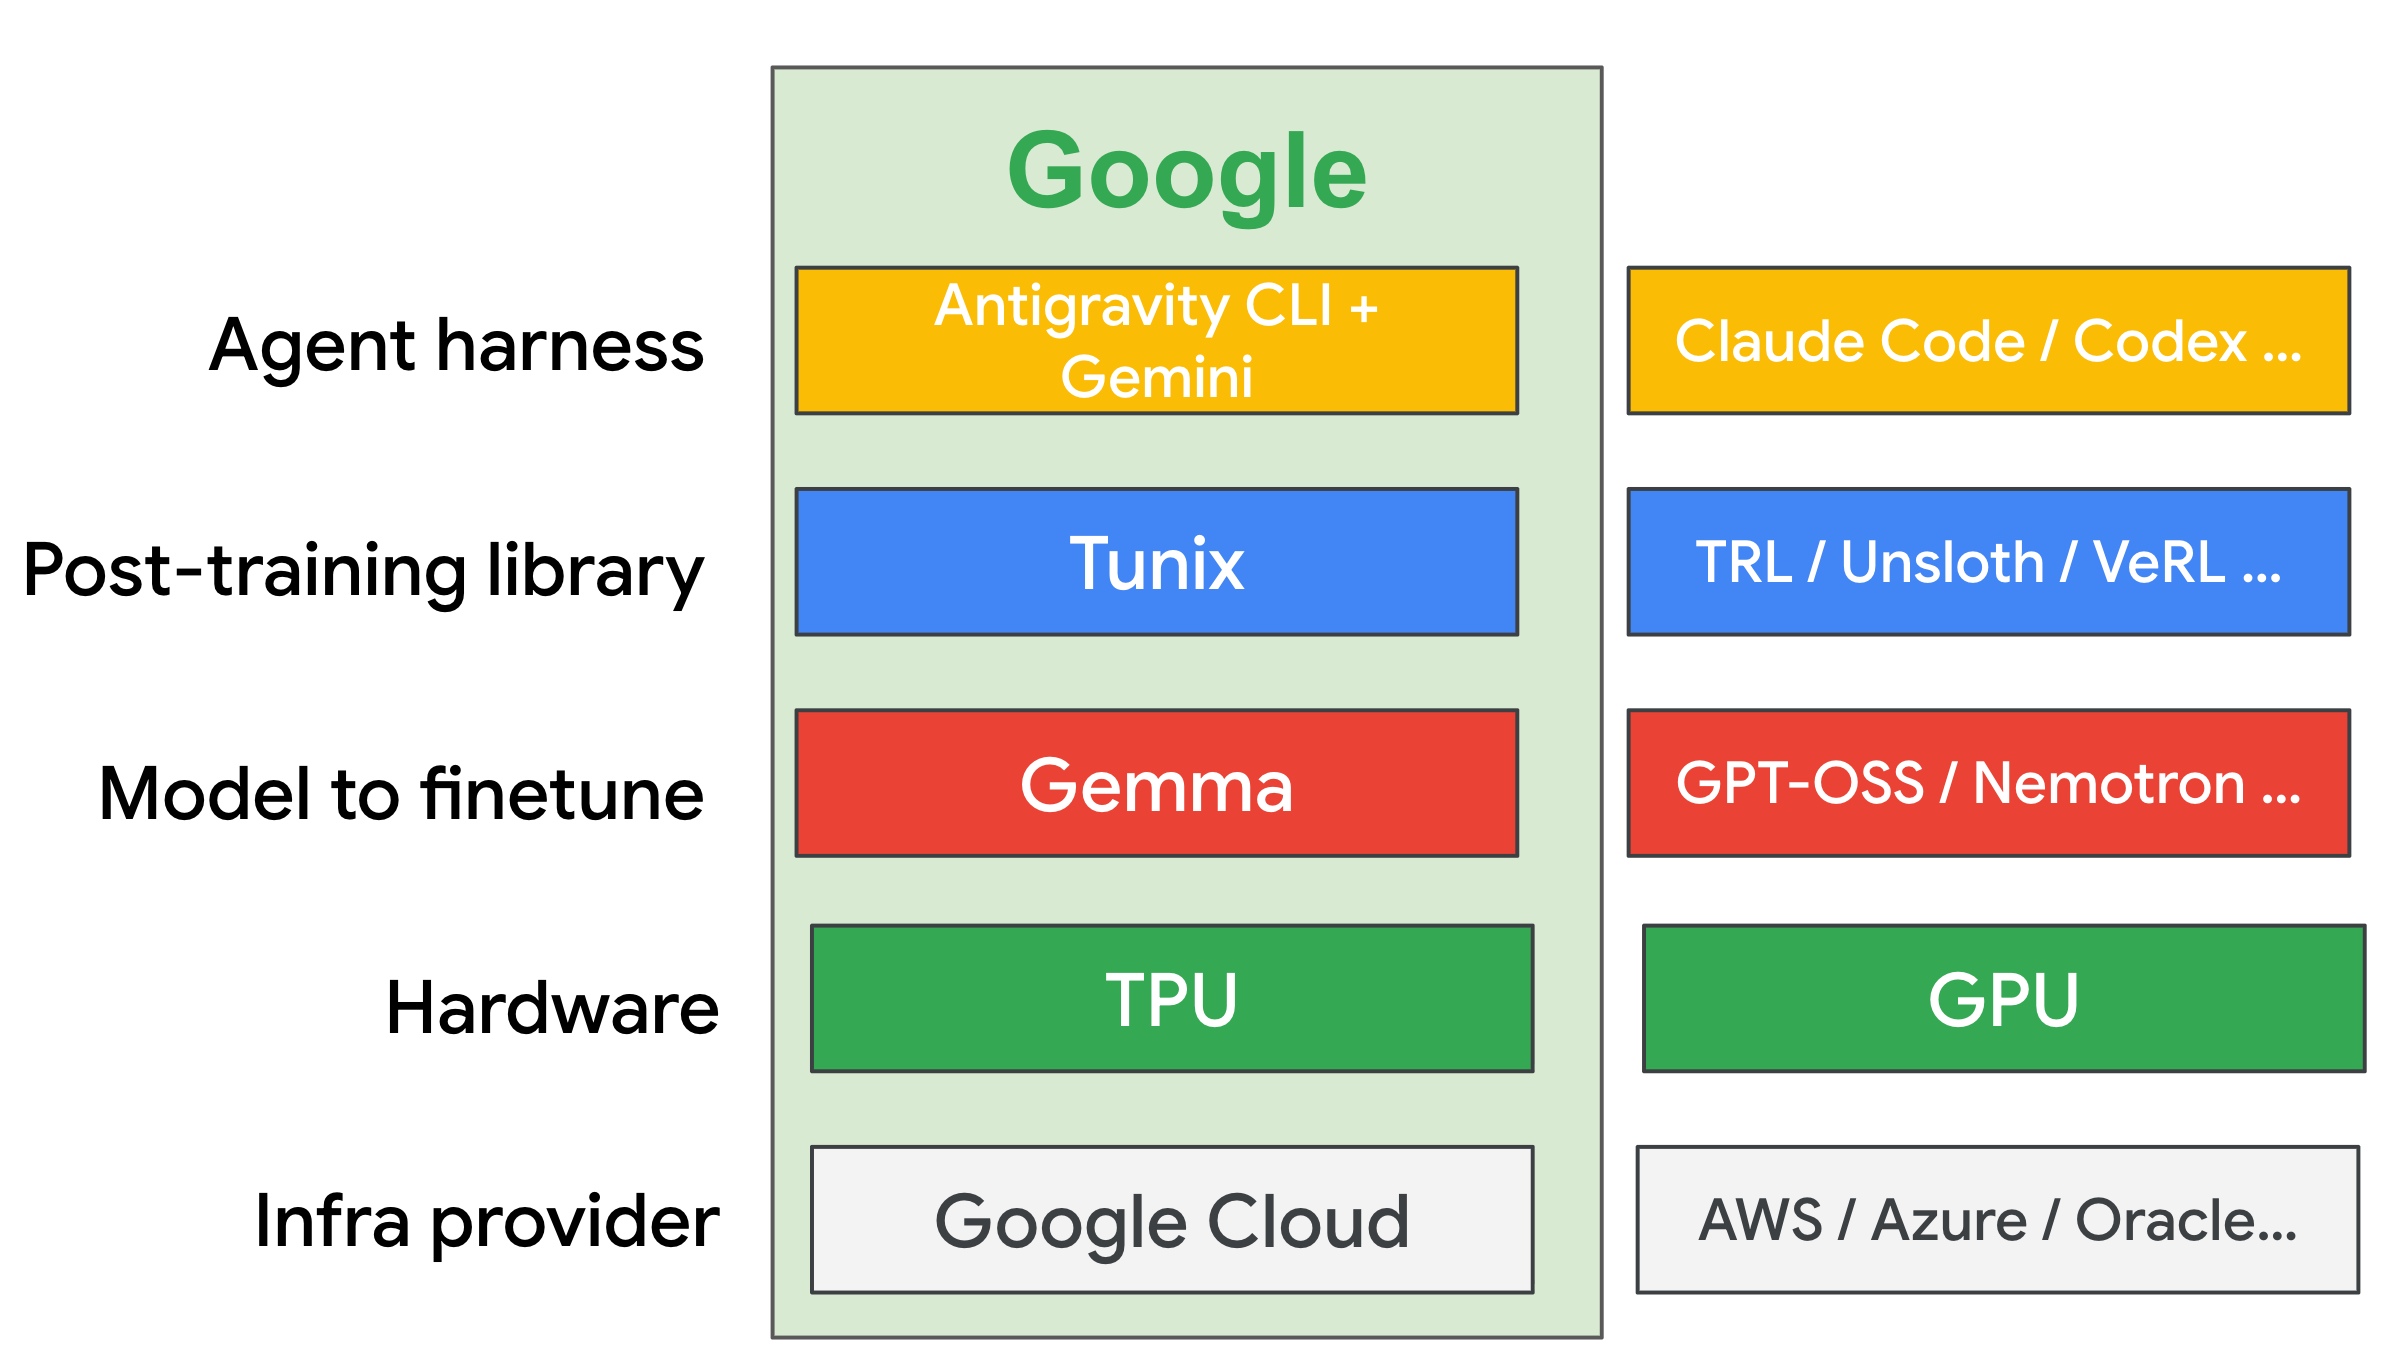
Herkömmliche Nachtrainings-Workflows erfordern von Entwicklern, manuell Änderungen zu hypothesieren, Skripte zu bearbeiten, Jobs zu starten und Ergebnisse zu überwachen. Dieser Prozess ist langsam und anfällig für menschliche Fehler. Das neue Projekt autofinetune automatisiert diese gesamte Schleife durch die Nutzung des vollständigen KI-Stacks von Google, einschließlich Tunix, Gemma-Modellen und Cloud TPUs, orchestriert über die Antigravity CLI und Gemini Flash 3.7. Das Ziel besteht darin, dass Ingenieure hochrangige Constraints definieren und einen Agenten über Nacht optimale Konfigurationen finden lassen können.
Das Team demonstrierte diese Fähigkeit anhand zweier unterschiedlicher Fallstudien. Die erste konzentrierte sich auf Supervised Fine-Tuning (SFT) unter Verwendung des Modells google/functiongemma-270m-it auf dem Datensatz google/mobile-actions. Auf einer einzelnen Cloud TPU v5e führte der Agent in nur wenigen Stunden 20 automatisierte Experimente durch. Er passte Variablen wie LoRA-Rang, Lernraten und Optimierer an, während der Datensatz und die Architektur unverändert blieben. Der Agent verbesserte erfolgreich die Genauigkeit bei der Generierung von Funktionsaufrufen, indem er diese Parameter iterativ verfeinerte.
Die zweite Fallstudie befasste sich mit Reinforcement Learning mittels Group Relative Policy Optimization (GRPO), einer komplexeren und instabilere Trainingsmethode. Unter Verwendung von Gemma 3 1B auf dem GSM8K-Datensatz für mathematisches Reasoning führte der Agent über zwei bis drei Tage hinweg 40 Experimente auf einer Cloud TPU v6e durch. Trotz der längeren Iterationszeiten und der Empfindlichkeit von RL identifizierte der Agent bessere LoRA-Konfigurationen und Rollout-Temperaturen. Dies führte zu einer Verbesserung von etwa 10 % in der kombinierten Metrik aus numerischer Genauigkeit und Formatgenauigkeit.
Wie es funktioniert
Das System basiert auf einem Paradigmenwechsel vom manuellen Tuning hin zu einer autonomen Forschungsschleife. Menschen definieren den Rahmen, indem sie eine program.md-Datei erstellen, die Randbedingungen, Evaluierungskriterien und Constraints festlegt. Sie stellen zudem ein sauberes, eigenständiges Ausführungsskript namens run.py bereit. Der KI-Agent übernimmt dann die Kontrolle, liest die Anweisungen in program.md, modifiziert run.py, startet Trainingsjobs und misst die Zielmetriken.
Wenn ein Experiment Verbesserungen bringt, committet der Agent die Änderungen in Git und protokolliert die Ergebnisse in einer results.tsv-Datei. Verursacht eine Änderung eine Regression, macht der Agent sie rückgängig. Dieses geschlossene System ermöglicht kontinuierliches Hill-Climbing hin zu besserer Leistung ohne manuelle Eingriffe. Der Agent erkundet einen definierten Suchraum, wie etwa zulässige Optimierer oder Batch-Größen, respektiert dabei aber nicht zulässige Änderungen wie die Modifikation der Kernmodell-Architektur.
Wichtige Details
- Das Projekt nutzt die Tunix-Bibliothek von Google, Gemma-Modelle und Cloud TPUs, orchestriert mit Antigravity CLI und Gemini Flash 3.7.
- In der SFT-Fallstudie führte der Agent auf einer Cloud TPU v5e-1 innerhalb weniger Stunden 20 Experimente durch und optimierte dabei LoRA-Ränge und Lernraten.
- Für die GRPO-Fallstudie führte der Agent über 2–3 Tage hinweg 40 Experimente auf einer Cloud TPU v6e-1 durch und verbesserte die Gesamtbelohnung um ungefähr 10 %.
- Menschliche Operatoren definieren Constraints in
program.mdund spezifizieren dabei zulässige Parameter wie die Batch-Größe sowie nicht zulässige Änderungen wie den Austausch von Datensätzen. - Der Agent verwaltet die Versionskontrolle automatisch, committet erfolgreiche Konfigurationen in Git und protokolliert Metriken in
results.tsv. - Die objektive Metrik für das RL-Experiment war eine vereinfachte Summe aus numerischer Genauigkeit und Formatgenauigkeit.
Warum das wichtig ist
Für Softwareteams, die KI-Produkte entwickeln, liegt der Engpass oft nicht in der Modellarchitektur, sondern im mühsamen Prozess des Hyperparameter-Tunings. Manuelle Experimente sind ressourcenintensiv und schwer zu skalieren. Durch die Automatisierung dieser Schleufe können Ingenieure die Zeit zurückgewinnen, die sie sonst für die Überwachung von Loss-Kurven und die Verwaltung von Tabellenkalkulationen aufwenden. Dieser Wandel ermöglicht es Teams, sich auf die Definition höherer Problemebenen und die Datenqualität zu konzentrieren, statt auf die mechanischen Aspekte der Trainingsläufe.
Darüber hinaus können autonome Agenten Konfigurationsräume gründlicher erkunden als Menschen, die aufgrund von Ermüdung oder Zeitdruck eingeschränkt sind. Die Möglichkeit, Dutzende von Experimenten über Nacht laufen zu lassen, bedeutet schnellere Iterationszyklen und potenziell leistungsstärkere Modelle. Dies ist besonders wertvoll für Reinforcement Learning, wo Instabilität das manuelle Tuning besonders herausfordernd macht. Die Integration mit bestehenden Tools wie Git stellt sicher, dass erfolgreiche Experimente nachverfolgt und reproduzierbar bleiben, was die ingenieurtechnische Sorgfalt wahrt.
Was Sie tun können
- Prüfen Sie das GitHub-Repository
autofinetune, um auf den Code, Beispiel-Läufe und die vom Team bereitgestelltenprogram.md-Vorlagen zuzugreifen. - Definieren Sie klare Randbedingungen und Evaluierungsmetriken für Ihre eigenen Fine-Tuning-Aufgaben, bevor Sie mit der Automatisierung beginnen.
- Beginnen Sie mit einfachen Experimenten zum überwachten Fine-Tuning, um zu verstehen, wie der Agent mit Ihren Trainingsskripten interagiert.
- Nutzen Sie die Tunix-Bibliothek und Cloud TPUs, um die in den Fallstudien beschriebene Hardware-Umgebung zu replizieren.
- Überwachen Sie die
results.tsv-Protokolle, um den Entscheidungsprozess des Agenten zu verstehen und Muster in erfolgreichen Konfigurationen zu identifizieren. - Experimentieren Sie mit verschiedenen Constraint-Sets in
program.md, um die Erkundungsgeschwindigkeit gegen die Rechenkosten abzuwägen.



