Optimierung der Inferenz für Long-Context-Embeddings auf Cloud TPU mit vLLM
Google erläutert, wie die native TPU-Unterstützung in vLLM elastische Skalierung und hochpräzise Embedding-Inferenz für Qwen3-Modelle ermöglicht.
Tägliche Berichterstattung zu KI, Entwicklertools und Infrastruktur. Jeder Artikel erklärt, was passiert ist und warum es wichtig ist, inklusive Link zur Originalquelle.
Google erläutert, wie die native TPU-Unterstützung in vLLM elastische Skalierung und hochpräzise Embedding-Inferenz für Qwen3-Modelle ermöglicht.
Kubernetes bietet keine native Unterstützung für partielle Geräteausfälle, was Ingenieure dazu zwingt, benutzerdefinierte Wiederherstellungslogiken für kostspielige AI- und ML-Trainingsjobs zu entwickeln.
Das Kubernetes-Projekt hat die Gateway API Inference Extension veröffentlicht, um das Routing für generative KI-Workloads zu standardisieren, die Latenz zu reduzieren und die GPU-Auslastung zu verbessern.
Kubernetes v1.33 führt einen neuen Verifizierungsmechanismus ein, um zu verhindern, dass nicht autorisierte Pods private Container-Images wiederverwenden, die bereits auf einem Node vorhanden sind.
Kubernetes v1.33 fügt eine Streaming-Kodierung für List-Antworten hinzu, was die Speichernutzung von kube-apiserver bei Abrufen großer Datensätze um bis zum 20-Fachen reduziert und die Cluster-Stabilität verbessert.
Kubernetes v1.32 reaktiviert die Funktion QueueingHint standardmäßig, sodass Plugins genau bestimmen können, wann nicht planbare Pods erneut versucht werden sollten, was verschwendete Scheduler-Zyklen reduziert.
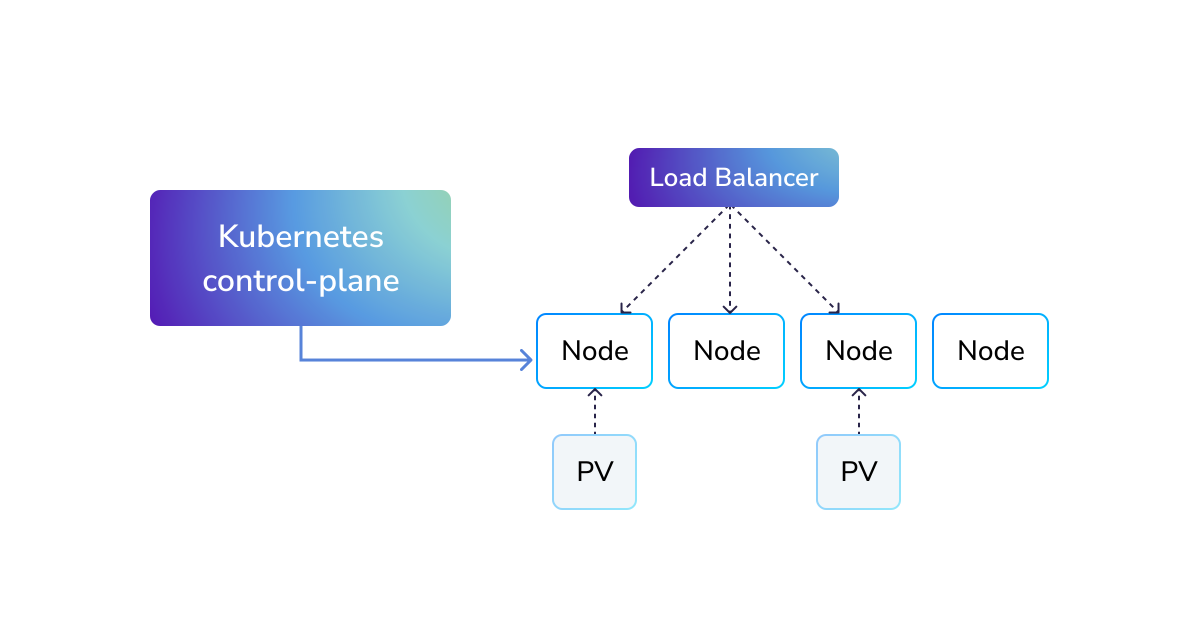
Ein technischer Leitfaden beschreibt, wie eine selbst gehostete Cloud-Plattform unter Verwendung von Kubernetes, Talos Linux und GitOps-Tools zur Verwaltung der Bare-Metal-Infrastruktur erstellt wird.
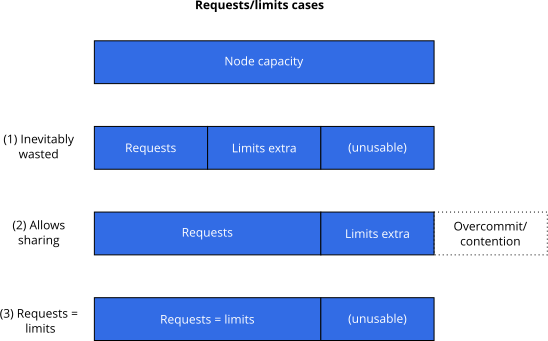
A 2023 analysis argues that setting CPU and memory limits in Kubernetes improves performance predictability, even if it reduces raw cluster efficiency.
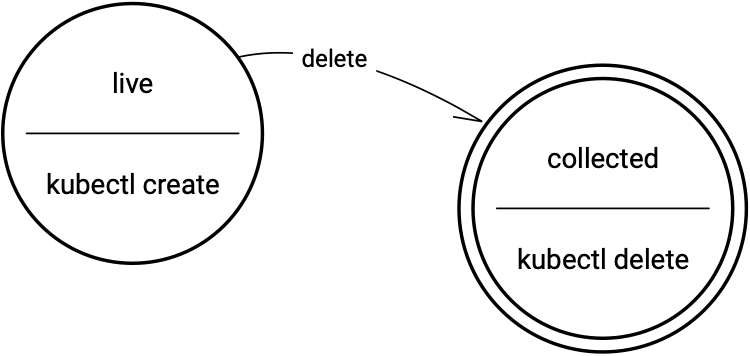
Ein Leitfaden aus dem Jahr 2021 erklärt, wie Finalizer die Entfernung von Ressourcen blockieren und wie Owner References kaskadierende Löschvorgänge in Kubernetes-Clustern steuern.