Việc tái tạo mô hình OLMo 3 7B trên TPU tiết lộ các lỗi ẩn trong trình tải dữ liệu
Một nghiên cứu tình huống của Google đã tái tạo thành công mô hình OLMo 3 của AI2 trên các bộ xử lý TPU, khớp với các chỉ số hiệu suất nhưng đồng thời phát hiện ra những lỗi phân mảnh dữ liệu nghiêm trọng khiến việc ghi nhớ dữ liệu bị nhầm lẫn là sự cải thiện.

Được dịch tự động từ bản gốc tiếng Anh.
Trong một bài đăng trên Google Developers Blog vào tháng 9 năm 2026, các kỹ sư đã chi tiết hóa quá trình tái tạo thành công mô hình ngôn ngữ OLMo 3 7B của Allen Institute for AI bằng cách sử dụng MaxText trên các bộ xử lý TPU của Google Cloud. Nhóm này đã khớp được các đường cong huấn luyện gốc và các bài kiểm tra chuẩn (benchmark) hạ nguồn, chứng minh rằng một quy trình dựa trên PyTorch cho GPU có thể được thực thi chính xác trong môi trường TPU dựa trên JAX.
Chuyện gì đã xảy ra
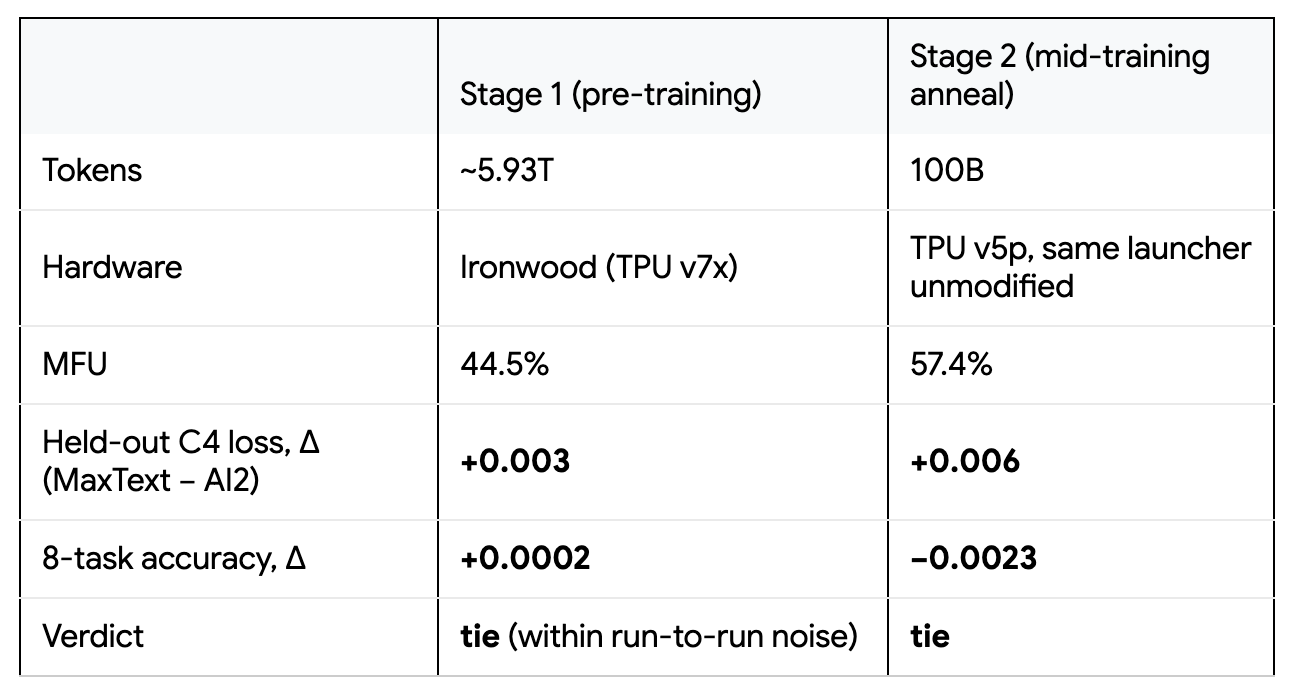
Nhóm kỹ thuật đặt mục tiêu xác minh khả năng của MaxText, một framework hiệu suất cao dành cho việc huấn luyện các mô hình ngôn ngữ lớn trên TPU. Họ chọn OLMo 3 vì đây là một trong số ít các mô hình thuộc nhóm tiên phong (frontier-class) có đầy đủ trọng số, dữ liệu và quy trình huấn luyện mở. Tính minh bạch này cho phép so sánh chặt chẽ với một lần chạy tham chiếu độc lập, thay vì chỉ dựa vào các đường cong mất mát (loss curves). Quá trình tái tạo bao gồm giai đoạn tiền huấn luyện (stage-1 pre-training) và giai đoạn tôi luyện trung gian (stage-2 mid-training annealing), sử dụng các điểm kiểm tra (checkpoints) PyTorch bước-0 của AI2 được chuyển đổi sang định dạng Orbax cho JAX.
Kết quả cho thấy MaxText có thể theo dõi đường cong mất mát do AI2 công bố trong toàn bộ ngân sách 5,93 nghìn tỷ token. Tuy nhiên, quá trình này không tránh khỏi những phức tạp. Trong các giai đoạn huấn luyện sau, lần chạy MaxText dường như vượt trội hơn so với bản tham chiếu, với mức mất mát khi huấn luyện giảm đáng kể xuống dưới mức của AI2. Điều tra sâu hơn cho thấy đây không phải là sự cải thiện chất lượng mô hình thực sự, mà là một sản phẩm phụ của lỗi tải dữ liệu. Nhóm cũng chứng minh khả năng phục hồi của hệ thống bằng cách thay đổi kích thước công việc huấn luyện giữa chừng sau khi mất dung lượng phần cứng và chuyển đổi thế hệ TPU giữa các giai đoạn huấn luyện mà không cần thay đổi quy trình cốt lõi.
Cách thức hoạt động
Để đảm bảo độ trung thực, nhóm đã chuyển đổi các lựa chọn kiến trúc cụ thể của OLMo 3, bao gồm các khối norm được sắp xếp lại, QK-norm và mẫu chú ý (attention) kết hợp giữa cửa sổ trượt và toàn cục, vào MaxText. Họ xác minh quá trình chuyển đổi bằng cách kiểm tra tính tương đương của logit, đảm bảo mô hình đã chuyển đổi khớp với tham chiếu HuggingFace trong phạm vi nhiễu dự kiến giữa các framework khác nhau. Quy trình dữ liệu được xây dựng lại bằng Grain, triển khai đọc truy cập ngẫu nhiên, xáo trộn chỉ mục toàn cục và lọc lặp lại n-gram để phản ánh chính xác thiết lập ban đầu.
Tối ưu hóa hiệu suất đóng vai trò then chốt giúp việc tái tạo trở nên khả thi. Nhóm đạt được mức sử dụng flops mô hình (MFU) là 44,5% trên các TPU Ironwood bằng cách chuyển giao các thao tác tập thể (collectives) sang SparseCore và điều chỉnh chiến lược vật liệu hóa lại (rematerialization). Họ cũng khám phá các cơ hội đồng thiết kế (co-design), chẳng hạn như định hình lại các đầu chú ý (attention heads) để tận dụng tốt hơn các đơn vị nhân ma trận của TPU, mang lại tốc độ huấn luyện nhanh hơn mà không làm giảm chất lượng. Những điều chỉnh kỹ thuật này cho phép hệ thống duy trì thông lượng ngay cả khi tài nguyên phần cứng thay đổi động trong suốt quá trình huấn luyện kéo dài nhiều tuần.
Chi tiết quan trọng
- Khớp chỉ số: Mô hình được tái tạo khớp với các chỉ số đánh giá giữ lại (held-out evaluation metrics) của AI2, bao gồm mất mát C4 và tám nhiệm vụ hạ nguồn, với sai lệch độ chính xác không bao giờ vượt quá ±0,005.
- Phát hiện lỗi dữ liệu: Một lỗi phân mảnh kép trong trình tải dữ liệu Grain đã gây ra các phiên bản dữ liệu trùng lặp, làm giảm giả tạo mức mất mát khi huấn luyện lên tới 0,25 điểm mà không cải thiện khả năng tổng quát hóa.
- Khả năng phục hồi phần cứng: Công việc huấn luyện đã tiếp tục thành công trên một lát cắt cụm nhỏ hơn bốn lần so với kích thước ban đầu sau khi mất dung lượng, duy trì thông lượng mỗi thiết bị trong vòng 1%.
- Chuyển đổi framework: Trọng số PyTorch được chuyển đổi sang Orbax với độ phân kỳ KL khoảng 1,5e-3, xác nhận các mô hình giống hệt nhau tại thời điểm khởi tạo.
- Quy trình đơn giản hóa: Nhóm đã sử dụng một lịch trình tốc độ học cosine duy nhất thay vì phương pháp ghép hai đường cong của AI2, nhưng vẫn đạt được kết quả tương đương.
Tại sao điều này quan trọng
Đối với các nhà phát triển xây dựng hệ thống AI quy mô lớn, nghiên cứu tình huống này nhấn mạnh nguy hiểm của việc chỉ dựa vào mất mát khi huấn luyện như một đại diện cho chất lượng mô hình. Sự cố mà MaxText dường như vượt qua bản tham chiếu do ghi nhớ dữ liệu là một lời nhắc nhở rõ ràng rằng mức mất mát thấp hơn không luôn đồng nghĩa với hiệu suất tốt hơn. Nó khẳng định sự cần thiết của các đánh giá giữ lại chặt chẽ và các bước xác minh độc lập để phát hiện những lỗi tinh vi trong quy trình dữ liệu, vốn có thể không bị chú ý trong nhiều tuần.
Hơn nữa, việc tái tạo thành công chứng minh sự trưởng thành của hệ sinh thái JAX và TPU trong việc xử lý các kiến trúc transformer phức tạp và phi chuẩn. Nó cung cấp một khuôn mẫu cho các nhóm muốn di chuyển từ stack PyTorch/GPU sang môi trường JAX/TPU, cho thấy việc tái tạo trung thực là khả thi ngay cả khi có những khác biệt kiến trúc đáng kể. Khả năng thay đổi kích thước công việc và chuyển đổi thế hệ phần cứng giữa chừng trong quá trình huấn luyện cũng cung cấp những hiểu biết thực tế về quản lý chi phí và độ tin cậy trong các công việc huấn luyện đám mây chạy dài hạn.
Bạn có thể làm gì
- Triển khai các đánh giá giữ lại thường xuyên song song với giám sát mất mát khi huấn luyện để phát hiện sớm việc ghi nhớ hoặc rò rỉ dữ liệu.
- Xác minh logic phân mảnh của trình tải dữ liệu bằng các bài kiểm tra đơn vị mô phỏng môi trường đa worker để ngăn chặn sự trùng lặp dữ liệu âm thầm.
- Sử dụng các kiểm tra tương đương logit khi chuyển đổi mô hình giữa các framework để đảm bảo tính nhất quán khi khởi tạo trước khi bắt đầu huấn luyện.
- Thiết kế các script huấn luyện để xử lý những thay đổi tài nguyên động, cho phép tiếp tục liền mạch trên các lát cắt phần cứng khác nhau nếu xảy ra sự cố preempt.
- So sánh độ chính xác của nhiệm vụ hạ nguồn tại nhiều điểm kiểm tra, không chỉ ở cuối quá trình huấn luyện, để đảm bảo sự tăng trưởng năng lực nhất quán.
- Xem xét cấu hình quy trình dữ liệu để tìm các thao tác phân mảnh dư thừa, đặc biệt khi sử dụng các thư viện như Grain có thể tự xử lý phân mảnh bên trong.



