Google trình diễn vòng lặp tinh chỉnh LLM tự động trên TPU
Blog của Google Developers giới thiệu autofinetune, một hệ thống do tác nhân AI điều khiển, tự động hóa việc tinh chỉnh siêu tham số cho quá trình huấn luyện có giám sát (SFT) và hậu huấn luyện bằng học tăng cường (RL) trên Cloud TPUs.

Được dịch tự động từ bản gốc tiếng Anh.
Trong một bài đăng trên Blog của Google Developers vào tháng 9 năm 2026, các kỹ sư đã mô tả một phương pháp mới để tối ưu hóa mô hình ngôn ngữ lớn (LLM) mang tên autofinetune. Hệ thống này sử dụng các tác nhân AI tự chủ để quản lý chu trình lặp đi lặp lại của quá trình tinh chỉnh có giám sát và học tăng cường, chạy các thử nghiệm trên Cloud TPUs của Google mà không cần sự giám sát liên tục từ con người.
Chuyện gì đã xảy ra
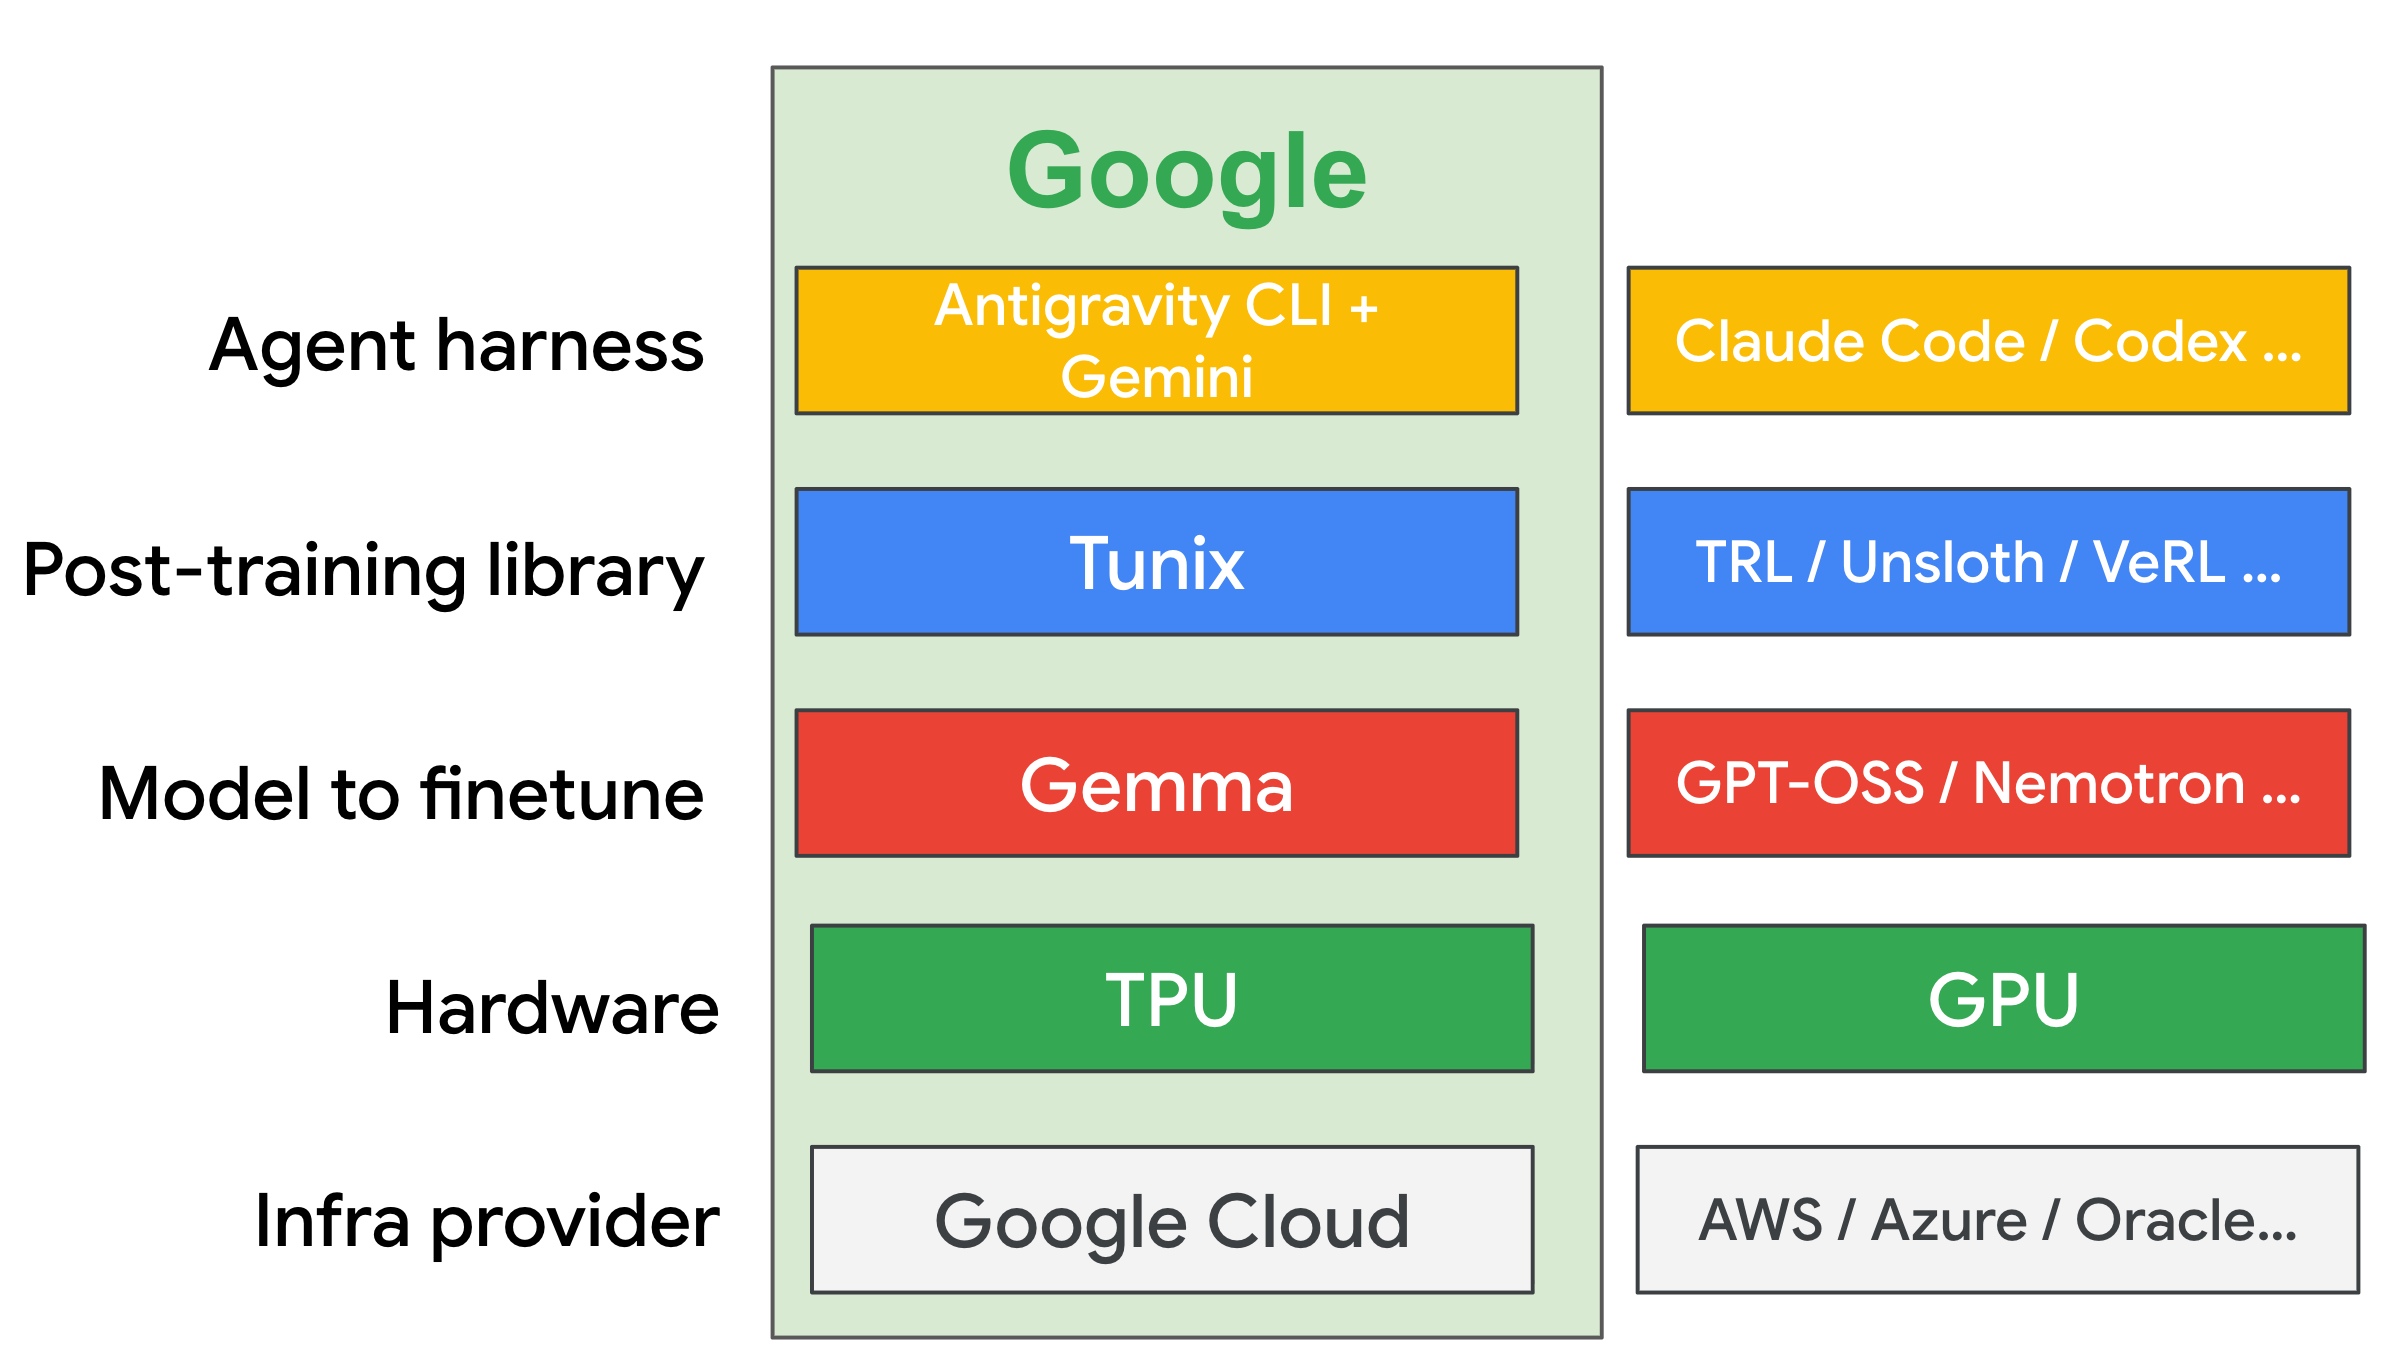
Các quy trình làm việc hậu huấn luyện truyền thống đòi hỏi lập trình viên phải tự đưa ra giả thuyết về những thay đổi, chỉnh sửa tập lệnh, khởi chạy công việc và theo dõi kết quả. Quy trình này chậm chạp và dễ mắc lỗi do con người. Dự án autofinetune mới tự động hóa toàn bộ vòng lặp này bằng cách tận dụng toàn bộ ngăn xếp AI của Google, bao gồm Tunix, các mô hình Gemma và Cloud TPUs, được điều phối qua Antigravity CLI và Gemini Flash 3.7. Mục tiêu là cho phép các kỹ sư xác định các ràng buộc ở cấp độ cao hơn và để một tác nhân khám phá các cấu hình tối ưu trong khi họ ngủ.
Nhóm đã chứng minh khả năng này thông qua hai nghiên cứu tình huống riêng biệt. Nghiên cứu đầu tiên tập trung vào Tinh chỉnh Có Giám sát (SFT) sử dụng mô hình google/functiongemma-270m-it trên bộ dữ liệu google/mobile-actions. Chạy trên một Cloud TPU v5e duy nhất, tác nhân đã thực hiện 20 thử nghiệm tự động chỉ trong vài giờ. Nó điều chỉnh các biến như hạng LoRA, tốc độ học và bộ tối ưu hóa trong khi giữ nguyên bộ dữ liệu và kiến trúc. Tác nhân đã thành công trong việc cải thiện độ chính xác của việc tạo lời gọi hàm bằng cách liên tục tinh chỉnh các tham số này.
Nghiên cứu tình huống thứ hai giải quyết Học Tăng Cường thông qua Tối ưu hóa Chính sách Tương đối Nhóm (GRPO), một phương pháp huấn luyện phức tạp và kém ổn định hơn. Sử dụng Gemma 3 1B trên bộ dữ liệu suy luận toán học GSM8K, tác nhân đã chạy 40 thử nghiệm trong hai đến ba ngày trên Cloud TPU v6e. Bất chấp thời gian lặp dài hơn và tính nhạy cảm của RL, tác nhân đã xác định được các cấu hình LoRA và nhiệt độ rollout tốt hơn. Điều này dẫn đến mức cải thiện khoảng 10% trong chỉ số tổng hợp giữa độ chính xác số học và độ chính xác định dạng.
Cách thức hoạt động
Hệ thống vận hành dựa trên sự chuyển đổi mô hình từ tinh chỉnh thủ công sang vòng lặp nghiên cứu tự chủ. Con người xác định phạm vi bằng cách tạo một tệp program.md thiết lập các điều kiện biên, tiêu chí đánh giá và ràng buộc. Họ cũng cung cấp một tập lệnh thực thi sạch sẽ, độc lập tên là run.py. Sau đó, tác nhân AI tiếp quản, đọc hướng dẫn trong program.md để sửa đổi run.py, khởi chạy các công việc huấn luyện và đo lường các chỉ số mục tiêu.
Nếu một thử nghiệm mang lại sự cải thiện, tác nhân sẽ cam kết (commit) các thay đổi vào Git và ghi lại kết quả trong một tệp results.tsv. Nếu một thay đổi gây ra sự suy giảm hiệu suất, tác nhân sẽ hoàn tác nó. Hệ thống vòng lặp kín này cho phép leo đồi liên tục hướng tới hiệu suất tốt hơn mà không cần can thiệp thủ công. Tác nhân khám phá một không gian tìm kiếm được xác định trước, chẳng hạn như các bộ tối ưu hóa hoặc kích thước lô (batch size) được phép, đồng thời tôn trọng các thay đổi bị cấm như sửa đổi kiến trúc mô hình cốt lõi.
Chi tiết quan trọng
- Dự án sử dụng thư viện Tunix của Google, các mô hình Gemma và Cloud TPUs, được điều phối với Antigravity CLI và Gemini Flash 3.7.
- Trong nghiên cứu tình huống SFT, tác nhân đã chạy 20 thử nghiệm trong vài giờ trên Cloud TPU v5e-1, tối ưu hóa các hạng LoRA và tốc độ học.
- Đối với nghiên cứu tình huống GRPO, tác nhân đã tiến hành 40 thử nghiệm trong 2–3 ngày trên Cloud TPU v6e-1, cải thiện phần thưởng tổng thể khoảng 10%.
- Người vận hành con người xác định các ràng buộc trong
program.md, chỉ rõ các tham số được phép như kích thước lô và các thay đổi bị cấm như hoán đổi bộ dữ liệu. - Tác nhân tự động quản lý kiểm soát phiên bản, cam kết các cấu hình thành công vào Git và ghi lại các chỉ số trong
results.tsv. - Chỉ số mục tiêu cho thử nghiệm RL là tổng đơn giản hóa giữa độ chính xác số học và độ chính xác định dạng.
Tại sao điều này quan trọng
Đối với các nhóm phần mềm xây dựng sản phẩm AI, nút thắt cổ chai thường không nằm ở kiến trúc mô hình mà ở quy trình nhàm chán của việc tinh chỉnh siêu tham số. Thử nghiệm thủ công tốn nhiều tài nguyên và khó mở rộng quy mô. Bằng cách tự động hóa vòng lặp này, các kỹ sư có thể lấy lại thời gian dành cho việc theo dõi đường cong mất mát (loss curves) và quản lý bảng tính. Sự chuyển dịch này cho phép các nhóm tập trung vào việc xác định vấn đề ở cấp độ cao hơn và chất lượng dữ liệu thay vì các khía cạnh cơ học của các lần chạy huấn luyện.
Hơn nữa, các tác nhân tự chủ có thể khám phá không gian cấu hình kỹ lưỡng hơn so với những gì con người có thể cố gắng do mệt mỏi hoặc hạn chế về thời gian. Khả năng chạy hàng chục thử nghiệm qua đêm có nghĩa là các chu kỳ lặp nhanh hơn và tiềm năng cho các mô hình có hiệu suất tốt hơn. Điều này đặc biệt có giá trị đối với học tăng cường, nơi sự bất ổn khiến việc tinh chỉnh thủ công trở nên đặc biệt thách thức. Việc tích hợp với các công cụ hiện có như Git đảm bảo rằng các thử nghiệm thành công được theo dõi và có thể tái tạo, duy trì sự nghiêm ngặt trong kỹ thuật.
Bạn có thể làm gì
- Xem xét kho lưu trữ GitHub
autofinetuneđể truy cập mã nguồn, các lần chạy mẫu và các mẫuprogram.mddo nhóm cung cấp. - Xác định rõ ràng các điều kiện biên và chỉ số đánh giá cho các nhiệm vụ tinh chỉnh của bạn trước khi thử nghiệm tự động hóa.
- Bắt đầu với các thử nghiệm tinh chỉnh có giám sát đơn giản để hiểu cách tác nhân tương tác với các tập lệnh huấn luyện của bạn.
- Sử dụng thư viện Tunix và Cloud TPUs để sao chép môi trường phần cứng được mô tả trong các nghiên cứu tình huống.
- Theo dõi nhật ký
results.tsvđể hiểu quy trình ra quyết định của tác nhân và xác định các mẫu trong các cấu hình thành công. - Thử nghiệm với các bộ ràng buộc khác nhau trong
program.mdđể cân bằng giữa tốc độ khám phá và chi phí tính toán.



