Tối ưu hóa suy luận embedding ngữ cảnh dài trên Cloud TPU với vLLM
Google mô tả cách hỗ trợ TPU gốc trong vLLM cho phép mở rộng linh hoạt và suy luận embedding độ chính xác cao cho các mô hình Qwen3.
Cập nhật hàng ngày về AI, công cụ lập trình và hạ tầng. Mỗi bài viết giải thích chuyện gì đã xảy ra và tại sao nó quan trọng, kèm link đến nguồn gốc.
Google mô tả cách hỗ trợ TPU gốc trong vLLM cho phép mở rộng linh hoạt và suy luận embedding độ chính xác cao cho các mô hình Qwen3.
Kubernetes thiếu hỗ trợ gốc cho các lỗi thiết bị một phần, buộc các kỹ sư phải xây dựng logic khắc phục tùy chỉnh cho các tác vụ huấn luyện AI và ML tốn kém.
Dự án Kubernetes đã phát hành Phần mở rộng Suy luận của Gateway API nhằm chuẩn hóa việc định tuyến cho các khối lượng công việc AI tạo sinh, giúp giảm độ trễ và cải thiện hiệu suất sử dụng GPU.
Kubernetes v1.33 giới thiệu một cơ chế xác minh mới nhằm ngăn chặn các pod trái phép tái sử dụng hình ảnh container riêng tư đã có sẵn trên node.
Kubernetes v1.33 bổ sung mã hóa dạng stream cho các phản hồi List, giúp giảm mức sử dụng bộ nhớ của kube-apiserver lên tới 20 lần khi truy xuất các tập dữ liệu lớn và cải thiện độ ổn định của cụm.
Kubernetes v1.32 mặc định bật lại tính năng QueueingHint, cho phép các plugin xác định chính xác thời điểm nên thử lại các pod không thể lập lịch, từ đó giảm thiểu các chu kỳ lập lịch bị lãng phí.
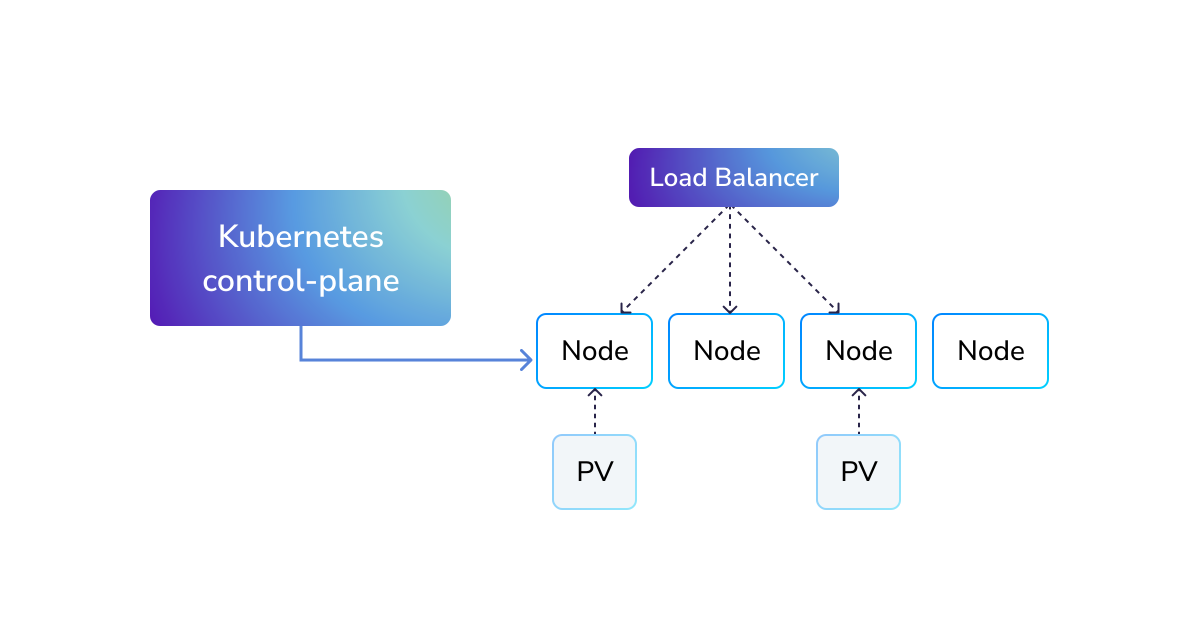
Một hướng dẫn kỹ thuật chi tiết cách xây dựng nền tảng đám mây tự chủ (self-hosted) sử dụng Kubernetes, Talos Linux và các công cụ GitOps để quản lý hạ tầng bare metal.
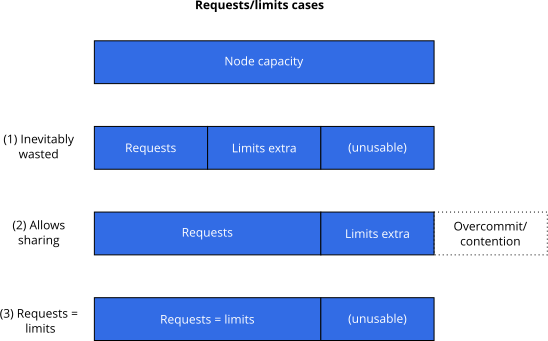
Một phân tích năm 2023 lập luận rằng việc thiết lập giới hạn CPU và bộ nhớ trong Kubernetes giúp cải thiện tính dự đoán của hiệu suất, ngay cả khi điều đó làm giảm hiệu quả tổng thể của cụm.
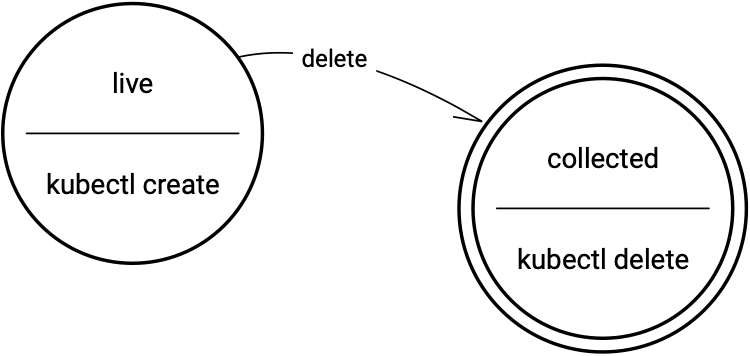
Một hướng dẫn năm 2021 giải thích cách các finalizer ngăn chặn việc xóa tài nguyên và cách các owner reference quản lý quy trình xóa dây chuyền (cascading deletes) trong các cụm Kubernetes.