Kubernetes giới thiệu phần mở rộng Gateway API cho định tuyến suy luận LLM
Dự án Kubernetes đã phát hành Phần mở rộng Suy luận của Gateway API nhằm chuẩn hóa việc định tuyến cho các khối lượng công việc AI tạo sinh, giúp giảm độ trễ và cải thiện hiệu suất sử dụng GPU.

Được dịch tự động từ bản gốc tiếng Anh.
Trong một bài đăng trên Blog Kubernetes vào tháng 6 năm 2025, các cộng tác viên từ Solo.io, Google và Bytedance đã giới thiệu Phần mở rộng Suy luận của Gateway API. Phần mở rộng tiêu chuẩn mới này giải quyết các thách thức cụ thể về định tuyến lưu lượng truy cập đối với các mô hình ngôn ngữ lớn (LLM) tự lưu trữ bằng cách bổ sung các khả năng nhận biết suy luận vào khung làm việc Gateway API hiện có.
Chuyện gì đã xảy ra
Các dịch vụ AI tạo sinh hiện đại khác biệt đáng kể so với các ứng dụng web truyền thống. Trong khi các yêu cầu HTTP tiêu chuẩn thường ngắn hạn và không duy trì trạng thái, các phiên suy luận LLM lại chạy trong thời gian dài, tiêu tốn nhiều tài nguyên và duy trì một phần trạng thái. Một máy chủ mô hình dựa trên GPU đơn lẻ có thể duy trì nhiều phiên suy luận đang hoạt động và giữ bộ nhớ đệm token trong RAM. Các bộ cân bằng tải truyền thống, vốn thường dựa vào khớp đường dẫn HTTP đơn giản hoặc phân phối vòng tròn (round-robin), thiếu logic chuyên biệt cần thiết để xử lý hiệu quả các khối lượng công việc phức tạp này. Chúng không tính đến danh tính của mô hình hay mức độ quan trọng của một yêu cầu, chẳng hạn như phân biệt giữa một phiên chat tương tác và một job xử lý nền theo lô.
Để giải quyết vấn đề này, cộng đồng đã phát triển Phần mở rộng Suy luận của Gateway API. Dự án này xây dựng dựa trên mô hình Gateway API quen thuộc, cho phép các kỹ sư nền tảng biến đổi một gateway tiêu chuẩn thành một "Inference Gateway" (Gateway Suy luận). Mục tiêu là cung cấp một phương pháp tiếp cận chuẩn hóa để định tuyến các khối lượng công việc suy luận trong toàn hệ sinh thái, thoát khỏi các giải pháp tùy chỉnh ad-hoc. Bằng cách kích hoạt định tuyến nhận biết mô hình và hỗ trợ mức độ ưu tiên theo từng yêu cầu, phần mở rộng này nhằm mục đích giảm độ trễ và tối ưu hóa việc sử dụng các bộ tăng tốc như GPU.
Cách thức hoạt động
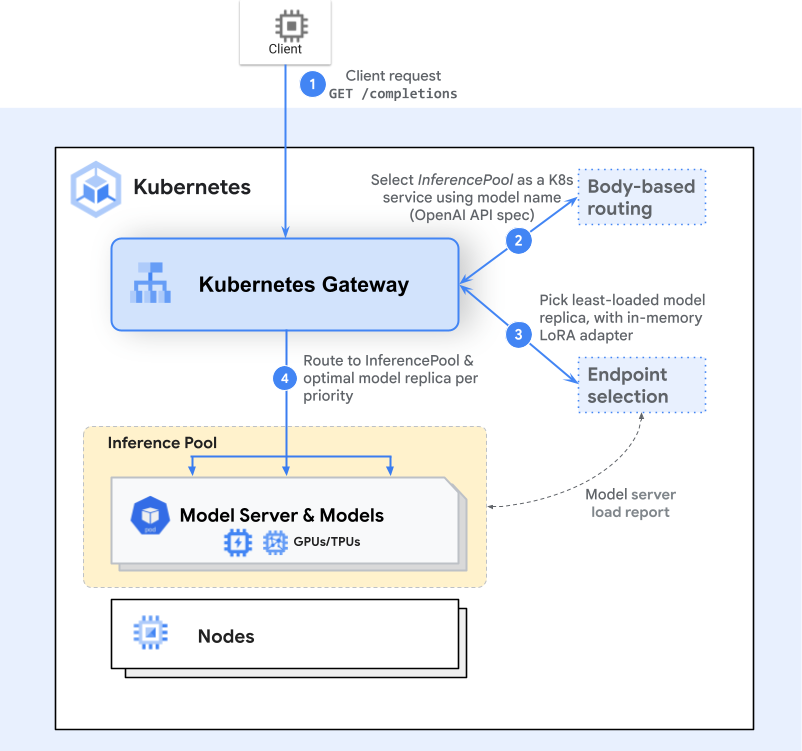
Kiến trúc này giới thiệu hai Định nghĩa Tài nguyên Tùy chỉnh (CRD) mới, tách biệt trách nhiệm giữa những người vận hành nền tảng và chủ sở hữu AI/ML. Đầu tiên, InferencePool định nghĩa một nhóm pod chạy các máy chủ mô hình trên các tài nguyên tính toán chia sẻ. Quản trị viên nền tảng sử dụng tài nguyên này để cấu hình chính sách triển khai, mở rộng quy mô và cân bằng tải, đảm bảo việc sử dụng tài nguyên nhất quán trên toàn cụm. Nó hoạt động tương tự như một Service trong Kubernetes nhưng đặc biệt nhận biết các giao thức phục vụ mô hình.
Tài nguyên thứ hai, InferenceModel, được quản lý bởi các đội ngũ AI/ML. Nó ánh xạ một tên endpoint công khai, chẳng hạn như "gpt-4-chat", sang một mô hình cụ thể bên trong một InferencePool. Điều này cho phép chủ sở hữu khối lượng công việc xác định những mô hình nào được phục vụ, bao gồm cả các biến thể tinh chỉnh (fine-tuning), và thiết lập các chính sách phân tách lưu lượng hoặc ưu tiên. Sự tách biệt này đảm bảo rằng các đội ngũ nền tảng quản lý cơ sở hạ tầng trong khi các đội ngũ ứng dụng quản lý việc phơi bày mô hình.
Khi một khách hàng gửi yêu cầu, Gateway kiểm tra HTTPRoute để xác định InferencePool đích. Thay vì chuyển tiếp lưu lượng truy cập đến bất kỳ pod khả dụng nào, Gateway tham khảo một Phần mở rộng Lựa chọn Endpoint (Endpoint Selection Extension). Thành phần này phân tích các số liệu đo trực tiếp từ các pod, chẳng hạn như độ dài hàng đợi, mức sử dụng bộ nhớ và các adapter đã nạp. Sau đó, nó chọn pod tối ưu dựa trên các điều kiện thời gian thực, đảm bảo yêu cầu được xử lý với độ trễ thấp nhất hoặc hiệu quả cao nhất. Quá trình này vẫn minh bạch đối với khách hàng, xuất hiện dưới dạng một yêu cầu đơn lẻ tiêu chuẩn.
Chi tiết chính
- Hai CRD mới:
InferencePoolcho quản lý tài nguyên cấp nền tảng vàInferenceModelcho các endpoint mô hình hướng tới người dùng. - Phần mở rộng Lựa chọn Endpoint: Thay thế round-robin đơn giản bằng định tuyến nhận biết số liệu đo, xem xét độ sâu hàng đợi và trạng thái bộ nhớ.
- Môi trường benchmark: Các bài kiểm tra sử dụng vLLM phiên bản 1 trên các pod GPU H100 (80 GB) với 10 bản sao Llama2.
- Cải thiện độ trễ: Phần mở rộng cho thấy độ trễ p90 thấp hơn đáng kể ở tải cao (trên 500 QPS) so với các Service Kubernetes tiêu chuẩn.
- Tương đương thông lượng: Thông lượng vẫn tương đương với các service tiêu chuẩn trong phạm vi thử nghiệm từ 100 đến 1000 Query mỗi giây.
- Thiết kế mở rộng: Khung làm việc hỗ trợ các phần mở rộng bổ sung cho các chiến lược định tuyến mới hoặc nhu cầu phần cứng chuyên biệt.
Tại sao điều này quan trọng
Đối với các đội ngũ kỹ thuật xây dựng sản phẩm AI, phần mở rộng này mang đến một lộ trình hướng tới việc phục vụ mô hình tự lưu trữ đáng tin cậy và hiệu quả hơn. Bằng cách định tuyến các yêu cầu dựa trên số liệu đo của pod theo thời gian thực thay vì các quy tắc tĩnh, các tổ chức có thể tránh được các điểm nóng (hotspot) xảy ra khi bộ nhớ GPU tiến gần đến bão hòa. Điều này dẫn đến độ trễ đuôi (tail latency) dự đoán được tốt hơn, yếu tố then chốt để duy trì trải nghiệm người dùng mượt mà trong các ứng dụng tương tác. Khả năng ưu tiên lưu lượng truy cập dựa trên mức độ quan trọng cũng đảm bảo rằng các tương tác giá trị cao không bị chặn bởi các quy trình batch có mức ưu tiên thấp hơn.
Từ góc độ vận hành, việc chuẩn hóa giảm bớt gánh nặng bảo trì của logic định tuyến tùy chỉnh. Các đội ngũ nền tảng có thể thực thi các chính sách nhất quán trên các mô hình và đội ngũ khác nhau bằng cách sử dụng các công cụ Kubernetes gốc. Khi dự án tiến tới giai đoạn sẵn sàng chung (general availability), các tính năng như cân bằng tải nhận biết bộ nhớ đệm prefix và hỗ trợ các bộ tăng tốc dị hợp sẽ nâng cao hơn nữa tính hữu ích của nó. Sự liên kết với các công cụ Kubernetes-native đơn giản hóa việc tích hợp các dịch vụ GenAI vào cơ sở hạ tầng hiện có.
Bạn có thể làm gì
- Xem xét tài liệu dự án chính thức để hiểu các đặc tả API và yêu cầu cài đặt.
- Triển khai một Inference Gateway thử nghiệm trong môi trường không phải production để đánh giá Phần mở rộng Lựa chọn Endpoint.
- Ánh xạ các dịch vụ mô hình hiện có sang các tài nguyên
InferencePoolvàInferenceModelđể kiểm tra lộ trình di chuyển. - Giám sát độ trễ p90 và các chỉ số sử dụng GPU trong quá trình kiểm thử tải để định lượng lợi ích hiệu suất.
- Đóng góp cho dự án bằng cách phát triển các phần mở rộng mới cho các chiến lược định tuyến cụ thể hoặc loại phần cứng.
- Cung cấp phản hồi về các hạng mục lộ trình, chẳng hạn như pipeline adapter LoRA và hỗ trợ phục vụ tách rời (disaggregated serving).



