TPUでのOLMo 3 7B再現が、隠れたデータローダーのバグを明らかに
Googleのケーススタディでは、AI2のOLMo 3モデルをTPU上で再現し、性能指標を一致させると同時に、改善と誤認されていた重要なデータシャーディングエラーを発見しました。

英語の原文から自動翻訳されました。
2026年9月のGoogle Developers Blogの投稿で、エンジニアたちはGoogle Cloud TPU上のMaxTextを使用してAllen Institute for AIのOLMo 3 7B言語モデルを成功裏に再現した詳細を説明しました。チームは元の学習曲線および下流タスクベンチマークと一致する結果を出し、PyTorchベースのGPUレシピがJAXベースのTPU環境でも忠実に実行可能であることを証明しました。
何が起きたか
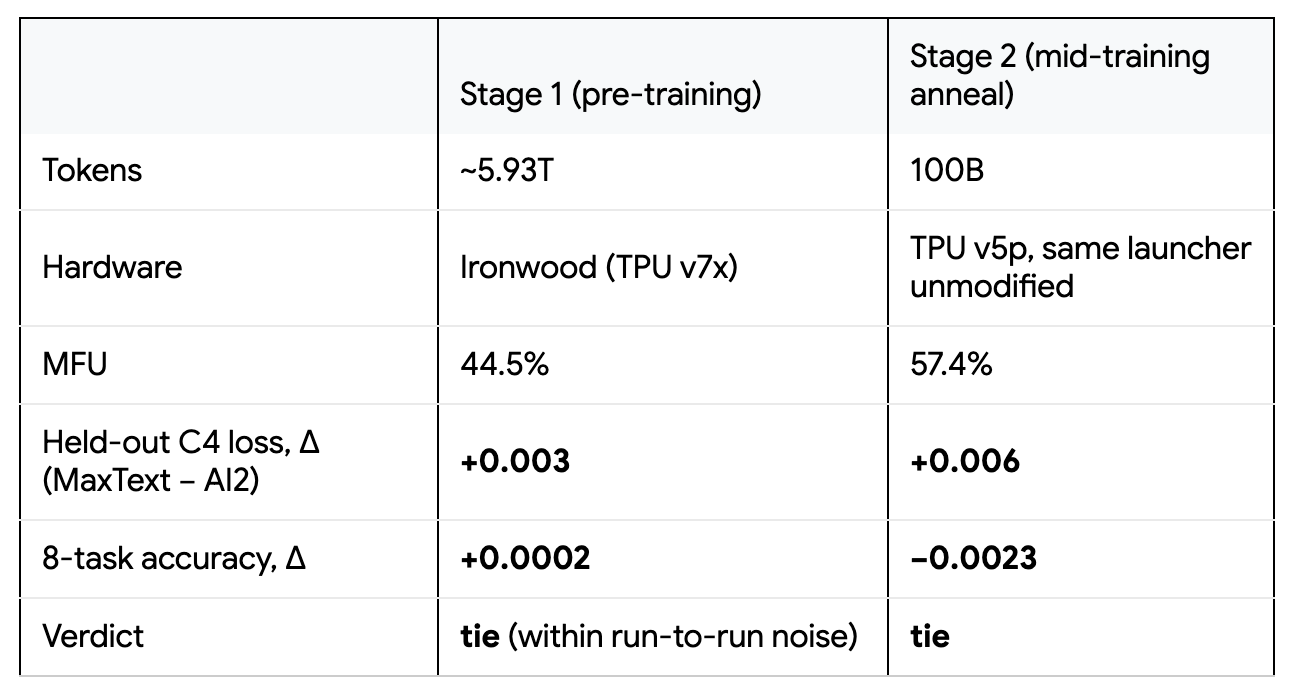
エンジニアリングチームは、TPUで大規模言語モデルを訓練するための高性能フレームワークであるMaxTextの能力を検証することを目指しました。彼らがOLMo 3を選んだのは、完全にオープンな重み、データ、および訓練レシピを持つ数少ないフロンティアクラスのモデルの一つだからです。この透明性により、損失曲線だけに頼るのではなく、独立した参照実行との厳密な比較が可能になりました。再現にはステージ1の事前学習とステージ2の中間学習アニーリングが含まれ、JAX用のOrbax形式に変換されたAI2のstep-0 PyTorchチェックポイントが使用されました。
結果は、MaxTextが全5.93兆トークンの予算にわたってAI2の公開済み損失曲線を追跡できることを示しました。しかし、プロセスには問題もありました。訓練の後半段階で、MaxTextの実行は参照よりも優れているように見え、訓練損失がAI2のレベルより大幅に低下しました。さらなる調査により、これはモデル品質の真の向上ではなく、データ読み込みバグによるアーティファクト(人工的な結果)であることが判明しました。チームはまた、ハードウェア容量の喪失後に訓練ジョブを途中でリサイズし、コアレシピを変更せずに訓練ステージ間でTPU世代を切り替えることで、システムの耐障害性を実証しました。
仕組み
忠実性を確保するために、チームはreordered-normブロック、QK-norm、およびスライディングウィンドウとグローバルアテンションの混合パターンなど、OLMo 3固有のアーキテクチャ選択をMaxTextに移植しました。変換の確認は、ログットパリティ(出力の一致)をチェックして行い、異なるフレームワーク間での期待されるノイズフロア内で変換後のモデルがHuggingFace参照と一致することを保証しました。データパイプラインはGrainを使用して再構築され、ランダムアクセス読み取り、グローバルインデックスシャッフル、n-gram繰り返しフィルタリングを実装することで、元のセットアップを正確に反映しました。
パフォーマンス最適化は、再現を実現する上で重要な役割を果たしました。チームはSparseCoreへの集合通信オフロードとリマテリアライゼーション戦略のチューニングにより、Ironwood TPUで44.5%のモデルFLOPS利用率(MFU)を達成しました。また、TPUの行列演算ユニットをより効率的に利用するためにアテンションヘッドの形状を変えるなど、共同設計の機会も探索し、品質を犠牲にすることなく訓練速度の向上をもたらしました。これらのエンジニアリング調整により、数週間にわたる訓練実行中にハードウェアリソースが動的に変化しても、システムはスループットを維持することができました。
主要な詳細
- 指標の一致: 再現されたモデルは、C4損失および8つの下流タスクを含むAI2のホールドアウト評価指標と一致し、精度の差異は±0.005を超えませんでした。
- データバグの発見: Grainデータローダーにおける二重シャーディングエラーによりデータインスタンスが重複し、汎化性能を向上させることなく訓練損失を最大0.25ポイントまで人為的に低下させました。
- ハードウェア耐障害性: 容量喪失後、訓練ジョブは元のサイズの四分の一のクラスタスライスで正常に再開し、デバイスあたりのスループットを1%以内で維持しました。
- フレームワーク変換: PyTorchの重みは約1.5e-3のKLダイバージェンスでOrbaxに変換され、初期化時にモデルが同一であることを確認しました。
- 簡略化されたレシピ: チームはAI2のステッチされた2つの曲線アプローチの代わりに単一の余弦学習率スケジュールを使用しましたが、同等の結果を達成しました。
なぜ重要か
大規模AIシステムを開発している開発者にとって、このケーススタディはモデル品質の代理指標として訓練損失のみを信頼することの危険性を浮き彫りにします。データ記憶によりMaxTextが参照を上回ったように見えた事例は、低い損失が必ずしも優れた性能を意味するわけではないという厳しい教訓を提供します。これは、通常であれば数週間気づかれずに放置される可能性のあるデータパイプライン内の微妙なバグを検出するために、厳格なホールドアウト評価と独立した検証ステップの必要性を強調しています。
さらに、成功した再現は、複雑で非標準的なトランスフォーマーアーキテクチャを処理するためのJAXおよびTPUエコシステムの成熟度を示しています。これは、PyTorch/GPUスタックからJAX/TPU環境への移行を検討しているチームに対する青写真を提供し、重大なアーキテクチャの違いがあっても忠実な再現が可能であることを示しています。訓練中にジョブのリサイズやハードウェア世代の切り替えが可能であることも、長時間実行されるクラウド訓練ジョブのコストと信頼性を管理するための実践的な洞察を提供します。
やれること
- 記憶やデータ漏洩を早期に検出するために、訓練損失の監視と並行して定期的なホールドアウト評価を実施してください。
- サイレントなデータの重複を防ぐために、マルチワーカー環境をシミュレートする単体テストでデータローダーのシャーディングロジックを検証してください。
- 訓練開始前に初期化の一貫性を保証するために、フレームワーク間のモデル変換時にログットパリティチェックを使用してください。
- プリエンプションが発生した場合に異なるハードウェアスライスでシームレスに再開できるように、動的なリソース変化に対応するように訓練スクリプトを設計してください。
- 一貫した能力成長を保証するために、訓練終了時だけでなく複数のチェックポイントで下流タスクの精度を比較してください。
- Grainなどの内部でシャーディングを処理する可能性があるライブラリを使用する場合、特に冗長なシャーディング操作がないかデータパイプライン設定を確認してください。



