Kubernetes、LLM推論ルーティング向けのGateway API拡張機能を導入
Kubernetesプロジェクトは、生成AIワークロードのルーティングを標準化し、レイテンシの削減とGPU利用率の向上を実現する「Gateway API Inference Extension」をリリースしました。

英語の原文から自動翻訳されました。
2025年6月のKubernetes Blogの投稿で、Solo.io、Google、Bytedanceからの貢献者が「Gateway API Inference Extension」を発表しました。この新しい標準化された拡張機能は、既存のGateway APIフレームワークに推論対応機能を追加することで、セルフホスト型大規模言語モデル(LLM)特有のトラフィックルーティング課題に対処します。
何が起きたのか
現代の生成AIサービスは、従来のWebアプリケーションとは大きく異なります。標準的なHTTPリクエストは短命かつステートレスであることが多い一方、LLM推論セッションは長時間実行され、リソース集約的であり、部分的にステートフルです。単一のGPUバックエンドモデルサーバーは、アクティブな推論セッションを維持し、トークンキャッシュをメモリに保持する場合があります。単純なHTTPパスマッチングやラウンドロビン分散に依存する従来のロードバランサーは、これらの複雑なワークロードを効果的に処理するために必要な専門的なロジックを備えていません。モデルの識別子やリクエストの重要度(インタラクティブなチャットセッションとバックグラウンドのバッチジョブの区別など)も考慮しません。
これを解決するため、コミュニティは「Gateway API Inference Extension」を開発しました。このプロジェクトは、慣れ親しんだGateway APIモデルに基づいており、プラットフォームエンジニアが標準ゲートウェイを「Inference Gateway」に変換できるようにします。目的は、アドホックなカスタムソリューションから脱却し、エコシステム全体で推論ワークロードをルーティングするための標準的なアプローチを提供することです。モデル認識型のルーティングを有効にし、リクエストごとの重要度をサポートすることで、この拡張機能はレイテンシの削減と、GPUなどのアクセラレーターの利用最適化を目指しています。
仕組み
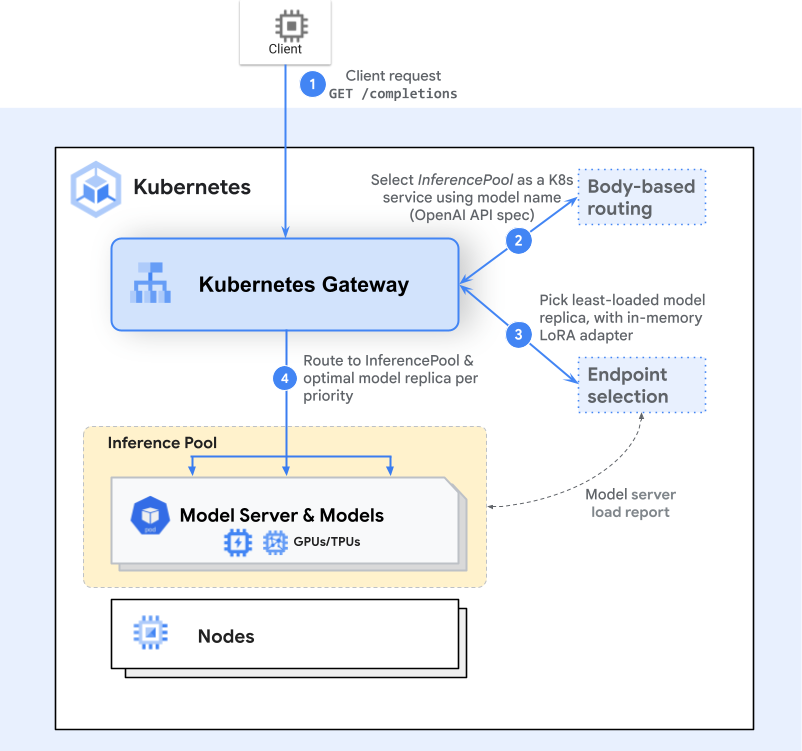
アーキテクチャでは、プラットフォームオペレーターとAI/MLオーナー間の関心事を分離するために、2つの新しいカスタムリソース定義(CRD)を導入しています。1つ目のInferencePoolは、共有計算リソース上でモデルサーバーを実行するポッドのグループを定義します。プラットフォーム管理者はこのリソースを使用して、デプロイメント、スケーリング、負荷分散ポリシーを設定し、クラスター全体で一貫したリソース使用率を保証します。これはKubernetes Serviceと同様に機能しますが、モデルサービングプロトコルを特に認識している点が異なります。
2つ目のリソースInferenceModelは、AI/MLチームによって管理されます。「gpt-4-chat」などの公開エンドポイント名を、InferencePool内の特定のモデルにマッピングします。これにより、ワークロードオーナーは提供されるモデル(ファインチューニング変種を含む)を定義し、トラフィック分割や優先順位付けポリシーを設定できます。この分離により、プラットフォームチームはインフラストラクチャを管理し、アプリケーションチームはモデルの公開を管理することが保証されます。
クライアントがリクエストを送信すると、ゲートウェイはHTTPRouteを調べて対象のInferencePoolを特定します。ゲートウェイは任意の利用可能なポッドへトラフィックを転送する代わりに、Endpoint Selection Extensionを参照します。このコンポーネントは、キュー長、メモリ使用量、読み込まれたアダプターなど、ポッドからのライブメトリクスを分析します。その後、リアルタイムの条件に基づいて最適なポッドを選択し、リクエストが可能な限り低いレイテンシまたは最高の効率で処理されるようにします。このプロセスはクライアントに対して透過的であり、標準的な単一のリクエストとして見えます。
主要な詳細
- 2つの新しいCRD: プラットフォームレベルのリソース管理用
InferencePoolと、ユーザー向けモデルエンドポイント用InferenceModel。 - Endpoint Selection Extension: シンプルなラウンドロビンを置き換え、キュー深度やメモリ状態を考慮したメトリクス認識型ルーティングを採用。
- ベンチマーク環境: テストには、H100 (80 GB) GPUポッド上のvLLMバージョン1と、10個のLlama2レプリカを使用。
- レイテンシ改善: この拡張機能は、高負荷時(500+ QPS)において、標準的なKubernetes Serviceと比較してp90レイテンシが大幅に低下することを示しました。
- スループット同等性: 100〜1000 Queries per Secondのテスト範囲において、スループットは標準サービスと比較して同等でした。
- 拡張可能な設計: フレームワークは、新しいルーティング戦略や特殊なハードウェアニーズのための追加拡張をサポートしています。
なぜ重要なのか
AI製品を開発するエンジニアリングチームにとって、この拡張機能はより信頼性が高く効率的なセルフホスト型モデルサービングへの道を提供します。静的ルールではなくリアルタイムのポッドメトリクスに基づいてリクエストをルーティングすることで、組織はGPUメモリが飽和に近づいた際に発生するホットスポットを回避できます。これによりテールレイテンシが予測可能になり、インタラクティブなアプリケーションでのスムーズなユーザー体験の維持に不可欠です。重要度に基づくトラフィックの優先順位付け機能により、高価値なインタラクションが低優先度のバッチプロセスによってブロックされないことも保証されます。
運用面では、標準化によりカスタムルーティングロジックのメンテナンス負担が軽減されます。プラットフォームチームはネイティブのKubernetesツールを使用して、異なるモデルやチーム間で一貫したポリシーを適用できます。プロジェクトが一般提供(GA)に向かうにつれて、プレフィックスキャッシュ認識型負荷分散や異種アクセラレーターのサポートなどの機能がその有用性をさらに高めるでしょう。Kubernetesネイティブツールとの整合性は、GenAIサービスを既存のインフラストラクチャに統合するプロセスを簡素化します。
できること
- 公式プロジェクトドキュメントを確認し、API仕様とインストール要件を理解してください。
- 非本番環境にテスト用のInference Gatewayをデプロイし、Endpoint Selection Extensionを評価してください。
- 既存のモデルサービスを
InferencePoolおよびInferenceModelリソースにマッピングし、移行パスをテストしてください。 - 負荷テスト中にp90レイテンシとGPU利用率メトリクスを監視し、パフォーマンスの向上を定量化してください。
- 特定のルーティング戦略やハードウェアタイプ向けの新しい拡張機能を開発することで、プロジェクトに貢献してください。
- LoRAアダプターパイプラインやディスアグリゲートドサービングサポートなどのロードマップ項目についてフィードバックを提供してください。



