Google、TPU上での自律型LLMファインチューニングループを実証
Google Developers Blogは、Cloud TPU上のSFTおよびRLポストトレーニングにおけるハイパーパラメータ調整を自動化するエージェント駆動システム「autofinetune」の詳細を紹介しています。

英語の原文から自動翻訳されました。
2026年9月のGoogle Developers Blogの投稿で、エンジニアたちは「autofinetune」と呼ばれる大規模言語モデル最適化の新手法について説明しました。このシステムは自律型AIエージェントを使用し、教師ありファインチューニング(SFT)と強化学習(RL)の反復的なサイクルを管理します。人間の継続的な監督なしに、GoogleのCloud TPUs上で実験を実行します。
何が起きたか
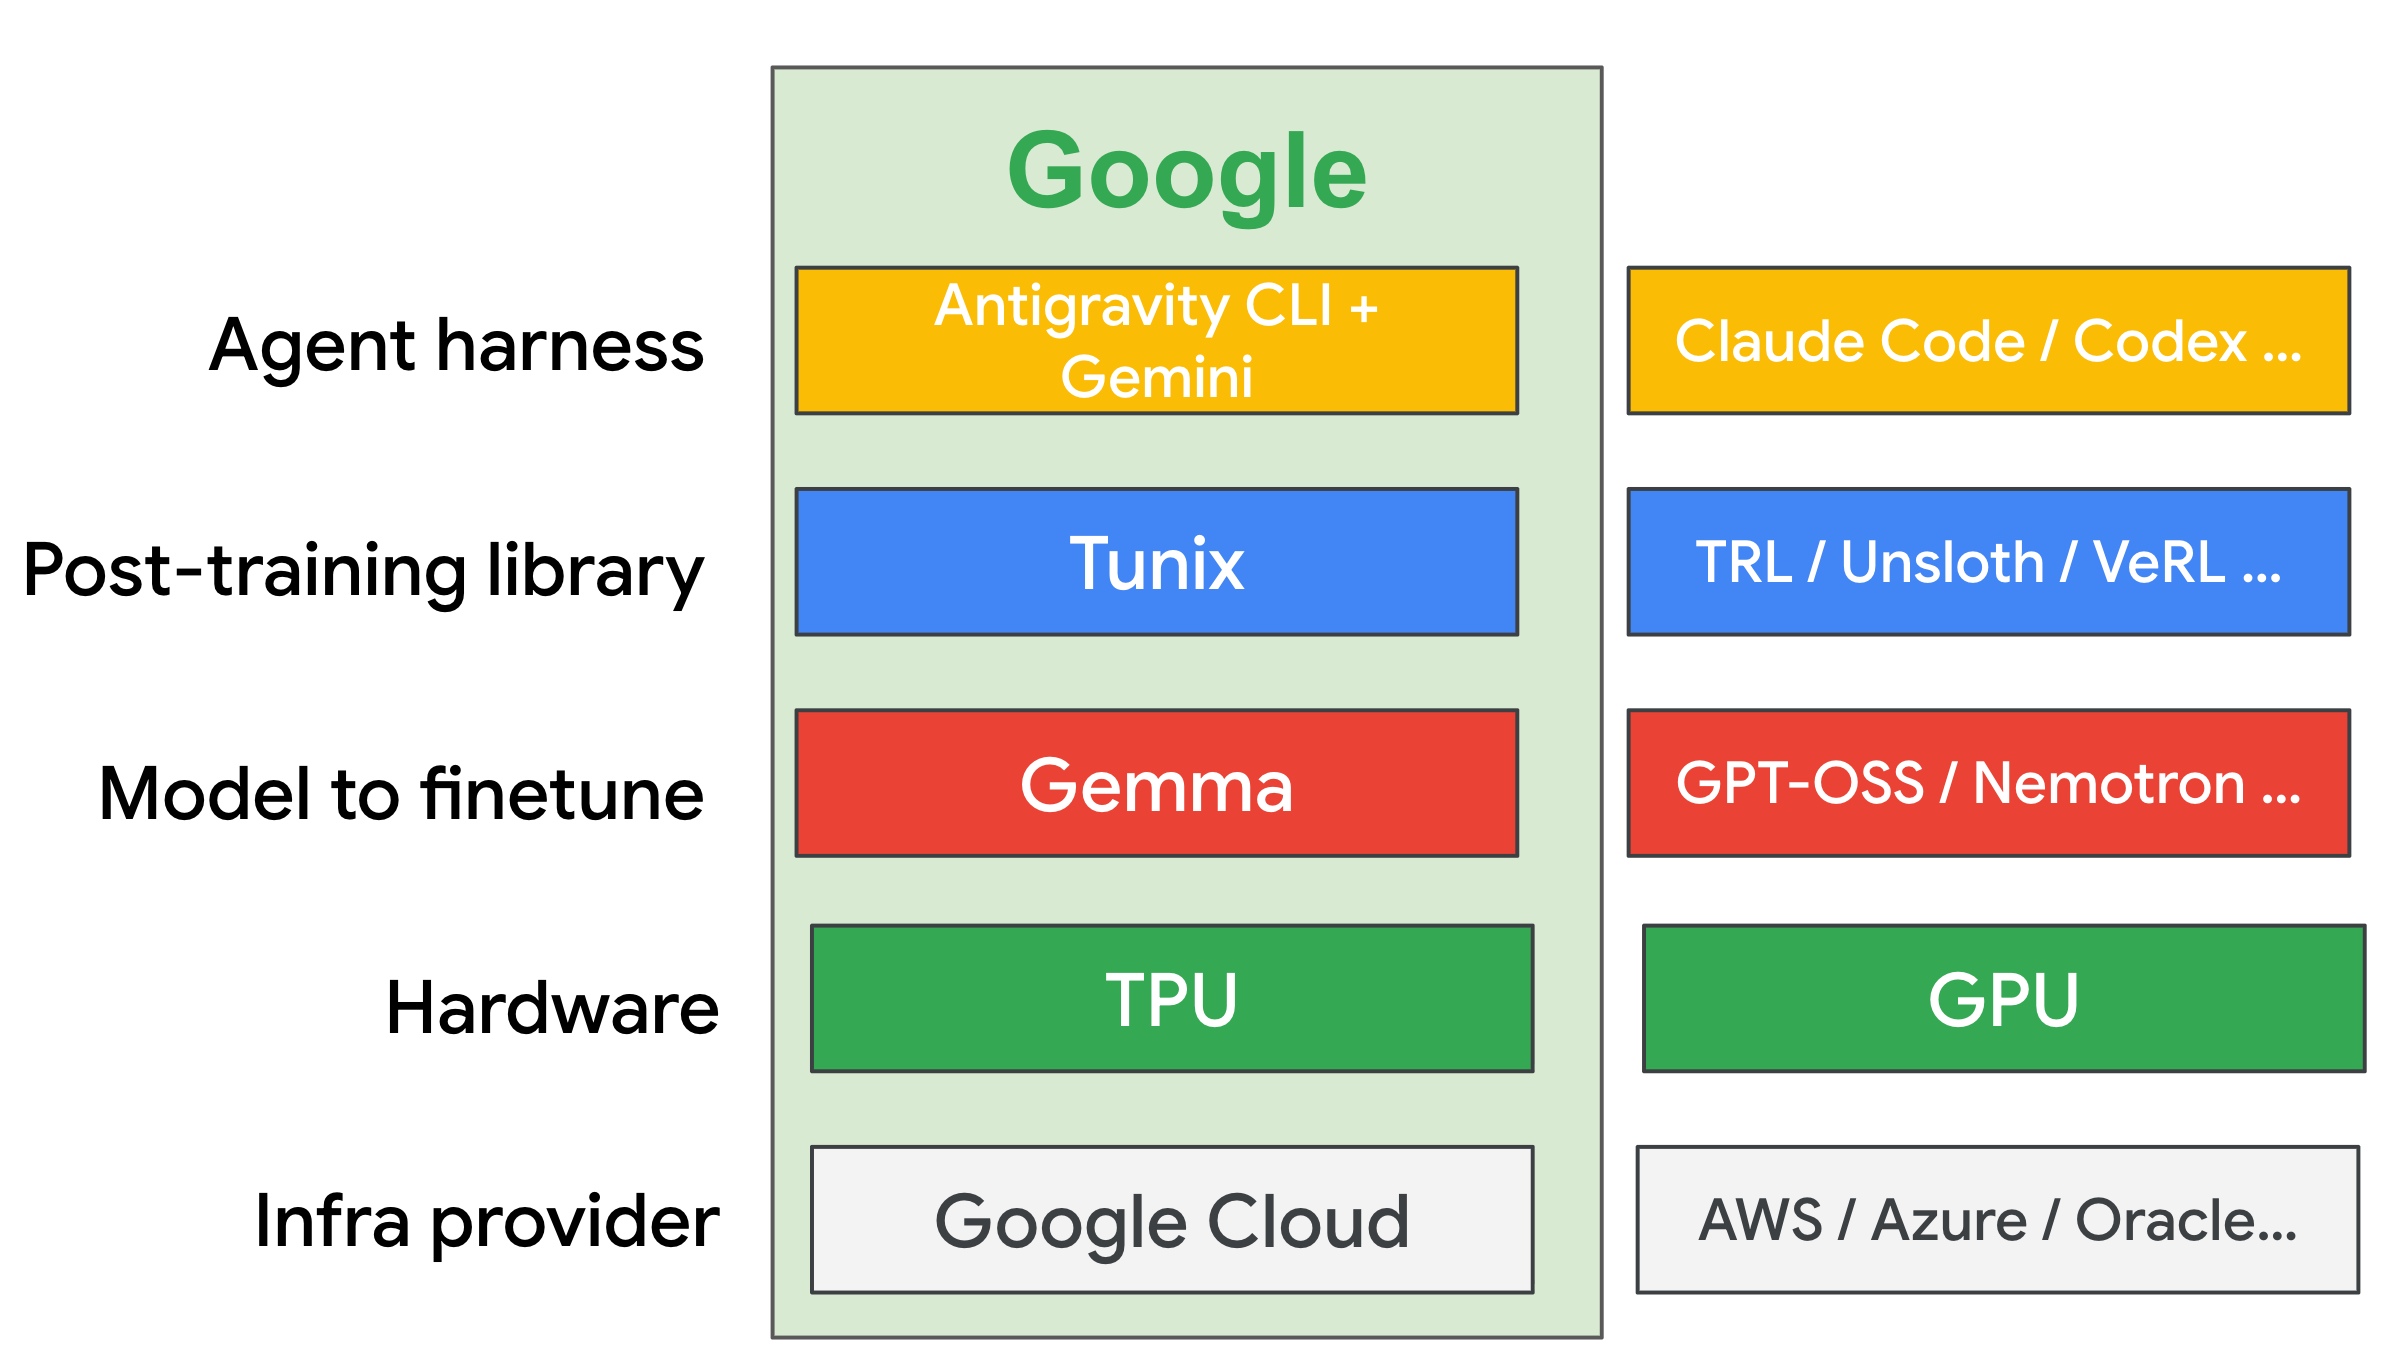
従来のポストトレーニングワークフローでは、開発者が手動で変更点を仮説立て、スクリプトを編集し、ジョブを開始し、結果を監視する必要がありました。このプロセスは遅く、ヒューマンエラーが発生しやすいものでした。新しいautofinetuneプロジェクトは、Tunix、Gemmaモデル、Cloud TPUsを含むGoogleの完全なAIスタックを活用し、Antigravity CLIとGemini Flash 3.7によってオーケストレーションすることで、このループ全体を自動化します。目標は、エンジニアが高レベルの制約条件を定義し、エージェントが一晩で最適な構成を発見できるようにすることです。
チームは、2つの異なるケーススタディを通じてこの能力を実証しました。1つ目は、google/mobile-actionsデータセットを使用してgoogle/functiongemma-270m-itモデルを用いた教師ありファインチューニング(SFT)に焦点を当てたものです。単一のCloud TPU v5e上で実行され、エージェントはわずか数時間で20回の自動実験を実施しました。データセットとアーキテクチャを固定したまま、LoRAランク、学習率、オプティマイザーなどの変数を調整しました。エージェントはこれらのパラメータを反復的に改善することで、関数呼び出し生成の精度向上に成功しました。
2つ目のケーススタディは、より複雑で不安定な訓練手法であるグループ相対ポリシー最適化(GRPO)による強化学習に取り組みました。GSM8K数学推論データセット上のGemma 3 1Bを使用し、エージェントはCloud TPU v6e上で2〜3日間かけて40回の実験を実行しました。長いイテレーション時間とRLの感度にもかかわらず、エージェントはより良いLoRA構成とロールアウト温度を特定しました。その結果、数値精度とフォーマット精度を組み合わせた指標で約10%の改善が得られました。
仕組み
このシステムは、手動チューニングから自律型研究ループへのパラダイムシフトに基づいて動作します。人間は、境界条件、評価基準、制約を設定するprogram.mdファイルを作成してアリーナ(競技場)を定義します。また、自己完結型のクリーンな実行スクリプトrun.pyも提供します。その後、AIエージェントが引き継ぎ、program.md内の指示を読み取ってrun.pyを変更し、訓練ジョブを開始し、ターゲット指標を測定します。
実験が改善をもたらした場合、エージェントは変更をGitにコミットし、結果をresults.tsvファイルに記録します。変更が退歩を引き起こした場合は、エージェントがそれを元に戻します。このクローズドループシステムにより、手動介入なしにパフォーマンス向上に向けた連続的な山登り探索が可能になります。エージェントは、許容されるオプティマイザーやバッチサイズなど定義された探索空間を探求しつつ、コアモデルアーキテクチャの変更など禁止された変更には従います。
主要な詳細
- プロジェクトは、Antigravity CLIとGemini Flash 3.7でオーケストレーションされたGoogleのTunixライブラリ、Gemmaモデル、Cloud TPUsを使用しています。
- SFTケーススタディでは、エージェントはCloud TPU v5e-1上で数時間以内に20回の実験を実行し、LoRAランクと学習率を最適化しました。
- GRPOケーススタディでは、エージェントはCloud TPU v6e-1上で2〜3日間にわたり40回の実験を実施し、総報酬を約10%改善しました。
- 人間のオペレーターは
program.mdで制約を定義し、バッチサイズなどの許可されたパラメータや、データセットのスワップなどの禁止された変更を指定します。 - エージェントはバージョン管理を自動的に処理し、成功した構成をGitにコミットするとともに、メトリクスを
results.tsvに記録します。 - RL実験の目的指標は、数値精度とフォーマット精度の単純な合計でした。
なぜ重要なのか
AI製品を開発するソフトウェアチームにとって、ボトルネックはしばしばモデルアーキテクチャではなく、ハイパーパラメータチューニングという面倒なプロセスにあります。手動での実験はリソース集約的で、スケールさせるのが困難です。このループを自動化することで、エンジニアは損失曲線の監視やスプレッドシートの管理に費やしていた時間を回収できます。この転換により、チームは訓練実行の機械的な側面ではなく、高レベルの問題定義やデータ品質に集中できるようになります。
さらに、自律型エージェントは、疲労や時間の制約により人間が試みるよりも徹底的に構成空間を探求できます。一晩で数十回の実験を実行できる能力は、より速いイテレーションサイクルと、場合によってはより高性能なモデルにつながります。これは特に、不安定性のため手動チューニングが特に難しい強化学習において価値があります。Gitなどの既存ツールとの統合により、成功した実験が追跡可能かつ再現性のある状態に保たれ、エンジニアリングの厳密性が維持されます。
あなたができること
autofinetuneGitHubリポジトリを確認し、チームが提供するコード、サンプル実行、program.mdテンプレートにアクセスしてください。- 自動化を試みる前に、独自のファインチューニングタスクに対して明確な境界条件と評価指標を定義してください。
- エージェントが訓練スクリプトとどのように相互作用するかを理解するために、シンプルな教師ありファインチューニング実験から始めてください。
- ケーススタディで説明されているハードウェア環境を再現するために、TunixライブラリとCloud TPUsを使用してください。
results.tsvログを監視し、エージェントの意思決定プロセスを理解するとともに、成功した構成のパターンを特定してください。program.md内の異なる制約セットを実験し、探索速度と計算コストのバランスを取ってください。



