AIコーディングエージェントの評価には、行動評価がより明確な洞察を提供
Google Developers Blogは、AIエージェント開発において、不透明なエンドツーエンドのベンチマークスコアを超え、行動評価がどのように実用的なフィードバックを提供するかを解説しています。

英語の原文から自動翻訳されました。
2026年9月のGoogle Developers Blogの投稿で、エンジニアたちはチームがAIコーディングエージェントを評価する方法の変革について説明しました。記事では、エンドツーエンドのベンチマークからの複合的なスコアだけに頼ると、パフォーマンスの変化の原因を開発者が診断できなくなることが多いと主張しています。その代わりに、エージェントのワークフロー内の具体的で観察可能な行動を追跡する「行動評価」を推奨しています。
何が起きたか
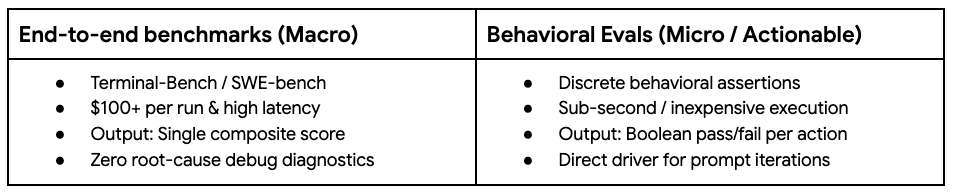
エージェント型コーディングシステムを開発している開発者は、よくある不満に直面します。Terminal-BenchやDeepSWEなどの標準的なベンチマークを実行すると、スコアがわずかに変動することがあります。これらのエンドツーエンドテストは高レベルのパフォーマンス追跡には有用ですが、リグレッション(機能退化)や改善の根本原因を説明しません。スコアが低下した場合、モデルが過度に自信過剰になったのか、テストスイートの検証を忘れたのか、コマンドラインフラグを幻覚(ハルシネーション)したのかは不明のままです。この可視性の欠如により、反復的な改善が高コストかつ遅くなります。
提案されている解決策は、行動評価をエージェントハーネスの統合テストとして扱うことです。エージェントが複雑な複数ファイルのリファクタリングを成功裏に完了したかどうかだけ測定するのではなく、これらの評価は途中の離散的なステップを確認します。例えば、曖昧なプロンプトに直面した際、エージェントは明確化のための質問を行いますか? ビルドファイルを変更する前にローカルバリデータを起動しますか? これらの中間的な行動に焦点を当てることで、チームは期待される振る舞いのベースラインを作成し、プロンプトの反復作業をより確信を持って行うことができます。
記事では、評価ハーネスが開発の最初のステップであってはならないことを強調しています。初期段階では、開発者の直感とドッグフーディング(自社製品の使用)に頼るべきであり、エージェントが自社のコードベース内で定型文やルーチンタスクを処理するために使用されます。評価は第2段階で重要になり、リグレッションに対するガードレールとして機能します。主な役割は、わずかな向上を称賛することではなく、プロンプト、ツールスキーマ、または基盤となるモデルへの変更が、エージェントの全体的な信頼性を損なわないことを保証することです。
仕組み
堅牢な行動評価アーキテクチャは、ローカルで実行される高速かつ決定論的なチェックにアサーション(検証)を分離します。これらのテストは、最終的な出力文字列ではなく、特定のツール呼び出しやファイル変更など、中間的な実行ステップに焦点を当てます。このアプローチにより、開発者はエージェントハーネスを標準ソフトウェアのように扱い、迅速な反復中の安定性を確保するために単体テストおよび統合テストの原則を適用できます。
例えば、Antigravity SDKを使用する場合、現在の天気条件について尋ねられた際に、内部メモリに依存するのではなく、エージェントがWeb検索ツールを使用することをテストでアサートできます。テストはインタラクション中に作成されたツール呼び出しのリストを確認し、正しい外部リソースが参照されたことを保証します。この方法は、プロンプトの調整によって必要な行動が誤って削除された場合に即座にフィードバックを提供し、CI/CDスタイルのガードレールとして機能します。
効果的なスイートを構築するために、記事では3つのステップからなるループを開始することを提案しています。第一に、単体テストの実行忘れなど、単一の失敗モードを特定します。第二に、タスクの複雑さに基づいて柔軟なアサーションを作成し、単純なタスクには厳格なチェックを、複雑なタスクには結果に基づく判断を使用します。最後に、バッチ評価を自動化して時間の経過に伴う安定性を監視し、AIモデルの非決定論的な性質を考慮して集計パス率を追跡します。
主要な詳細
- Terminal-BenchやDeepSWEなどのエンドツーエンドベンチマークは最終的な成功を測定しますが、パフォーマンス変化の理由は説明しません。
- 行動評価は統合テストとして機能し、明確化質問の提起やバリデータの起動など、特定の中間的な行動を確認します。
- 開発はドッグフーディングと直感から始めるべきであり、エージェントが基本的なタスクを処理できるようになってから正式な評価を導入します。
- 評価スイートの主な目標は、プロンプト、ツール、またはモデルの変更時にリグレッションを防ぐことです。
- Antigravity SDKの例を用い、テストは最終的なテキスト出力だけでなく、ツール呼び出しと実行ステップに対してアサートすべきです。
- バッチ評価は、単一のノイズの多い実行でブロックするのではなく、集計トレンドを追跡することで、モデルの非決定論性を管理するのに役立ちます。
なぜ重要なのか
ソフトウェアエンジニアや技術リードにとって、このアプローチはAIエージェントの反復コストを削減します。行動に関する洞察がない場合、チームはモデルのパフォーマンスがなぜ低下したのか推測することに時間を無駄にし、多くの場合、新しいエラーを導入する可能性のある盲動的な調整につながります。特定の行動を分離することで、開発者はどの機能がテストされているかを正確に把握しながら、システムプロンプトやツール設定に対してターゲットを絞った変更を行うことができます。この精度は開発サイクルを加速し、デプロイされたエージェントの信頼性を向上させます。
さらに、エージェントハーネスを標準的なソフトウェアコンポーネントとして扱うことは、より良いエンジニアリング慣行を奨励します。これは、モデルを試験に合格させるために説得しなければならないブラックボックスとして見る見方から、明確な安全ネットを持つ回復力のあるシステムを構築する方向へと分野を転換させます。 unchecked hallucinations(未検証の幻覚)やスキップされた検証ステップが本番環境で重大な結果をもたらす可能性があるため、エージェントがより複雑な責任を引き受けるようになるにつれ、この変革は不可欠です。
あなたができること
- テスト実行のスキップなど、エージェントにおける最近の失敗モードを1つ特定し、新しい行動テストの対象としてください。
- 最終的な出力のみを検証するのではなく、特定のツール呼び出しや中間ステップを確認するアサーションを作成してください。
- 単純なタスクには厳格な単一ターンアサーションから始め、複雑なマルチパスシナリオにはLLM-as-a-judge(大規模言語モデルによる判定)を使用してください。
- モデルの非決定論性によるノイズを平滑化するために、時間の経過に伴う集計パス率を追跡するバッチ評価を自動化してください。
- プロンプトの更新やモデルの切り替え時には、主にリグレッション防止のガードレールとして評価を使用してください。
- ドッグフーディングによりエージェントが基本的なタスクを処理できることが証明されるまで、複雑な評価ハーネスの構築を延期してください。



