Las evaluaciones conductuales ofrecen información más clara para los agentes de codificación con IA
El blog de Google Developers explica cómo las evaluaciones conductuales proporcionan comentarios accionables para el desarrollo de agentes de IA, superando las puntuaciones opacas de los benchmarks de extremo a extremo.

Traducido automáticamente del original en inglés.
En una publicación en el blog de Google Developers en septiembre de 2026, los ingenieros describieron un cambio en la forma en que los equipos deben evaluar los agentes de codificación con IA. El artículo sostiene que depender exclusivamente de las puntuaciones compuestas de los benchmarks de extremo a extremo a menudo deja a los desarrolladores sin poder diagnosticar por qué ocurren cambios en el rendimiento. En su lugar, aboga por evaluaciones conductuales que rastreen acciones específicas y observables dentro del flujo de trabajo del agente.
Qué sucedió
Los desarrolladores que construyen sistemas de codificación agénticos se enfrentan frecuentemente a una frustración común: ejecutan benchmarks estándar como Terminal-Bench o DeepSWE y ven fluctuar sus puntuaciones por márgenes pequeños. Si bien estas pruebas de extremo a extremo son útiles para el seguimiento general del rendimiento, no explican la causa raíz de las regresiones o mejoras. Cuando una puntuación baja, sigue siendo poco claro si el modelo se volvió demasiado confiado, olvidó verificar las suites de pruebas o alucinó banderas de línea de comandos. Esta falta de visibilidad hace que la mejora iterativa sea costosa y lenta.
La solución propuesta es tratar las evaluaciones conductuales como pruebas de integración para el arnés del agente. En lugar de medir solo si un agente completa con éxito una refactorización compleja de múltiples archivos, estas evaluaciones verifican pasos discretos en el camino. Por ejemplo, ¿el agente hace preguntas aclaratorias cuando se enfrenta a prompts ambiguos? ¿Ejecuta un validador local antes de modificar los archivos de compilación? Al centrarse en estos comportamientos intermedios, los equipos pueden crear una línea base de conducta esperada e iterar sobre los prompts con mayor confianza.
El artículo enfatiza que los arneses de evaluación no deberían ser el primer paso en el desarrollo. Las fases iniciales deberían depender del instinto del desarrollador y del dogfooding, donde el agente se utiliza para manejar tareas repetitivas o rutinarias dentro de su propio código base. Las evaluaciones se vuelven críticas en la segunda fase, sirviendo como barreras de protección contra regresiones. Su rol principal no es celebrar pequeñas ganancias, sino asegurar que los cambios en los prompts, esquemas de herramientas o modelos subyacentes no degraden la confiabilidad general del agente.
Cómo funciona
Una arquitectura robusta de evaluación conductual separa las aserciones en comprobaciones rápidas y deterministas que se ejecutan localmente. Estas pruebas se centran en pasos de ejecución intermedios, como llamadas específicas a herramientas o modificaciones de archivos, en lugar de cadenas de salida finales. Este enfoque permite a los desarrolladores tratar el arnés del agente como software estándar, aplicando principios de pruebas unitarias y de integración para garantizar la estabilidad durante la iteración rápida.
Por ejemplo, usando el SDK de Antigravity, una prueba podría afirmar que un agente usa una herramienta de búsqueda web cuando se le pregunta sobre las condiciones climáticas actuales, en lugar de depender de la memoria interna. La prueba revisa la lista de llamadas a herramientas realizadas durante la interacción, asegurando que se consultó el recurso externo correcto. Este método proporciona retroalimentación inmediata si un ajuste del prompt elimina accidentalmente un comportamiento necesario, actuando como una barrera de protección estilo CI/CD.
Para construir una suite efectiva, el artículo sugiere comenzar con un ciclo de tres pasos. Primero, identificar un único modo de fallo, como olvidar ejecutar pruebas unitarias. Segundo, escribir aserciones flexibles basadas en la complejidad de la tarea, utilizando comprobaciones estrictas para tareas simples y juicios basados en resultados para las complejas. Finalmente, automatizar evaluaciones por lotes para monitorear la estabilidad con el tiempo, rastreando tasas de aprobación agregadas para tener en cuenta la naturaleza no determinista de los modelos de IA.
Detalles clave
- Los benchmarks de extremo a extremo como Terminal-Bench y DeepSWE miden el éxito final pero no explican por qué cambian los rendimientos.
- Las evaluaciones conductuales actúan como pruebas de integración, verificando acciones intermedias específicas como hacer preguntas aclaratorias o ejecutar validadores.
- El desarrollo debe comenzar con dogfooding e instinto, introduciendo evaluaciones formales solo después de que el agente pueda manejar tareas básicas.
- El objetivo principal de una suite de evaluación es prevenir regresiones al cambiar prompts, herramientas o modelos.
- Las pruebas deben afirmar sobre llamadas a herramientas y pasos de ejecución, no solo sobre la salida de texto final, usando ejemplos del SDK de Antigravity.
- Las evaluaciones por lotes ayudan a gestionar la no determinación del modelo rastreando tendencias agregadas en lugar de bloquearse en ejecuciones individuales ruidosas.
Por qué importa
Para los ingenieros de software y líderes técnicos, este enfoque reduce el costo de iterar sobre agentes de IA. Sin información conductual, los equipos pierden tiempo adivinando por qué bajó el rendimiento de un modelo, lo que a menudo conduce a ajustes ciegos que pueden introducir nuevos errores. Al aislar comportamientos específicos, los desarrolladores pueden realizar cambios dirigidos en los prompts del sistema o configuraciones de herramientas, sabiendo exactamente qué capacidad está siendo probada. Esta precisión acelera los ciclos de desarrollo y mejora la confiabilidad de los agentes desplegados.
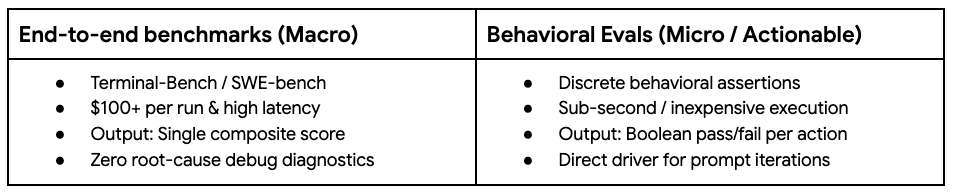
Además, tratar los arneses de agentes como componentes de software estándar fomenta mejores prácticas de ingeniería. Aleja al campo de ver los modelos como cajas negras que deben ser persuadidas para aprobar exámenes, y hacia la construcción de sistemas resilientes con redes de seguridad claras. Este cambio es esencial a medida que los agentes asumen responsabilidades más complejas, donde alucinaciones no controladas o pasos de verificación omitidos pueden tener consecuencias significativas en entornos de producción.
Qué puedes hacer
- Identifica un modo de fallo reciente en tu agente, como saltarse ejecuciones de pruebas, y dirígelo para una nueva prueba conductual.
- Escribe aserciones que verifiquen llamadas específicas a herramientas o pasos intermedios en lugar de validar solo la salida final.
- Comienza con aserciones estrictas de un solo turno para tareas simples, y usa LLM-as-a-judge para escenarios complejos y multipath.
- Automatiza evaluaciones por lotes para rastrear tasas de aprobación agregadas con el tiempo, suavizando el ruido de la no determinación del modelo.
- Usa las evaluaciones principalmente como barreras de protección contra regresiones al actualizar prompts o cambiar modelos.
- Retrasa la construcción de arneses de evaluación complejos hasta después de que el dogfooding inicial demuestre que el agente puede manejar tareas básicas.



