Đánh giá hành vi mang lại cái nhìn rõ ràng hơn cho các tác nhân AI lập trình
Google Developers Blog mô tả cách các đánh giá hành vi cung cấp phản hồi có thể hành động được cho việc phát triển tác nhân AI, vượt ra ngoài các điểm số benchmark end-to-end khó hiểu.

Được dịch tự động từ bản gốc tiếng Anh.
Trong một bài đăng trên Google Developers Blog vào tháng 9 năm 2026, các kỹ sư đã mô tả sự thay đổi trong cách các nhóm nên đánh giá các tác nhân AI lập trình. Bài viết lập luận rằng việc chỉ dựa vào điểm tổng hợp từ các benchmark end-to-end thường khiến nhà phát triển không thể chẩn đoán nguyên nhân dẫn đến những thay đổi về hiệu suất. Thay vào đó, bài viết ủng hộ các đánh giá hành vi theo dõi những hành động cụ thể, có thể quan sát được trong quy trình làm việc của tác nhân.
Điều gì đã xảy ra
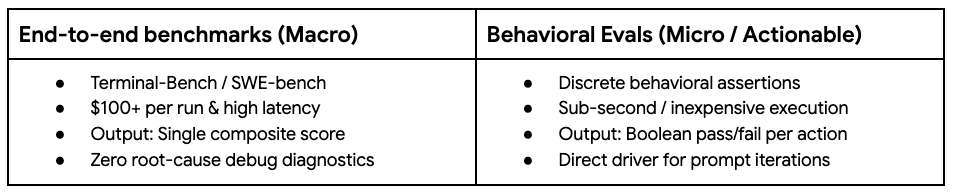
Các nhà phát triển xây dựng hệ thống lập trình dạng tác nhân (agentic coding) thường gặp phải một vấn đề phổ biến: họ chạy các benchmark tiêu chuẩn như Terminal-Bench hoặc DeepSWE và thấy điểm số dao động với biên độ nhỏ. Mặc dù các bài kiểm tra end-to-end này hữu ích cho việc theo dõi hiệu suất ở mức độ cao, chúng không giải thích được nguyên nhân gốc rễ của các lỗi suy giảm (regression) hoặc cải thiện. Khi điểm số giảm, vẫn chưa rõ liệu mô hình trở nên quá tự tin, quên xác minh bộ test suite, hay ảo giác (hallucinate) các cờ dòng lệnh. Sự thiếu minh bạch này khiến việc cải tiến lặp đi lặp lại trở nên tốn kém và chậm chạp.
Giải pháp được đề xuất là coi các đánh giá hành vi như các bài kiểm tra tích hợp (integration tests) cho khung chứa tác nhân (agent harness). Thay vì chỉ đo lường xem tác nhân có hoàn thành thành công một cuộc refactor phức tạp đa tệp hay không, các đánh giá này kiểm tra những bước rời rạc dọc theo quy trình. Ví dụ, tác nhân có đặt câu hỏi làm rõ khi đối mặt với các prompt mơ hồ không? Nó có chạy một validator cục bộ trước khi sửa đổi các tệp build không? Bằng cách tập trung vào các hành vi trung gian này, các nhóm có thể tạo ra một đường cơ sở (baseline) cho hành vi mong đợi và lặp lại các prompt với sự tự tin cao hơn.
Bài viết nhấn mạnh rằng khung đánh giá (evaluation harnesses) không nên là bước đầu tiên trong quá trình phát triển. Các giai đoạn ban đầu nên dựa vào trực giác của nhà phát triển và dogfooding, nơi tác nhân được sử dụng để xử lý các mẫu code boilerplate hoặc các nhiệm vụ thường xuyên trong chính codebase của nó. Việc đánh giá trở nên quan trọng ở giai đoạn thứ hai, đóng vai trò như rào chắn chống lại các lỗi suy giảm. Vai trò chính của chúng không phải là ăn mừng những cải thiện nhỏ mà là đảm bảo rằng các thay đổi đối với prompt, schema công cụ hoặc mô hình nền tảng không làm giảm độ tin cậy tổng thể của tác nhân.
Cách thức hoạt động
Một kiến trúc đánh giá hành vi vững chắc tách biệt các assertion thành các kiểm tra nhanh, xác định (deterministic) chạy cục bộ. Các bài kiểm tra này tập trung vào các bước thực thi trung gian, chẳng hạn như các lệnh gọi công cụ cụ thể hoặc sửa đổi tệp, thay vì chuỗi đầu ra cuối cùng. Cách tiếp cận này cho phép các nhà phát triển đối xử với khung chứa tác nhân giống như phần mềm tiêu chuẩn, áp dụng các nguyên tắc kiểm thử đơn vị (unit testing) và kiểm thử tích hợp để đảm bảo tính ổn định trong quá trình lặp nhanh.
Ví dụ, khi sử dụng Antigravity SDK, một bài kiểm tra có thể assert rằng tác nhân sử dụng công cụ tìm kiếm web khi được hỏi về điều kiện thời tiết hiện tại, thay vì dựa vào bộ nhớ nội tại. Bài kiểm tra xem xét danh sách các lệnh gọi công cụ được thực hiện trong tương tác, đảm bảo tài nguyên bên ngoài chính xác đã được tham khảo. Phương pháp này cung cấp phản hồi ngay lập tức nếu một điều chỉnh prompt vô tình loại bỏ một hành vi cần thiết, hoạt động như một rào chắn kiểu CI/CD.
Để xây dựng một bộ kiểm tra hiệu quả, bài viết gợi ý bắt đầu bằng một vòng lặp ba bước. Thứ nhất, xác định một chế độ thất bại (failure mode) duy nhất, chẳng hạn như quên chạy unit tests. Thứ hai, viết các assertion linh hoạt dựa trên độ phức tạp của nhiệm vụ, sử dụng các kiểm tra nghiêm ngặt cho các nhiệm vụ đơn giản và phán quyết dựa trên kết quả cho các nhiệm vụ phức tạp. Cuối cùng, tự động hóa các đánh giá hàng loạt để giám sát tính ổn định theo thời gian, theo dõi tỷ lệ pass tổng hợp để tính đến bản chất không xác định (nondeterministic) của các mô hình AI.
Chi tiết chính
- Các benchmark end-to-end như Terminal-Bench và DeepSWE đo lường thành công cuối cùng nhưng không giải thích tại sao hiệu suất thay đổi.
- Đánh giá hành vi hoạt động như các bài kiểm tra tích hợp, kiểm tra các hành động trung gian cụ thể như đặt câu hỏi làm rõ hoặc chạy validators.
- Quá trình phát triển nên bắt đầu bằng dogfooding và trực giác, chỉ đưa vào các đánh giá chính thức sau khi tác nhân có thể xử lý các nhiệm vụ cơ bản.
- Mục tiêu chính của một bộ đánh giá là ngăn ngừa các lỗi suy giảm khi thay đổi prompt, công cụ hoặc mô hình.
- Các bài kiểm tra nên assert trên các lệnh gọi công cụ và các bước thực thi, không chỉ đầu ra văn bản cuối cùng, sử dụng các ví dụ từ Antigravity SDK.
- Đánh giá hàng loạt giúp quản lý tính không xác định của mô hình bằng cách theo dõi các xu hướng tổng hợp thay vì chặn dựa trên các lần chạy đơn lẻ nhiều nhiễu.
Tại sao điều này quan trọng
Đối với các kỹ sư phần mềm và trưởng nhóm kỹ thuật, cách tiếp cận này giảm chi phí lặp lại trên các tác nhân AI. Nếu không có thông tin chi tiết về hành vi, các nhóm lãng phí thời gian đoán mò lý do tại sao hiệu suất của mô hình bị sụt giảm, thường dẫn đến các điều chỉnh mù quáng có thể gây ra lỗi mới. Bằng cách cô lập các hành vi cụ thể, các nhà phát triển có thể thực hiện các thay đổi mục tiêu đối với system prompts hoặc cấu hình công cụ, biết chính xác năng lực nào đang được kiểm tra. Độ chính xác này đẩy nhanh chu kỳ phát triển và cải thiện độ tin cậy của các tác nhân đã triển khai.
Hơn nữa, việc đối xử với các khung chứa tác nhân như các thành phần phần mềm tiêu chuẩn khuyến khích các thực hành kỹ thuật tốt hơn. Nó đưa lĩnh vực này ra khỏi việc xem các mô hình như hộp đen phải được dỗ dành để vượt qua các kỳ thi, và hướng tới việc xây dựng các hệ thống bền bỉ với các lưới an toàn rõ ràng. Sự chuyển dịch này là cần thiết khi các tác nhân đảm nhận nhiều trách nhiệm phức tạp hơn, nơi các ảo giác không được kiểm soát hoặc các bước xác minh bị bỏ qua có thể gây ra hậu quả đáng kể trong môi trường production.
Bạn có thể làm gì
- Xác định một chế độ thất bại gần đây trong tác nhân của bạn, chẳng hạn như bỏ qua các lần chạy test, và nhắm mục tiêu nó cho một bài kiểm tra hành vi mới.
- Viết các assertion kiểm tra các lệnh gọi công cụ cụ thể hoặc các bước trung gian thay vì chỉ xác thực đầu ra cuối cùng.
- Bắt đầu với các assertion nghiêm ngặt một lượt (single-turn) cho các nhiệm vụ đơn giản, và sử dụng LLM-as-a-judge cho các kịch bản phức tạp, đa đường dẫn.
- Tự động hóa các đánh giá hàng loạt để theo dõi tỷ lệ pass tổng hợp theo thời gian, làm mượt nhiễu từ tính không xác định của mô hình.
- Sử dụng các đánh giá chủ yếu như rào chắn chống lại các lỗi suy giảm khi cập nhật prompt hoặc chuyển đổi mô hình.
- Trì hoãn việc xây dựng các khung đánh giá phức tạp cho đến sau khi dogfooding ban đầu chứng minh tác nhân có thể xử lý các nhiệm vụ cơ bản.



