Les évaluations comportementales offrent des insights plus clairs pour les agents de codage IA
Le blog Google Developers explique comment les évaluations comportementales fournissent des retours exploitables pour le développement d'agents IA, dépassant les scores opaques des benchmarks de bout en bout.

Traduit automatiquement depuis l'original anglais.
Dans un article publié sur le blog Google Developers en septembre 2026, des ingénieurs ont décrit un changement dans la manière dont les équipes devraient évaluer les agents de codage IA. L'article soutient que se fier uniquement aux scores composites issus de benchmarks de bout en bout laisse souvent les développeurs incapables de diagnostiquer la cause des variations de performance. Il prône plutôt des évaluations comportementales qui suivent des actions spécifiques et observables au sein du flux de travail de l'agent.
Ce qui s'est passé
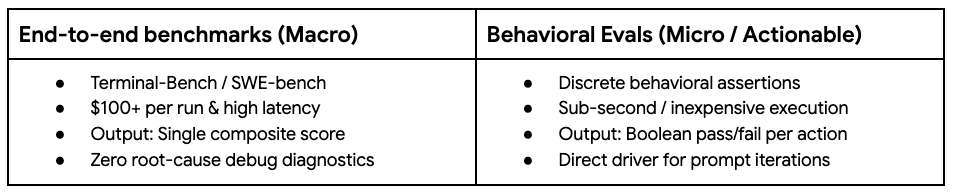
Les développeurs créant des systèmes de codage agentiques rencontrent fréquemment une frustration courante : ils exécutent des benchmarks standard comme Terminal-Bench ou DeepSWE et voient leurs scores fluctuer légèrement. Bien que ces tests de bout en bout soient utiles pour suivre la performance globale, ils n'expliquent pas la cause profonde des régressions ou des améliorations. Lorsqu'un score baisse, il reste difficile de savoir si le modèle est devenu trop confiant, a oublié de vérifier les suites de tests ou a halluciné des options de ligne de commande. Ce manque de visibilité rend l'amélioration itérative coûteuse et lente.
La solution proposée consiste à traiter les évaluations comportementales comme des tests d'intégration pour le harnais de l'agent. Plutôt que de mesurer uniquement si un agent réussit à effectuer un refactor complexe multi-fichiers, ces évaluations vérifient des étapes discrètes tout au long du processus. Par exemple, l'agent pose-t-il des questions de clarification face à des prompts ambigus ? Exécute-t-il un validateur local avant de modifier les fichiers de build ? En se concentrant sur ces comportements intermédiaires, les équipes peuvent établir une base de conduite attendue et itérer sur les prompts avec plus de confiance.
L'article souligne que les harnais d'évaluation ne doivent pas être la première étape du développement. Les phases initiales devraient reposer sur l'instinct des développeurs et le dogfooding, où l'agent est utilisé pour gérer des tâches routinières ou génériques dans sa propre base de code. Les évaluations deviennent critiques dans la seconde phase, servant de garde-fous contre les régressions. Leur rôle principal n'est pas de célébrer des gains mineurs, mais de garantir que les modifications apportées aux prompts, aux schémas d'outils ou aux modèles sous-jacents ne dégradent pas la fiabilité globale de l'agent.
Comment cela fonctionne
Une architecture robuste d'évaluation comportementale sépare les assertions en vérifications rapides et déterministes qui s'exécutent localement. Ces tests se concentrent sur les étapes d'exécution intermédiaires, telles que des appels d'outils spécifiques ou des modifications de fichiers, plutôt que sur les chaînes de sortie finales. Cette approche permet aux développeurs de traiter le harnais de l'agent comme un logiciel standard, appliquant les principes de test unitaire et d'intégration pour assurer la stabilité lors d'itérations rapides.
Par exemple, en utilisant le SDK Antigravity, un test pourrait affirmer qu'un agent utilise un outil de recherche web lorsqu'on lui demande les conditions météorologiques actuelles, plutôt que de compter sur sa mémoire interne. Le test vérifie la liste des appels d'outils effectués durant l'interaction, s'assurant que la ressource externe correcte a été consultée. Cette méthode fournit un retour immédiat si une modification de prompt supprime accidentellement un comportement nécessaire, agissant comme un garde-fou de type CI/CD.
Pour construire une suite efficace, l'article suggère de commencer par une boucle en trois étapes. Premièrement, identifier un mode de défaillance unique, tel que l'oubli d'exécuter des tests unitaires. Deuxièmement, écrire des assertions flexibles basées sur la complexité de la tâche, utilisant des vérifications strictes pour les tâches simples et des jugements basés sur les résultats pour les tâches complexes. Enfin, automatiser les évaluations par lots pour surveiller la stabilité dans le temps, en suivant les taux de réussite agrégés pour tenir compte de la nature non déterministe des modèles IA.
Détails clés
- Les benchmarks de bout en bout comme Terminal-Bench et DeepSWE mesurent le succès final mais n'expliquent pas pourquoi la performance change.
- Les évaluations comportementales agissent comme des tests d'intégration, vérifiant des actions intermédiaires spécifiques comme poser des questions de clarification ou lancer des validateurs.
- Le développement devrait commencer par le dogfooding et l'instinct, n'introduisant des évaluations formelles qu'une fois que l'agent peut gérer les tâches de base.
- L'objectif principal d'une suite d'évaluation est de prévenir les régressions lors de la modification des prompts, des outils ou des modèles.
- Les tests doivent porter sur les appels d'outils et les étapes d'exécution, et non seulement sur la sortie texte finale, en utilisant des exemples du SDK Antigravity.
- Les évaluations par lots aident à gérer la non-déterminisme du modèle en suivant les tendances agrégées plutôt qu'en bloquant sur des exécutions individuelles bruitées.
Pourquoi c'est important
Pour les ingénieurs logiciels et les responsables techniques, cette approche réduit le coût de l'itération sur les agents IA. Sans insights comportementaux, les équipes perdent du temps à deviner pourquoi la performance d'un modèle a chuté, conduisant souvent à des ajustements aveugles qui peuvent introduire de nouvelles erreurs. En isolant des comportements spécifiques, les développeurs peuvent apporter des modifications ciblées aux prompts système ou aux configurations d'outils, sachant exactement quelle capacité est testée. Cette précision accélère les cycles de développement et améliore la fiabilité des agents déployés.
De plus, traiter les harnais d'agents comme des composants logiciels standards encourage de meilleures pratiques d'ingénierie. Cela éloigne le domaine de la vision des modèles comme des boîtes noires qu'il faut amadouer pour réussir des examens, et rapproche la construction de systèmes résilients avec des filets de sécurité clairs. Ce changement est essentiel alors que les agents assument des responsabilités plus complexes, où des hallucinations non contrôlées ou des étapes de vérification sautées peuvent avoir des conséquences significatives dans les environnements de production.
Ce que vous pouvez faire
- Identifiez un récent mode de défaillance dans votre agent, comme le fait de sauter les exécutions de tests, et ciblez-le pour un nouveau test comportemental.
- Écrivez des assertions qui vérifient des appels d'outils spécifiques ou des étapes intermédiaires au lieu de valider uniquement la sortie finale.
- Commencez avec des assertions strictes à tour unique pour les tâches simples, et utilisez LLM-as-a-judge pour les scénarios complexes à multiples chemins.
- Automatisez les évaluations par lots pour suivre les taux de réussite agrégés dans le temps, lissant le bruit dû à la non-déterminisme du modèle.
- Utilisez les évaluations principalement comme garde-fous contre les régressions lors de la mise à jour des prompts ou du changement de modèles.
- Retardez la construction de harnais d'évaluation complexes jusqu'à ce que le dogfooding initial prouve que l'agent peut gérer les tâches de base.



