Verhaltensbewertungen liefern klarere Erkenntnisse für KI-Coding-Agenten
Der Google Developers Blog erläutert, wie Verhaltensbewertungen handlungsorientiertes Feedback für die Entwicklung von KI-Agenten liefern und über intransparente End-to-End-Benchmark-Scores hinausgehen.

Automatisch aus dem englischen Original übersetzt.
In einem Beitrag im Google Developers Blog aus dem September 2026 beschrieben Ingenieure einen Wandel bei der Bewertung von KI-Coding-Agenten. Der Artikel argumentiert, dass sich allein auf zusammengesetzte Scores aus End-to-End-Benchmarks zu verlassen, Entwickler oft daran hindert, die Ursachen für Leistungsänderungen zu diagnostizieren. Stattdessen plädiert er für Verhaltensbewertungen, die spezifische, beobachtbare Aktionen innerhalb des Agenten-Workflows nachverfolgen.
Was passiert ist
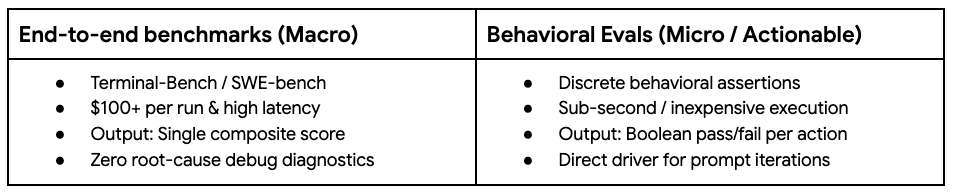
Entwickler, die agentische Coding-Systeme erstellen, stoßen häufig auf ein verbreitetes Ärgernis: Sie führen Standard-Benchmarks wie Terminal-Bench oder DeepSWE durch und sehen, dass ihre Scores um kleine Margen schwanken. Zwar sind diese End-to-End-Tests nützlich für das High-Level-Leistungstracking, sie erklären jedoch nicht die Grundursache von Regressionen oder Verbesserungen. Wenn ein Score sinkt, bleibt unklar, ob das Modell übermäßig selbstbewusst wurde, vergessen hat, Testsuiten zu verifizieren, oder Kommandozeilen-Flags halluziniert hat. Diese mangelnde Transparenz macht iterative Verbesserungen teuer und langsam.
Die vorgeschlagene Lösung besteht darin, Verhaltensbewertungen als Integrationstests für das Agent-Harness zu behandeln. Anstatt nur zu messen, ob ein Agent eine komplexe Refaktorierung über mehrere Dateien hinweg erfolgreich abschließt, prüfen diese Bewertungen diskrete Schritte entlang des Weges. Zum Beispiel: Stellt der Agent klärende Fragen, wenn er mit mehrdeutigen Prompts konfrontiert wird? Führt er einen lokalen Validator aus, bevor er Build-Dateien modifiziert? Durch den Fokus auf diese intermediären Verhaltensweisen können Teams eine Baseline für das erwartete Verhalten schaffen und Prompts mit größerer Zuversicht iterativ verbessern.
Der Artikel betont, dass Bewertungs-Harnesses nicht der erste Schritt in der Entwicklung sein sollten. Die Anfangsphase sollte sich auf die Intuition der Entwickler und Dogfooding stützen, wobei der Agent eingesetzt wird, um Boilerplate-Aufgaben oder Routineaufgaben innerhalb seiner eigenen Codebasis zu bearbeiten. Bewertungen werden in der zweiten Phase kritisch und dienen als Leitplanken gegen Regressionen. Ihre primäre Rolle besteht nicht darin, geringfügige Gewinne zu feiern, sondern sicherzustellen, dass Änderungen an Prompts, Tool-Schemas oder zugrunde liegenden Modellen die Gesamtzuverlässigkeit des Agenten nicht verschlechtern.
Wie es funktioniert
Eine robuste Architektur für Verhaltensbewertungen trennt Assertions in schnelle, deterministische Checks, die lokal ausgeführt werden. Diese Tests konzentrieren sich auf intermediäre Ausführungsschritte, wie spezifische Tool-Aufrufe oder Datei-Modifikationen, anstatt auf finale Output-Strings. Dieser Ansatz ermöglicht es Entwicklern, das Agent-Harness wie Standardsoftware zu behandeln und Unit- sowie Integrationstest-Prinzipien anzuwenden, um Stabilität während schneller Iterationen zu gewährleisten.
Ein Beispiel: Unter Verwendung des Antigravity SDK könnte ein Test assertieren, dass ein Agent ein Web-Such-Tool nutzt, wenn er nach aktuellen Wetterbedingungen gefragt wird, anstatt sich auf das interne Gedächtnis zu verlassen. Der Test prüft die Liste der Tool-Aufrufe, die während der Interaktion getätigt wurden, und stellt sicher, dass die korrekte externe Ressource konsultiert wurde. Diese Methode liefert sofortiges Feedback, falls eine Prompt-Anpassung versehentlich eine notwendige Verhaltensweise entfernt, und fungiert als CI/CD-artige Leitplanke.
Um eine effektive Suite zu erstellen, schlägt der Artikel vor, mit einer dreistufigen Schleife zu beginnen. Erstens: Identifizieren Sie einen einzelnen Fehlermodus, wie das Vergessen, Unit-Tests auszuführen. Zweitens: Schreiben Sie flexible Assertions basierend auf der Aufgabenkomplexität, indem Sie strenge Checks für einfache Aufgaben und ergebnisbasierte Beurteilungen für komplexe Aufgaben verwenden. Drittens: Automatisieren Sie Batch-Bewertungen, um die Stabilität über die Zeit zu überwachen, und verfolgen Sie aggregierte Pass-Rates, um der nichtdeterministischen Natur von KI-Modellen Rechnung zu tragen.
Wichtige Details
- End-to-End-Benchmarks wie Terminal-Bench und DeepSWE messen den finalen Erfolg, erklären aber nicht, warum sich die Leistung ändert.
- Verhaltensbewertungen fungieren als Integrationstests und prüfen auf spezifische intermediäre Aktionen wie das Stellen von Klärungsfragen oder das Ausführen von Validatoren.
- Die Entwicklung sollte mit Dogfooding und Intuition beginnen; formale Bewertungen werden erst eingeführt, nachdem der Agent grundlegende Aufgaben bewältigen kann.
- Das primäre Ziel einer Bewertungssuite ist die Verhinderung von Regressionen bei Änderungen an Prompts, Tools oder Modellen.
- Tests sollten auf Tool-Aufrufe und Ausführungsschritte assertieren, nicht nur auf den finalen Textoutput, unter Verwendung von Beispielen aus dem Antigravity SDK.
- Batch-Bewertungen helfen dabei, die Nichtdeterminismus von Modellen zu managen, indem sie aggregierte Trends verfolgen, anstatt einzelne verrauschte Läufe zu blockieren.
Warum es wichtig ist
Für Software-Ingenieure und technische Leads reduziert dieser Ansatz die Kosten für die Iteration an KI-Agenten. Ohne Verhaltens-Einsichten verschwenden Teams Zeit damit, zu raten, warum die Leistung eines Modells eingebrochen ist, was oft zu blinden Anpassungen führt, die neue Fehler einführen können. Durch die Isolierung spezifischer Verhaltensweisen können Entwickler gezielte Änderungen an System-Prompts oder Tool-Konfigurationen vornehmen, da sie genau wissen, welche Fähigkeit getestet wird. Diese Präzision beschleunigt Entwicklungszyklen und verbessert die Zuverlässigkeit eingesetzter Agenten.
Darüber hinaus fördert die Behandlung von Agent-Harnesses als Standard-Softwarekomponenten bessere Engineering-Praktiken. Es bewegt das Feld weg von der Sichtweise, Modelle als Black Boxes zu betrachten, die dazu gebracht werden müssen, Prüfungen zu bestehen, hin zum Aufbau widerstandsfähiger Systeme mit klaren Sicherheitsnetzen. Dieser Wandel ist essenziell, da Agenten komplexere Verantwortungen übernehmen, wo ungeprüfte Halluzinationen oder übersprungene Verifikationsschritte erhebliche Konsequenzen in Produktionsumgebungen haben können.
Was Sie tun können
- Identifizieren Sie einen kürzlich aufgetretenen Fehlermodus in Ihrem Agenten, wie das Überspringen von Testläufen, und zielen Sie darauf mit einem neuen Verhaltens-Test ab.
- Schreiben Sie Assertions, die auf spezifische Tool-Aufrufe oder intermediäre Schritte prüfen, anstatt nur den finalen Output zu validieren.
- Beginnen Sie mit strengen Single-Turn-Assertions für einfache Aufgaben und nutzen Sie LLM-as-a-judge für komplexe, multipfade Szenarien.
- Automatisieren Sie Batch-Bewertungen, um aggregierte Pass-Rates über die Zeit zu verfolgen und Rauschen durch Modell-Nichtdeterminismus zu glätten.
- Nutzen Sie Bewertungen primär als Leitplanken gegen Regressionen beim Aktualisieren von Prompts oder Wechseln von Modellen.
- Verzögern Sie den Aufbau komplexer Bewertungs-Harnesses, bis nach anfänglichem Dogfooding feststeht, dass der Agent grundlegende Aufgaben bewältigen kann.



