La reproducción de OLMo 3 7B en TPUs revela errores ocultos en el cargador de datos
Un estudio de caso de Google reproduce el modelo OLMo 3 de AI2 en TPUs, igualando las métricas de rendimiento mientras descubre errores críticos en la fragmentación de datos que ocultaban la memorización como una mejora.

Traducido automáticamente del original en inglés.
En una publicación del blog de desarrolladores de Google en septiembre de 2026, los ingenieros detallaron su exitosa reproducción del modelo de lenguaje OLMo 3 7B del Allen Institute for AI utilizando MaxText en las TPUs de Google Cloud. El equipo igualó las curvas de entrenamiento originales y los benchmarks posteriores, demostrando que una receta basada en PyTorch para GPU podía ejecutarse fielmente en un entorno TPU basado en JAX.
Qué ocurrió
El equipo de ingeniería se propuso validar las capacidades de MaxText, un framework de alto rendimiento para entrenar grandes modelos de lenguaje en TPUs. Elegieron OLMo 3 porque es uno de los pocos modelos de clase frontera con pesos, datos y recetas de entrenamiento totalmente abiertos. Esta transparencia permitió una comparación rigurosa contra una ejecución de referencia independiente, en lugar de depender únicamente de las curvas de pérdida. La reproducción abarcó el preentrenamiento de la etapa 1 y el recocido del mid-training de la etapa 2, utilizando los checkpoints de paso-0 de PyTorch de AI2 convertidos al formato Orbax para JAX.
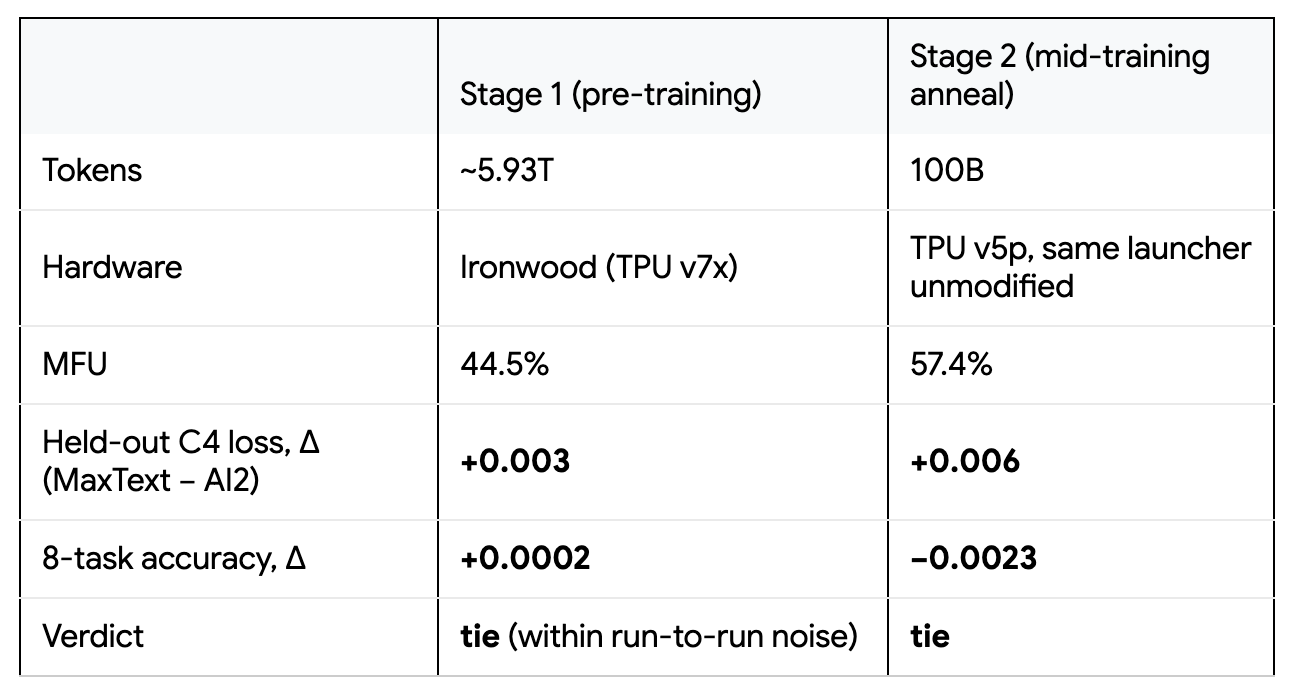
Los resultados mostraron que MaxText podía seguir la curva de pérdida publicada por AI2 durante todo el presupuesto de 5,93 billones de tokens. Sin embargo, el proceso no estuvo exento de complicaciones. Durante las etapas posteriores del entrenamiento, la ejecución de MaxText parecía superar a la referencia, con una pérdida de entrenamiento que caía significativamente por debajo de los niveles de AI2. Una investigación más profunda reveló que esto no era una mejora genuina en la calidad del modelo, sino un artefacto de un error en la carga de datos. El equipo también demostró la resiliencia del sistema redimensionando el trabajo de entrenamiento en vuelo tras perder capacidad de hardware y cambiando entre generaciones de TPU entre etapas de entrenamiento sin alterar la receta central.
Cómo funciona
Para garantizar la fidelidad, el equipo portó las opciones arquitectónicas específicas de OLMo 3, incluidos los bloques de normalización reordenados, QK-norm y un patrón mixto de atención de ventana deslizante y global, a MaxText. Verificaron la conversión comprobando la paridad de logits, asegurando que el modelo convertido coincidiera con la referencia de HuggingFace dentro del umbral de ruido esperado para diferentes frameworks. El pipeline de datos fue reconstruido usando Grain, implementando lecturas de acceso aleatorio, barajado de índices globales y filtrado de repeticiones de n-gramas para reflejar exactamente la configuración original.
La optimización del rendimiento jugó un papel crucial para hacer viable la reproducción. El equipo logró una utilización de flops del modelo (MFU) del 44,5% en las TPUs Ironwood al descargar las operaciones colectivas al SparseCore y ajustar las estrategias de rematerialización. También exploraron oportunidades de co-diseño, como remodelar las cabezas de atención para utilizar mejor las unidades de multiplicación de matrices de la TPU, lo que resultó en velocidades de entrenamiento más rápidas sin sacrificar la calidad. Estos ajustes de ingeniería permitieron al sistema mantener el throughput incluso cuando los recursos de hardware cambiaban dinámicamente durante la ejecución de entrenamiento de varias semanas.
Detalles clave
- Igualdad de métricas: El modelo reproducido coincidió con las métricas de evaluación retenidas de AI2, incluyendo la pérdida C4 y ocho tareas posteriores, con diferencias de precisión que nunca superaron ±0,005.
- Descubrimiento del bug de datos: Un error de doble fragmentación en el cargador de datos Grain causó instancias de datos repetidas, reduciendo artificialmente la pérdida de entrenamiento hasta 0,25 puntos sin mejorar la generalización.
- Resiliencia del hardware: El trabajo de entrenamiento se reanudó con éxito en una partición de clúster de un cuarto del tamaño original tras una pérdida de capacidad, manteniendo el throughput por dispositivo dentro del 1%.
- Conversión de framework: Los pesos de PyTorch fueron convertidos a Orbax con una divergencia KL de aproximadamente 1,5e-3, confirmando que los modelos eran idénticos en la inicialización.
- Receta simplificada: El equipo utilizó un único programa de tasa de aprendizaje coseno en lugar del enfoque de dos curvas cosidas de AI2, pero aún así logró resultados comparables.
Por qué importa
Para los desarrolladores que construyen sistemas de IA a gran escala, este estudio de caso destaca el peligro de depender exclusivamente de la pérdida de entrenamiento como proxy de la calidad del modelo. El incidente donde MaxText pareció vencer a la referencia debido a la memorización de datos sirve como un claro recordatorio de que una menor pérdida no siempre significa mejor rendimiento. Subraya la necesidad de evaluaciones rigurosas retenidas y pasos de verificación independientes para detectar bugs sutiles en los pipelines de datos que de otro modo podrían pasar desapercibidos durante semanas.
Además, la exitosa reproducción demuestra la madurez de los ecosistemas de JAX y TPU para manejar arquitecturas de transformadores complejas y no estándar. Proporciona una guía para equipos que buscan migrar desde stacks de PyTorch/GPU a entornos de JAX/TPU, mostrando que la reproducción fiel es posible incluso con diferencias arquitectónicas significativas. La capacidad de redimensionar trabajos y cambiar generaciones de hardware a mitad del entrenamiento también ofrece insights prácticos para gestionar costos y fiabilidad en trabajos de entrenamiento en la nube de larga duración.
Qué puede hacer usted
- Implemente evaluaciones retenidas regulares junto con el monitoreo de la pérdida de entrenamiento para detectar memorización o fuga de datos tempranamente.
- Verifique la lógica de fragmentación del cargador de datos con pruebas unitarias que simulen entornos multi-worker para prevenir duplicaciones silenciosas de datos.
- Utilice comprobaciones de paridad de logits al convertir modelos entre frameworks para asegurar la consistencia de la inicialización antes de comenzar el entrenamiento.
- Diseñe scripts de entrenamiento para manejar cambios dinámicos de recursos, permitiendo una reanudación fluida en diferentes particiones de hardware si ocurren interrupciones.
- Compare la precisión en tareas posteriores en múltiples checkpoints, no solo al final del entrenamiento, para asegurar un crecimiento consistente de las capacidades.
- Revise las configuraciones del pipeline de datos para operaciones de fragmentación redundantes, especialmente al usar librerías como Grain que pueden manejar la fragmentación internamente.



