Kubernetes presenta una extensión de la Gateway API para el enrutamiento de inferencia de LLM
El proyecto Kubernetes lanzó la Gateway API Inference Extension para estandarizar el enrutamiento de cargas de trabajo de IA generativa, reduciendo la latencia y mejorando la utilización de las GPU.

Traducido automáticamente del original en inglés.
En una publicación del blog de Kubernetes en junio de 2025, colaboradores de Solo.io, Google y Bytedance presentaron la Gateway API Inference Extension. Esta nueva extensión estandarizada aborda los desafíos específicos de enrutamiento de tráfico de los grandes modelos de lenguaje (LLM) autoalojados, añadiendo capacidades conscientes de la inferencia al marco existente de la Gateway API.
Qué ocurrió
Los servicios modernos de IA generativa difieren significativamente de las aplicaciones web tradicionales. Mientras que las solicitudes HTTP estándar suelen ser efímeras y sin estado, las sesiones de inferencia de LLM son de larga duración, intensivas en recursos y parcialmente con estado. Un servidor de modelos respaldado por una sola GPU podría mantener sesiones de inferencia activas y conservar cachés de tokens en memoria. Los balanceadores de carga tradicionales, que generalmente dependen de coincidencias simples de rutas HTTP o distribución round-robin, carecen de la lógica especializada necesaria para gestionar estas cargas de trabajo complejas de manera efectiva. No tienen en cuenta la identidad del modelo ni la criticidad de una solicitud, como distinguir entre una sesión de chat interactiva y un trabajo por lotes en segundo plano.
Para resolver esto, la comunidad desarrolló la Gateway API Inference Extension. Este proyecto se basa en el familiar modelo de la Gateway API, permitiendo a los ingenieros de plataforma transformar una puerta de enlace estándar en una "Inference Gateway". El objetivo es proporcionar un enfoque estandarizado para enrutar cargas de trabajo de inferencia en todo el ecosistema, alejándose de soluciones personalizadas ad-hoc. Al habilitar el enrutamiento consciente del modelo y apoyar las criticidades por solicitud, la extensión busca reducir la latencia y optimizar la utilización de aceleradores como las GPU.
Cómo funciona
La arquitectura introduce dos nuevas Definiciones de Recursos Personalizados (CRD) que separan las responsabilidades entre los operadores de plataforma y los propietarios de IA/ML. La primera, InferencePool, define un grupo de pods que ejecutan servidores de modelos sobre recursos informáticos compartidos. Los administradores de plataforma utilizan este recurso para configurar políticas de despliegue, escalado y balanceo, garantizando un uso consistente de los recursos en todo el clúster. Funciona de manera similar a un Servicio de Kubernetes, pero es específicamente consciente de los protocolos de servicio de modelos.
El segundo recurso, InferenceModel, es gestionado por los equipos de IA/ML. Asigna un nombre de endpoint público, como "gpt-4-chat", a un modelo específico dentro de un InferencePool. Esto permite a los propietarios de cargas de trabajo definir qué modelos se sirven, incluidas las variantes de ajuste fino, y establecer políticas de división de tráfico o priorización. Esta separación asegura que los equipos de plataforma gestionen la infraestructura mientras que los equipos de aplicación gestionan la exposición del modelo.
Cuando un cliente envía una solicitud, la Gateway examina el HTTPRoute para identificar el InferencePool objetivo. En lugar de reenviar el tráfico a cualquier pod disponible, la Gateway consulta una Endpoint Selection Extension. Este componente analiza métricas en vivo de los pods, como longitudes de cola, uso de memoria y adaptadores cargados. Luego selecciona el pod óptimo basándose en condiciones en tiempo real, asegurando que la solicitud sea manejada con la menor latencia posible o la mayor eficiencia. Este proceso permanece transparente para el cliente, apareciendo como una solicitud única estándar.
Detalles clave
- Dos nuevas CRD:
InferencePoolpara la gestión de recursos a nivel de plataforma yInferenceModelpara endpoints de modelos orientados al usuario. - Endpoint Selection Extension: Reemplaza el simple round-robin con un enrutamiento consciente de métricas que considera la profundidad de la cola y el estado de la memoria.
- Entorno de benchmark: Las pruebas utilizaron vLLM versión 1 en pods de GPU H100 (80 GB) con 10 réplicas de Llama2.
- Mejoras de latencia: La extensión mostró una latencia p90 significativamente menor bajo cargas altas (más de 500 QPS) en comparación con los Servicios de Kubernetes estándar.
- Paridad de rendimiento: El rendimiento se mantuvo comparable al de los servicios estándar en el rango probado de 100 a 1000 Consultas por Segundo.
- Diseño extensible: El marco admite extensiones adicionales para nuevas estrategias de enrutamiento o necesidades de hardware especializado.
Por qué importa
Para los equipos de ingeniería que construyen productos de IA, esta extensión ofrece un camino hacia un servicio de modelos autoalojado más fiable y eficiente. Al enrutar solicitudes basándose en métricas de pods en tiempo real en lugar de reglas estáticas, las organizaciones pueden evitar puntos calientes que ocurren cuando la memoria de la GPU se acerca a la saturación. Esto conduce a latencias de cola más predecibles, lo cual es crítico para mantener una experiencia de usuario fluida en aplicaciones interactivas. La capacidad de priorizar el tráfico según su criticidad también asegura que las interacciones de alto valor no sean bloqueadas por procesos por lotes de menor prioridad.
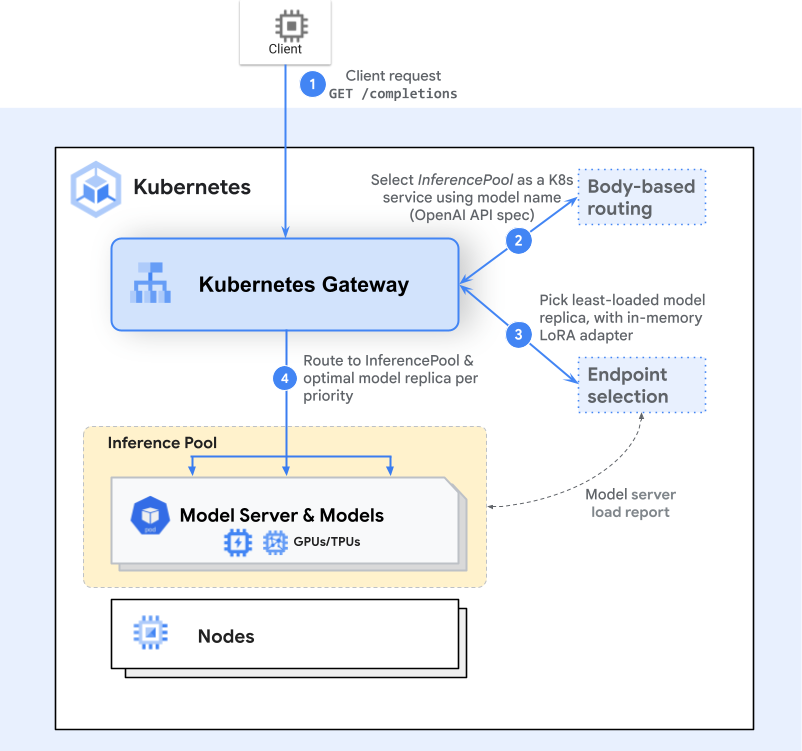
Desde una perspectiva operativa, la estandarización reduce la carga de mantenimiento de la lógica de enrutamiento personalizada. Los equipos de plataforma pueden aplicar políticas consistentes entre diferentes modelos y equipos utilizando herramientas nativas de Kubernetes. A medida que el proyecto avanza hacia la disponibilidad general, funciones como el balanceo de carga consciente de la caché de prefijos y el soporte para aceleradores heterogéneos mejorarán aún más su utilidad. Esta alineación con herramientas nativas de Kubernetes simplifica la integración de servicios de GenAI en la infraestructura existente.
Qué puede hacer
- Revise la documentación oficial del proyecto para comprender las especificaciones de la API y los requisitos de instalación.
- Despliegue una Inference Gateway de prueba en un entorno no productivo para evaluar la Endpoint Selection Extension.
- Mapee los servicios de modelos existentes a recursos
InferencePooleInferenceModelpara probar la ruta de migración. - Monitoree las métricas de latencia p90 y utilización de GPU durante las pruebas de carga para cuantificar las mejoras de rendimiento.
- Contribuya al proyecto desarrollando nuevas extensiones para estrategias de enrutamiento específicas o tipos de hardware.
- Proporcione comentarios sobre los elementos de la hoja de ruta, como las tuberías de adaptadores LoRA y el soporte para servicio desagregado.



