Google demuestra bucles de ajuste fino autónomo de LLM en TPUs
El blog de Google Developers detalla autofinetune, un sistema impulsado por agentes que automatiza el ajuste de hiperparámetros para SFT y post-entrenamiento con RL en Cloud TPUs.

Traducido automáticamente del original en inglés.
En una publicación del blog de Google Developers en septiembre de 2026, los ingenieros describieron un nuevo enfoque para la optimización de modelos de lenguaje grandes llamado autofinetune. Este sistema utiliza agentes de IA autónomos para gestionar el ciclo repetitivo de ajuste fino supervisado y aprendizaje por refuerzo, ejecutando experimentos en las Cloud TPUs de Google sin supervisión humana constante.
Qué ocurrió
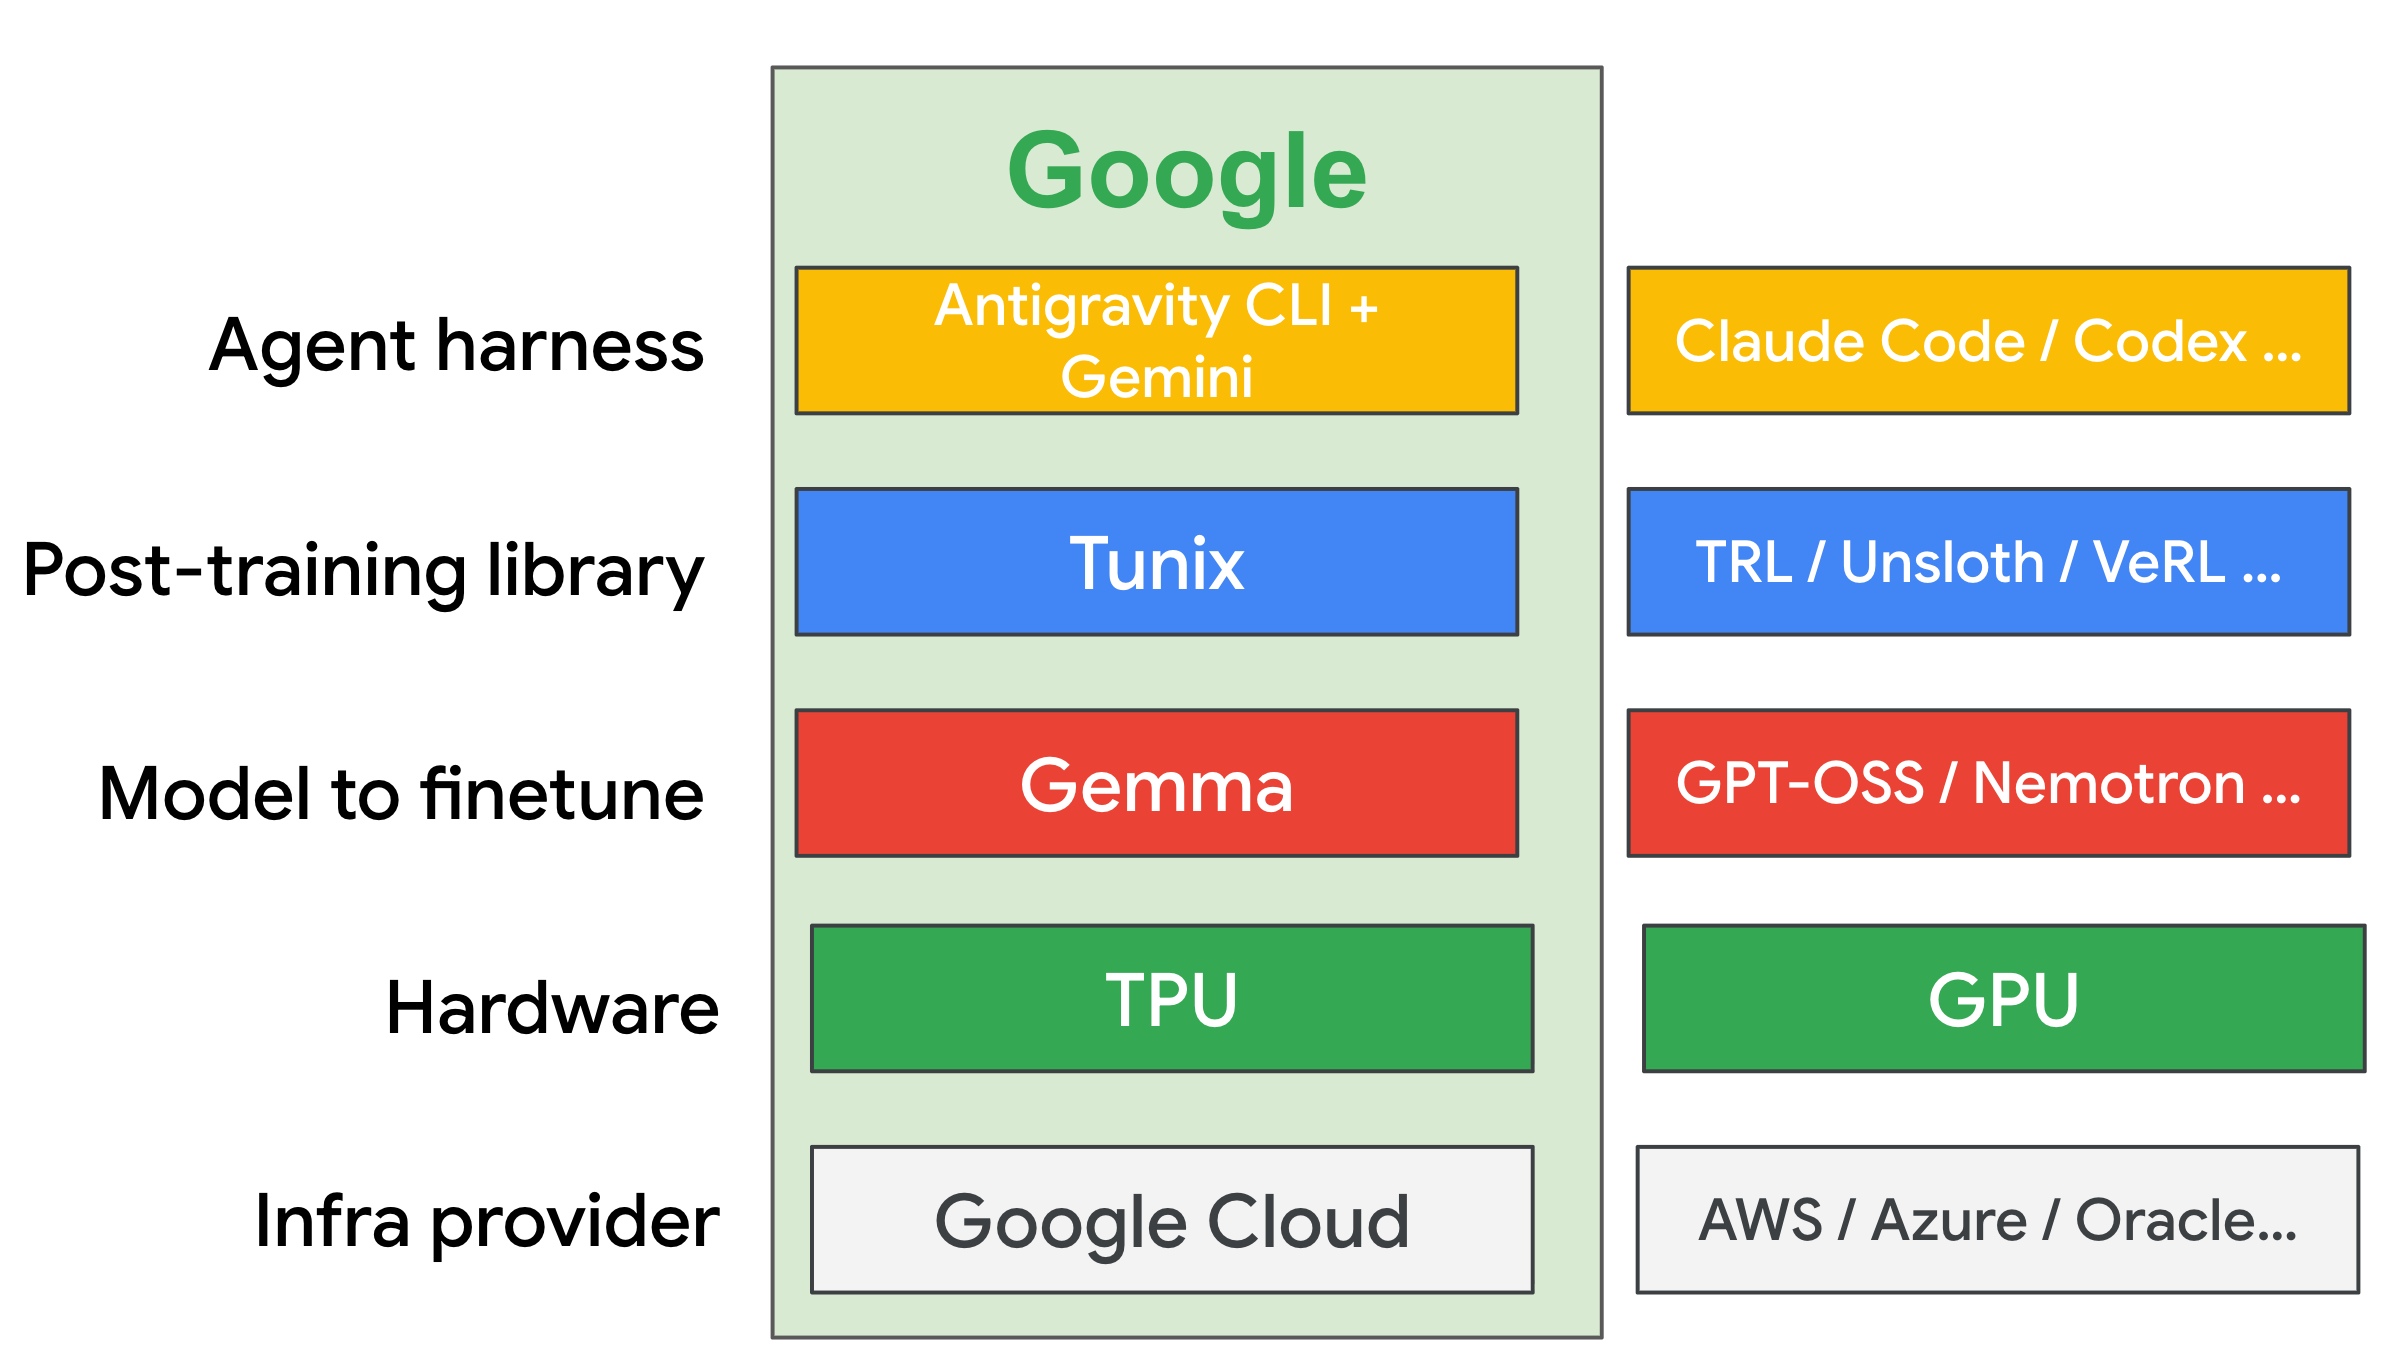
Los flujos de trabajo tradicionales de post-entrenamiento requieren que los desarrolladores formulen hipótesis manualmente, editen scripts, lancen trabajos y monitoreen los resultados. Este proceso es lento y propenso a errores humanos. El nuevo proyecto autofinetune automatiza todo este bucle aprovechando la pila completa de IA de Google, incluyendo Tunix, los modelos Gemma y las Cloud TPUs, orquestados mediante la CLI de Antigravity y Gemini Flash 3.7. El objetivo es permitir que los ingenieros definan restricciones de alto nivel y dejen que un agente descubra configuraciones óptimas durante la noche.
El equipo demostró esta capacidad a través de dos casos de estudio distintos. El primero se centró en el Ajuste Fino Supervisado (SFT) utilizando el modelo google/functiongemma-270m-it sobre el conjunto de datos google/mobile-actions. Ejecutándose en una sola Cloud TPU v5e, el agente realizó 20 experimentos automatizados en apenas unas horas. Ajustó variables como el rango LoRA, las tasas de aprendizaje y los optimizadores, manteniendo fijos el conjunto de datos y la arquitectura. El agente mejoró con éxito la precisión en la generación de llamadas a funciones refinando iterativamente estos parámetros.
El segundo caso de estudio abordó el Aprendizaje por Refuerzo mediante la Optimización de Política Relativa por Grupos (GRPO), un método de entrenamiento más complejo e inestable. Utilizando Gemma 3 1B sobre el conjunto de datos de razonamiento matemático GSM8K, el agente realizó 40 experimentos durante dos o tres días en una Cloud TPU v6e. A pesar de los tiempos de iteración más largos y la sensibilidad del RL, el agente identificó mejores configuraciones de LoRA y temperaturas de rollout. Esto resultó en una mejora aproximada del 10% en la métrica combinada de precisión numérica y de formato.
Cómo funciona
El sistema opera bajo un cambio de paradigma desde el ajuste manual hacia un bucle de investigación autónomo. Los humanos definen el entorno creando un archivo program.md que establece condiciones límite, criterios de evaluación y restricciones. También proporcionan un script de ejecución limpio y autocontenido llamado run.py. El agente de IA toma entonces el control, leyendo las instrucciones en program.md para modificar run.py, lanzar trabajos de entrenamiento y medir las métricas objetivo.
Si un experimento produce mejoras, el agente confirma los cambios en Git y registra los resultados en un archivo results.tsv. Si un cambio causa una regresión, el agente lo revierte. Este sistema de bucle cerrado permite un ascenso continuo hacia un mejor rendimiento sin intervención manual. El agente explora un espacio de búsqueda definido, como los optimizadores permitidos o los tamaños de lote, respetando al mismo tiempo los cambios no permitidos, como alterar la arquitectura central del modelo.
Detalles clave
- El proyecto utiliza la biblioteca Tunix de Google, los modelos Gemma y las Cloud TPUs, orquestados con la CLI de Antigravity y Gemini Flash 3.7.
- En el caso de estudio de SFT, el agente realizó 20 experimentos en pocas horas en una Cloud TPU v5e-1, optimizando rangos LoRA y tasas de aprendizaje.
- Para el caso de estudio de GRPO, el agente llevó a cabo 40 experimentos durante 2–3 días en una Cloud TPU v6e-1, mejorando la recompensa total en aproximadamente un 10%.
- Los operadores humanos definen las restricciones en
program.md, especificando parámetros permitidos como el tamaño de lote y cambios no permitidos como intercambios de conjuntos de datos. - El agente gestiona automáticamente el control de versiones, confirmando configuraciones exitosas en Git y registrando métricas en
results.tsv. - La métrica objetiva para el experimento de RL fue una suma simplificada de la precisión numérica y la precisión de formato.
Por qué importa
Para los equipos de software que construyen productos de IA, el cuello de botella a menudo no reside en la arquitectura del modelo, sino en el tedioso proceso de ajuste de hiperparámetros. La experimentación manual consume muchos recursos y es difícil de escalar. Al automatizar este bucle, los ingenieros pueden recuperar el tiempo dedicado a monitorear curvas de pérdida y gestionar hojas de cálculo. Este cambio permite a los equipos centrarse en la definición de problemas de alto nivel y en la calidad de los datos, en lugar de en los aspectos mecánicos de las ejecuciones de entrenamiento.
Además, los agentes autónomos pueden explorar espacios de configuración más exhaustivamente que los humanos debido a la fatiga o las limitaciones de tiempo. La capacidad de ejecutar decenas de experimentos durante la noche significa ciclos de iteración más rápidos y potencialmente modelos con mejor rendimiento. Esto es particularmente valioso para el aprendizaje por refuerzo, donde la inestabilidad hace que el ajuste manual sea especialmente desafiante. La integración con herramientas existentes como Git asegura que los experimentos exitosos sean rastreados y reproducibles, manteniendo el rigor de ingeniería.
Qué puedes hacer
- Revisa el repositorio de GitHub
autofinetunepara acceder al código, las ejecuciones de muestra y las plantillas deprogram.mdproporcionadas por el equipo. - Define condiciones límite claras y métricas de evaluación para tus propias tareas de ajuste fino antes de intentar la automatización.
- Comienza con experimentos simples de ajuste fino supervisado para entender cómo interactúa el agente con tus scripts de entrenamiento.
- Utiliza la biblioteca Tunix y las Cloud TPUs para replicar el entorno de hardware descrito en los casos de estudio.
- Monitorea los registros de
results.tsvpara entender el proceso de toma de decisiones del agente e identificar patrones en las configuraciones exitosas. - Experimenta con diferentes conjuntos de restricciones en
program.mdpara equilibrar la velocidad de exploración con el costo computacional.



