Optimización de la inferencia de embeddings en contextos largos en Cloud TPU con vLLM
Google detalla cómo el soporte nativo para TPU en vLLM permite un escalado elástico y una inferencia de embeddings de alta precisión para los modelos Qwen3.
Cobertura diaria de IA, herramientas para desarrolladores e infraestructura. Cada artículo explica qué ocurrió y por qué es importante, con un enlace a la fuente original.
Google detalla cómo el soporte nativo para TPU en vLLM permite un escalado elástico y una inferencia de embeddings de alta precisión para los modelos Qwen3.
Kubernetes carece de soporte nativo para fallos parciales de dispositivos, lo que obliga a los ingenieros a crear lógica de remediación personalizada para costosos trabajos de entrenamiento de IA y ML.
El proyecto Kubernetes lanzó la Gateway API Inference Extension para estandarizar el enrutamiento de cargas de trabajo de IA generativa, reduciendo la latencia y mejorando la utilización de las GPU.
Kubernetes v1.33 introduce un nuevo mecanismo de verificación para evitar que pods no autorizados reutilicen imágenes de contenedores privados ya presentes en un nodo.
Kubernetes v1.33 añade codificación en streaming para las respuestas List, reduciendo el uso de memoria de kube-apiserver hasta 20 veces durante la obtención de grandes conjuntos de datos y mejorando la estabilidad del clúster.
Kubernetes v1.32 vuelve a habilitar por defecto la función QueueingHint, permitiendo que los plugins determinen con precisión cuándo se deben reintentar los pods no programables, reduciendo así ciclos de planificación desperdiciados.
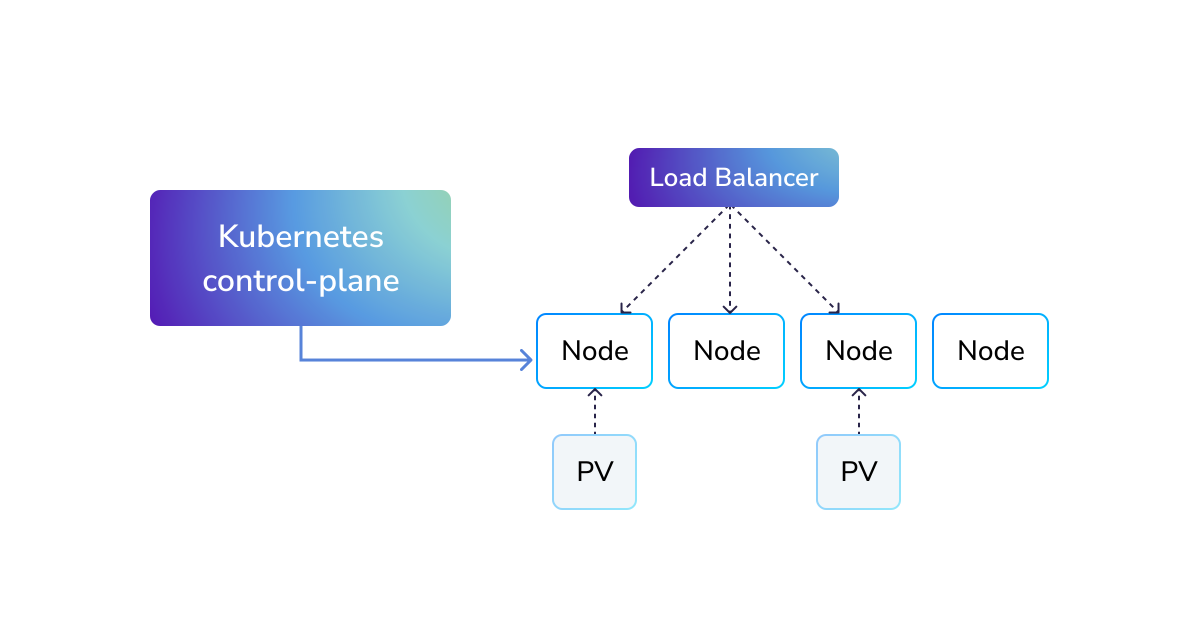
Una guía técnica detalla cómo construir una plataforma de nube autoalojada utilizando Kubernetes, Talos Linux y herramientas GitOps para gestionar infraestructura en hardware físico.
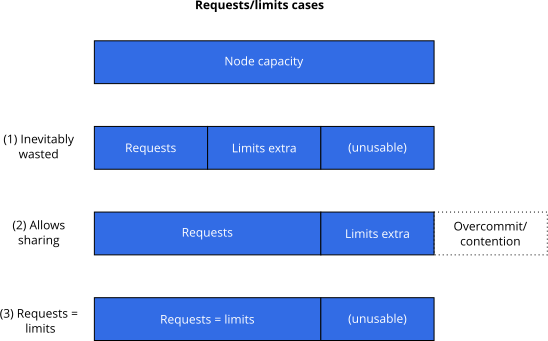
Un análisis de 2023 sostiene que establecer límites de CPU y memoria en Kubernetes mejora la previsibilidad del rendimiento, aunque reduzca la eficiencia bruta del clúster.
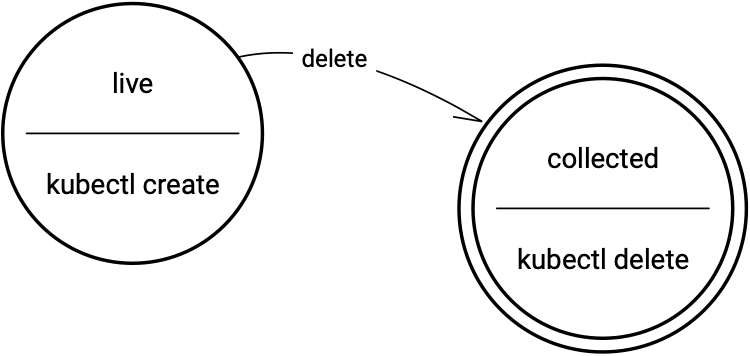
Una guía de 2021 explica cómo los finalizers bloquean la eliminación de recursos y cómo las owner references gestionan las eliminaciones en cascada en clústeres de Kubernetes.