Gemma-LLMs auf dem Raspberry Pi 5 mit LiteRT ausführen
Googles Leitfaden von 2026 beschreibt, wie LiteRT genutzt wird, um Gemma-Modelle auf dem Raspberry Pi 5 auszuführen. Dies ermöglicht Echtzeit-Inferenz für Robotik und Edge-Agenten ohne Abhängigkeit von der Cloud.
Automatisch aus dem englischen Original übersetzt.
In einem Beitrag im Google Developers Blog vom August 2026 beschrieben Ingenieure, wie große Sprachmodelle direkt auf kompakter Hardware bereitgestellt werden können. Der Leitfaden konzentrierte sich darauf, die Modellfamilie Google Gemma auf dem Raspberry Pi 5 unter Verwendung der Inferenz-Laufzeitumgebung LiteRT auszuführen. Dieser Ansatz ermöglicht vollständig offline arbeitende KI-Anwendungen mit geringer Latenz für Robotik und lokale Agenten.
Was passiert ist
Der Artikel demonstrierte, dass Entwickler autonome Systeme wie den Roboter Reachy Mini erstellen können, die ihre Umgebung in Echtzeit wahrnehmen und darauf reagieren, ohne eine Internetverbindung zu benötigen. Durch die Kombination von LiteRT mit Gemma-Modellen erreicht das System vollständige Datensicherheit und extrem niedrige Latenzzeiten. Das Setup basiert ausschließlich auf dem Raspberry Pi 5, wodurch Cloud-Server oder externe Beschleuniger für grundlegende Aufgaben überflüssig werden.
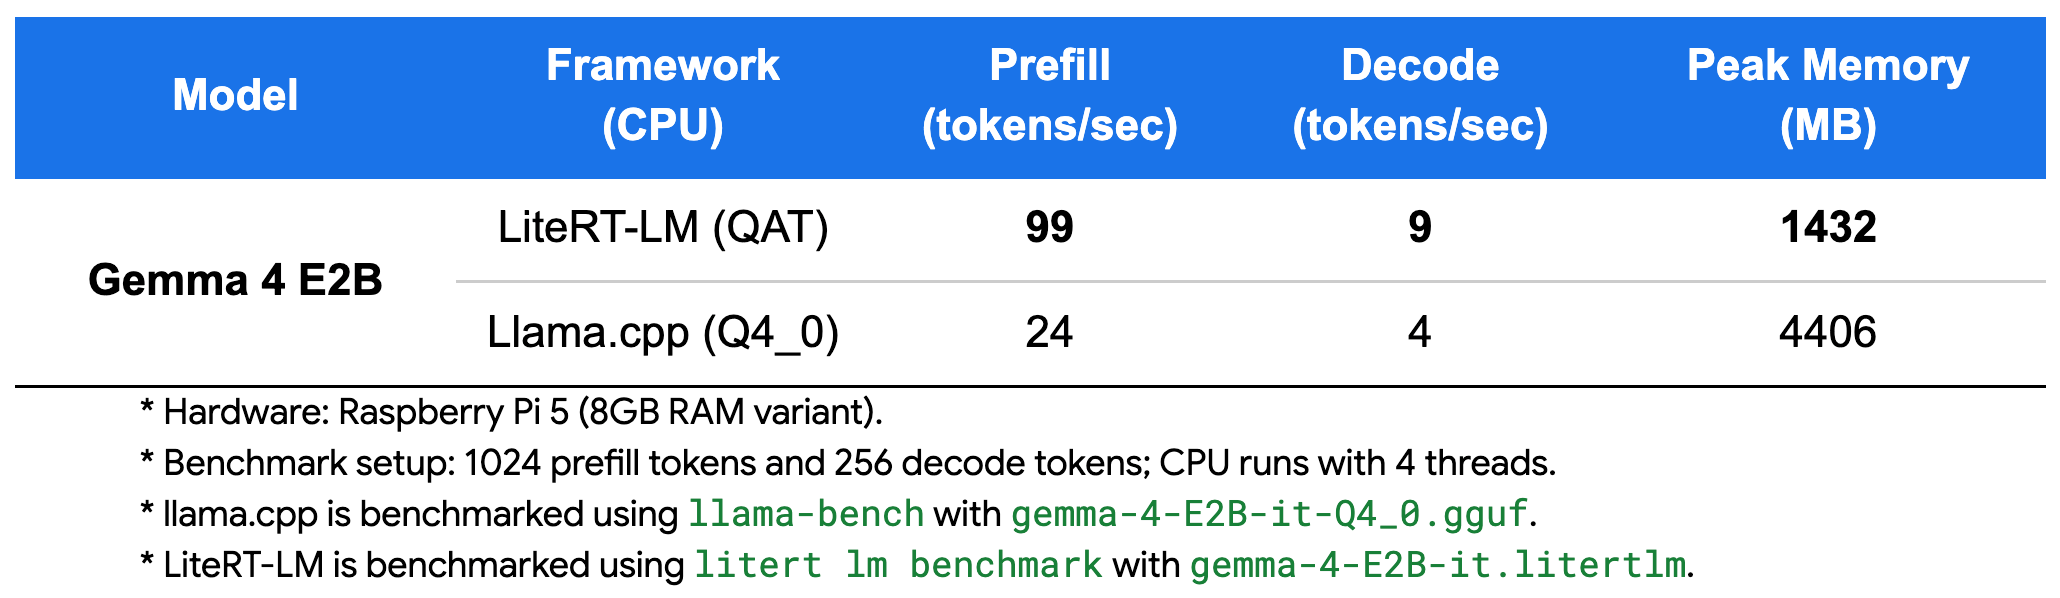
Google hob spezifische Leistungsmetriken für diese Konfiguration hervor. Auf dem Raspberry Pi 5 ermöglichte die Orchestrierungsschicht LiteRT-LM dem Modell Gemma 4 E2B, Text mit Geschwindigkeiten zu verarbeiten, die für Echtzeitinteraktionen ausreichen. Das System behielt einen geringen Speicherbedarf bei, während es reaktionsfähige generative Fähigkeiten lieferte. Diese Demonstration diente als praktische Referenz für Ingenieure, die Edge-KI in ressourcenbeschränkten Umgebungen implementieren möchten.
Der Leitfaden skizzierte auch das breitere Ökosystem, das diese Bereitstellung unterstützt. Er verwies auf verfügbare Tools für die Modellkonvertierung, Quantisierung und Benchmarking. Durch die Bereitstellung sofort einsatzbereiter Modelle über die LiteRT Hugging Face Community wollte Google die Reibungsverluste reduzieren, die typischerweise mit der Bereitstellung großer Modelle auf Edge-Geräten verbunden sind. Der Fokus lag darauf, hochperformante On-Device-Inferenz durch optimierte Workflows zugänglich zu machen.
Wie es funktioniert
LiteRT dient als zentrale Inferenz-Engine, die sowohl für CPU- als auch für GPU-Ausführung auf ARM-Architekturen optimiert ist. Für den Raspberry Pi 5 nutzt das System die Quad-Core-ARM-Cortex-A76-CPU und die Broadcom VideoCore VII GPU. LiteRT verwendet XNNPACK zur CPU-Beschleunigung, was effiziente Speichernutzung und Ausführung mit geringer Latenz gewährleistet. Dies ermöglicht es dem Gerät, die komplexen mathematischen Operationen großer Sprachmodelle zu bewältigen, ohne zu überhitzen oder ins Stocken zu geraten.
Die Architektur employs eine heterogene parallele Ausführungsstrategie. Anstatt alle Aufgaben auf die CPU zu zwingen, delegiert das System bestimmte Arbeitslasten an die GPU. Beispielsweise laufen kontinuierliche Computer-Vision-Aufgaben wie Objekterkennung auf der GPU, was CPU-Zyklen für die Sprachverarbeitung und Systemorchestrierung freigibt. Diese Arbeitsteilung maximiert die thermische und rechnerische Effizienz des Einplatinencomputers.
LiteRT-LM fungiert als spezialisierte Schicht über der Basis-Laufzeitumgebung und vereinfacht die Bereitstellung von Sprachmodellen. Es handhabt Tokenisierung und Generierungsschleifen effizient. Das Modell Gemma 4 E2B, entwickelt für mobile und Edge-Umgebungen, nutzt memory-mapped Embeddings pro Ebene, um den RAM-Verbrauch zu minimieren. Diese Designentscheidung ist entscheidend, um die Leistung auf Geräten mit begrenzten Speicherressourcen aufrechtzuerhalten.
Wichtige Details
- Hardware: Die Demonstration verwendete einen Raspberry Pi 5 mit einer ARM Cortex-A76 CPU und einer VideoCore VII GPU.
- Modell: Gemma 4 E2B wurde aufgrund seiner Balance aus Schlussfolgerungsfähigkeit und kompakter Größe ausgewählt, die für Edge-Bereitstellungen geeignet ist.
- Leistung: Das System erreichte 99 Tokens/Sekunde für Prefill und 9 Tokens/Sekunde für Decode, mit einem Spitzen-Speicherbedarf von 1432 MB.
- Geschwindigkeit: Die End-to-End-Generierung erreichte ungefähr 27,3 Zeichen pro Sekunde, was etwa 300 Wörtern pro Minute entspricht.
- Tools: Die LiteRT CLI bietet einen einheitlichen Befehlssatz zum Konvertieren, Quantisieren und Ausführen von Modellen aus der Hugging Face Community.
- Pipeline: Die Reachy-Mini-Demo teilte Aufgaben auf: Ultralytics YOLO lief auf der GPU, während Moonshine ASR plus Gemma auf der CPU ausgeführt wurden.
Warum es wichtig ist
Für Software-Ingenieure, die IoT- oder Robotikprodukte entwickeln, beseitigt diese Entwicklung eine große Hürde: die Notwendigkeit einer ständigen Cloud-Verbindung. Das lokale Ausführen von Modellen stellt die Datensicherheit sicher und reduziert die Latenz, was für Echtzeitinteraktionen entscheidend ist. Es senkt zudem die Betriebskosten, da Servergebühren für die Inferenz entfallen. Entwickler können nun anspruchsvolle KI-Agenten auf kostengünstiger, weit verbreiteter Hardware prototypisieren und bereitstellen.
Die Möglichkeit, Vision-Aufgaben auf die GPU auszulagern, während die Sprachverarbeitung auf der CPU verbleibt, bietet einen Bauplan für eine effiziente Edge-Architektur. Dieses Muster ermöglicht es Geräten, multimodale Eingaben – wie Video und Audio – gleichzeitig zu verarbeiten, ohne den Hauptprozessor zu blockieren. Es zeigt, dass moderne Einplatinencomputer in der Lage sind, Arbeitslasten zu bewältigen, die zuvor leistungsstärkeren und teureren Systemen vorbehalten waren.
Darüber hinaus beschleunigt die Verfügbarkeit optimierter Modelle und Tools wie der LiteRT CLI den Entwicklungszyklus. Ingenieure müssen keine komplexen Abhängigkeiten mehr manuell verwalten oder benutzerdefinierten Optimierungscode von Grund auf schreiben. Diese Standardisierung fördert Innovationen in der Edge-KI und ermöglicht es Teams, sich auf die Anwendungslogik statt auf die Infrastruktur-Tuning zu konzentrieren.
Was Sie tun können
- Installieren Sie die LiteRT CLI über pip in einer virtuellen Umgebung, um Zugriff auf einheitliche Edge-KI-Tools zu erhalten.
- Laden Sie das Modell Gemma 4 E2B aus der LiteRT Hugging Face Community herunter, um Tests auf Ihrem Gerät durchzuführen.
- Verwenden Sie die bereitgestellten Code-Snippets, um Inferenz mit Bildanhängen und Text-Prompts auf dem Raspberry Pi 5 auszuführen.
- Erkunden Sie das GitHub-Repository LiteRT-Samples, um Referenzimplementierungen für Sprachübersetzer und Objekterkennung zu finden.
- Experimentieren Sie damit, Computer-Vision-Modelle wie YOLO auf die GPU auszulagern, um CPU-Ressourcen für andere Aufgaben zu schonen.



