Exécution des LLM Gemma sur Raspberry Pi 5 avec LiteRT
Le guide 2026 de Google détaille l'utilisation de LiteRT pour exécuter les modèles Gemma sur Raspberry Pi 5, permettant une inférence en temps réel pour la robotique et les agents edge sans dépendance au cloud.
Traduit automatiquement depuis l'original anglais.
Dans un article publié sur le blog des développeurs Google en août 2026, des ingénieurs ont décrit comment déployer directement des grands modèles de langage (LLM) sur du matériel compact. Le guide se concentrait sur l'exécution de la famille de modèles Gemma de Google sur le Raspberry Pi 5 à l'aide du runtime d'inférence LiteRT. Cette approche permet de créer des applications IA entièrement hors ligne et à faible latence pour la robotique et les agents locaux.
Ce qui s'est passé
L'article a démontré que les développeurs peuvent construire des systèmes autonomes, tels que le robot Reachy Mini, capables de percevoir et de réagir à leur environnement en temps réel sans connexion Internet. En combinant LiteRT avec les modèles Gemma, le système garantit une confidentialité totale des données et une latence ultra-faible. La configuration repose entièrement sur le Raspberry Pi 5, éliminant le besoin de serveurs cloud ou d'accélérateurs externes pour les tâches de base.
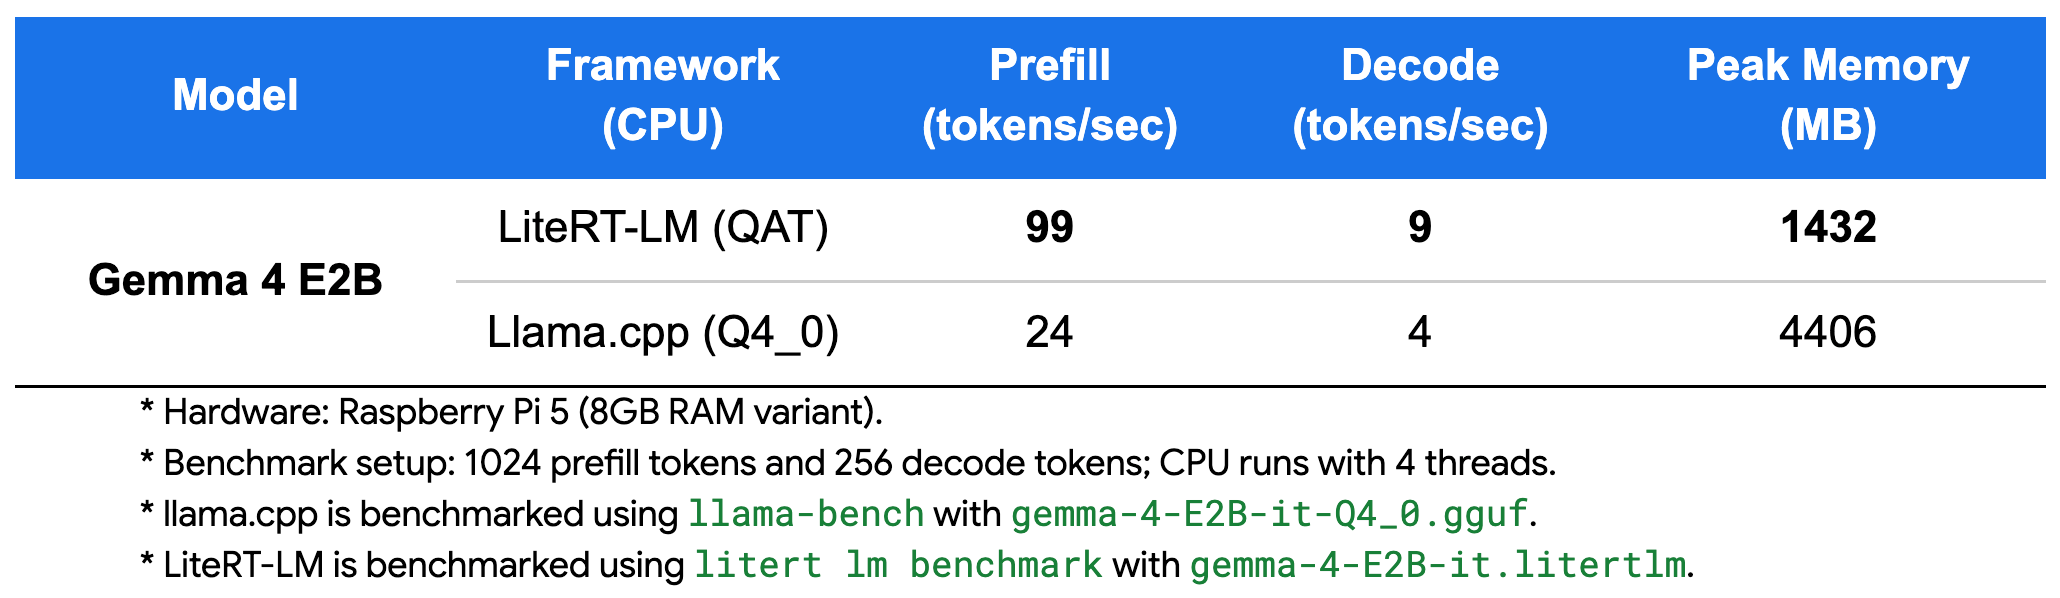
Google a mis en avant des métriques de performance spécifiques pour cette configuration. Sur le Raspberry Pi 5, la couche d'orchestration LiteRT-LM a permis au modèle Gemma 4 E2B de traiter le texte à des vitesses suffisantes pour une interaction en temps réel. Le système a maintenu une empreinte mémoire faible tout en offrant des capacités génératives réactives. Cette démonstration servait de référence pratique pour les ingénieurs cherchant à mettre en œuvre l'IA edge dans des environnements aux ressources limitées.
Le guide a également présenté l'écosystème plus large soutenant ce déploiement. Il a indiqué les outils disponibles pour la conversion, la quantification et le benchmarking des modèles. En fournissant des modèles prêts à l'emploi via la communauté Hugging Face de LiteRT, Google visait à réduire la friction généralement associée au déploiement de grands modèles sur des périphériques edge. L'accent restait sur la mise à disposition d'une inférence haute performance sur appareil via des workflows simplifiés.
Comment cela fonctionne
LiteRT agit comme le moteur d'inférence central, optimisé pour l'exécution sur CPU et GPU sur les architectures ARM. Pour le Raspberry Pi 5, le système exploite le CPU quad-core ARM Cortex-A76 et le GPU Broadcom VideoCore VII. LiteRT utilise XNNPACK pour l'accélération CPU, garantissant une utilisation efficace de la mémoire et une exécution à faible latence. Cela permet à l'appareil de gérer les opérations mathématiques complexes requises par les grands modèles de langage sans surchauffe ni blocage.
L'architecture emploie une stratégie d'exécution parallèle hétérogène. Au lieu de forcer toutes les tâches sur le CPU, le système délègue des charges de travail spécifiques au GPU. Par exemple, les tâches continues de vision par ordinateur, comme la détection d'objets, s'exécutent sur le GPU, libérant ainsi des cycles CPU pour le traitement du langage et l'orchestration système. Cette division du travail maximise l'efficacité thermique et computationnelle de l'ordinateur monocarte.
LiteRT-LM agit comme une couche spécialisée au-dessus du runtime de base, simplifiant le déploiement des modèles de langage. Elle gère efficacement la tokenisation et les boucles de génération. Le modèle Gemma 4 E2B, conçu pour les environnements mobiles et edge, utilise des embeddings par couche mappés en mémoire pour minimiser l'utilisation de la RAM. Ce choix de conception est crucial pour maintenir la performance sur les appareils disposant de ressources mémoire limitées.
Détails clés
- Matériel : La démonstration utilisait un Raspberry Pi 5 équipé d'un CPU ARM Cortex-A76 et d'un GPU VideoCore VII.
- Modèle : Gemma 4 E2B a été sélectionné pour son équilibre entre capacité de raisonnement et taille compacte, adapté au déploiement edge.
- Performance : Le système a atteint 99 tokens/s pour le prefill et 9 tokens/s pour le decode, avec une empreinte mémoire maximale de 1432 Mo.
- Vitesse : La génération de bout en bout a atteint environ 27,3 caractères par seconde, soit environ 300 mots par minute.
- Outils : LiteRT CLI fournit un ensemble de commandes unifié pour convertir, quantifier et exécuter des modèles depuis la communauté Hugging Face.
- Pipeline : La démo Reachy Mini répartissait les tâches, exécutant Ultralytics YOLO sur le GPU et Moonshine ASR ainsi que Gemma sur le CPU.
Pourquoi c'est important
Pour les ingénieurs logiciels développant des produits IoT ou robotiques, cette évolution supprime un obstacle majeur : le besoin constant de connectivité cloud. L'exécution locale des modèles assure la confidentialité des données et réduit la latence, ce qui est crucial pour les interactions en temps réel. Elle diminue également les coûts opérationnels en éliminant les frais de serveur pour l'inférence. Les développeurs peuvent désormais prototyper et déployer des agents IA sophistiqués sur du matériel peu coûteux et largement disponible.
La capacité de déléguer les tâches de vision au GPU tout en maintenant le traitement du langage sur le CPU offre un modèle pour une architecture edge efficace. Ce schéma permet aux appareils de gérer simultanément des entrées multimodales—comme la vidéo et l'audio—sans engorger le processeur principal. Il démontre que les ordinateurs monocartes modernes sont capables de gérer des charges de travail auparavant réservées à des systèmes plus puissants et coûteux.
De plus, la disponibilité de modèles optimisés et d'outils comme LiteRT CLI accélère le cycle de développement. Les ingénieurs n'ont plus besoin de gérer manuellement des dépendances complexes ni d'écrire du code d'optimisation personnalisé depuis zéro. Cette standardisation encourage l'innovation dans l'IA edge, permettant aux équipes de se concentrer sur la logique applicative plutôt que sur le réglage de l'infrastructure.
Ce que vous pouvez faire
- Installez LiteRT CLI via pip dans un environnement virtuel pour accéder aux outils unifiés d'IA edge.
- Téléchargez le modèle Gemma 4 E2B depuis la communauté Hugging Face de LiteRT pour le tester sur votre appareil.
- Utilisez les extraits de code fournis pour effectuer des inférences avec des pièces jointes d'images et des invites textuelles sur Raspberry Pi 5.
- Explorez le dépôt GitHub LiteRT-Samples pour trouver des implémentations de référence pour les traducteurs vocaux et la détection d'objets.
- Expérimentez la délégation des modèles de vision par ordinateur comme YOLO au GPU afin de préserver les ressources CPU pour les tâches LLM.



