Ejecutar modelos LLM Gemma en Raspberry Pi 5 con LiteRT
La guía de Google de 2026 detalla el uso de LiteRT para ejecutar modelos Gemma en Raspberry Pi 5, logrando inferencia en tiempo real para robótica y agentes de borde sin dependencia de la nube.
Traducido automáticamente del original en inglés.
En una publicación del Blog de Desarrolladores de Google en agosto de 2026, los ingenieros describieron cómo desplegar grandes modelos de lenguaje directamente en hardware compacto. La guía se centró en ejecutar la familia de modelos Gemma de Google en la Raspberry Pi 5 utilizando el entorno de ejecución de inferencia LiteRT. Este enfoque permite aplicaciones de IA totalmente offline y de baja latencia para robótica y agentes locales.
Qué ocurrió
El artículo demostró que los desarrolladores pueden construir sistemas autónomos, como el robot Reachy Mini, que perciben y reaccionan a su entorno en tiempo real sin necesidad de conectividad a internet. Al combinar LiteRT con los modelos Gemma, el sistema logra privacidad total de datos y latencia ultrabaja. La configuración depende exclusivamente de la Raspberry Pi 5, eliminando la necesidad de servidores en la nube o aceleradores externos para tareas básicas.
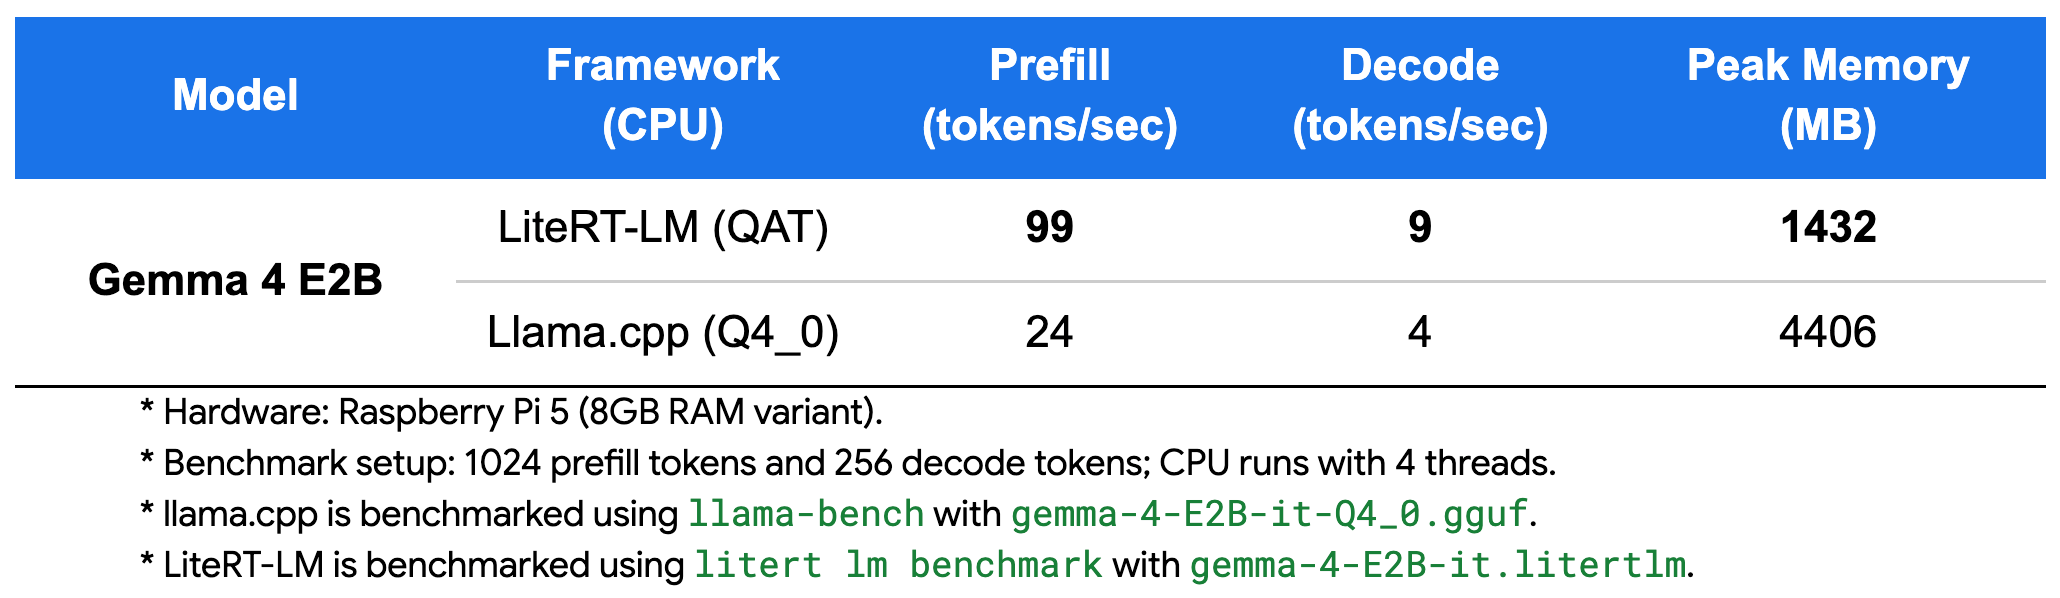
Google destacó métricas de rendimiento específicas para esta configuración. En la Raspberry Pi 5, la capa de orquestación LiteRT-LM permitió que el modelo Gemma 4 E2B procesara texto a velocidades suficientes para interacción en tiempo real. El sistema mantuvo una huella de memoria reducida mientras ofrecía capacidades generativas responsivas. Esta demostración sirvió como referencia práctica para ingenieros que buscan implementar IA en el borde (edge AI) en entornos con recursos limitados.
La guía también delineó el ecosistema más amplio que soporta este despliegue. Señaló herramientas disponibles para conversión de modelos, cuantización y pruebas de rendimiento (benchmarking). Al proporcionar modelos listos para usar a través de la Comunidad Hugging Face de LiteRT, Google buscó reducir la fricción asociada típicamente al despliegue de modelos grandes en dispositivos de borde. El foco permaneció en hacer accesible la inferencia de alto rendimiento en dispositivo mediante flujos de trabajo simplificados.
Cómo funciona
LiteRT actúa como el motor central de inferencia, optimizado para ejecución tanto en CPU como en GPU sobre arquitecturas ARM. Para la Raspberry Pi 5, el sistema aprovecha la CPU ARM Cortex-A76 de cuatro núcleos y la GPU Broadcom VideoCore VII. LiteRT utiliza XNNPACK para aceleración por CPU, garantizando un uso eficiente de la memoria y ejecución de baja latencia. Esto permite al dispositivo manejar las complejas operaciones matemáticas requeridas por los grandes modelos de lenguaje sin sobrecalentarse ni bloquearse.
La arquitectura emplea una estrategia de ejecución paralela heterogénea. En lugar de forzar todas las tareas a la CPU, el sistema delega cargas de trabajo específicas a la GPU. Por ejemplo, tareas continuas de visión por computadora como la detección de objetos se ejecutan en la GPU, liberando ciclos de CPU para el procesamiento de lenguaje y la orquestación del sistema. Esta división del trabajo maximiza la eficiencia térmica y computacional de la computadora de placa única.
LiteRT-LM actúa como una capa especializada sobre el runtime base, simplificando el despliegue de modelos de lenguaje. Maneja eficientemente los bucles de tokenización y generación. El modelo Gemma 4 E2B, diseñado para entornos móviles y de borde, utiliza embeddings por capa mapeados en memoria para minimizar el uso de RAM. Esta decisión de diseño es crítica para mantener el rendimiento en dispositivos con recursos de memoria limitados.
Detalles clave
- Hardware: La demostración utilizó una Raspberry Pi 5 con CPU ARM Cortex-A76 y GPU VideoCore VII.
- Modelo: Se seleccionó Gemma 4 E2B por su equilibrio entre capacidad de razonamiento y tamaño compacto, adecuado para despliegue en el borde.
- Rendimiento: El sistema alcanzó 99 tokens/segundo para prefill y 9 tokens/segundo para decode, con una huella máxima de memoria de 1432 MB.
- Velocidad: La generación de extremo a extremo alcanzó aproximadamente 27.3 caracteres por segundo, o alrededor de 300 palabras por minuto.
- Herramientas: LiteRT CLI proporciona un conjunto de comandos unificado para convertir, cuantizar y ejecutar modelos desde la Comunidad Hugging Face.
- Pipeline: La demo de Reachy Mini dividió las tareas, ejecutando Ultralytics YOLO en la GPU y Moonshine ASR más Gemma en la CPU.
Por qué importa
Para ingenieros de software que construyen productos IoT o de robótica, este desarrollo elimina una barrera importante: la necesidad de conectividad constante a la nube. Ejecutar modelos localmente asegura la privacidad de datos y reduce la latencia, crucial para interacciones en tiempo real. También disminuye los costos operativos al eliminar las tarifas de servidor para la inferencia. Los desarrolladores ahora pueden prototipar y desplegar agentes de IA sofisticados en hardware económico y ampliamente disponible.
La capacidad de descargar tareas de visión a la GPU mientras se mantiene el procesamiento de lenguaje en la CPU ofrece un modelo para una arquitectura de borde eficiente. Este patrón permite a los dispositivos manejar entradas multimodales —como video y audio— simultáneamente sin saturar el procesador principal. Demuestra que las modernas computadoras de placa única son capaces de manejar cargas de trabajo previamente reservadas para sistemas más potentes y costosos.
Además, la disponibilidad de modelos optimizados y herramientas como LiteRT CLI acelera el ciclo de desarrollo. Los ingenieros ya no necesitan gestionar manualmente dependencias complejas ni escribir código de optimización personalizado desde cero. Esta estandarización fomenta la innovación en IA de borde, permitiendo a los equipos enfocarse en la lógica de aplicación en lugar de en el ajuste de infraestructura.
Qué puedes hacer
- Instala LiteRT CLI usando pip en un entorno virtual para acceder a herramientas unificadas de IA de borde.
- Descarga el modelo Gemma 4 E2B de la Comunidad Hugging Face de LiteRT para probarlo en tu dispositivo.
- Usa los fragmentos de código proporcionados para ejecutar inferencia con adjuntos de imagen y prompts de texto en Raspberry Pi 5.
- Explora el repositorio GitHub LiteRT-Samples para encontrar implementaciones de referencia para traductores de voz y detección de objetos.
- Experimenta descargando modelos de visión por computadora como YOLO a la GPU para preservar recursos de CPU para tareas de LLM.



