Chạy mô hình LLM Gemma trên Raspberry Pi 5 với LiteRT
Hướng dẫn năm 2026 của Google trình bày chi tiết cách sử dụng LiteRT để chạy các mô hình Gemma trên Raspberry Pi 5, đạt được suy luận thời gian thực cho robot và tác nhân edge mà không phụ thuộc vào đám mây.
Được dịch tự động từ bản gốc tiếng Anh.
Trong một bài đăng trên Google Developers Blog vào tháng 8 năm 2026, các kỹ sư đã mô tả cách triển khai trực tiếp các mô hình ngôn ngữ lớn trên phần cứng nhỏ gọn. Hướng dẫn tập trung vào việc chạy dòng mô hình Gemma của Google trên Raspberry Pi 5 bằng runtime suy luận LiteRT. Cách tiếp cận này cho phép xây dựng các ứng dụng AI ngoại tuyến hoàn toàn, độ trễ thấp cho robot và các tác nhân cục bộ.
Điều gì đã xảy ra
Bài viết chứng minh rằng các nhà phát triển có thể xây dựng các hệ thống tự động, chẳng hạn như robot Reachy Mini, có khả năng cảm nhận và phản hồi với môi trường xung quanh theo thời gian thực mà không cần kết nối internet. Bằng cách kết hợp LiteRT với các mô hình Gemma, hệ thống đạt được quyền riêng tư dữ liệu tuyệt đối và độ trễ cực thấp. Thiết lập này hoàn toàn dựa vào Raspberry Pi 5, loại bỏ nhu cầu về máy chủ đám mây hoặc bộ tăng tốc bên ngoài cho các tác vụ cơ bản.
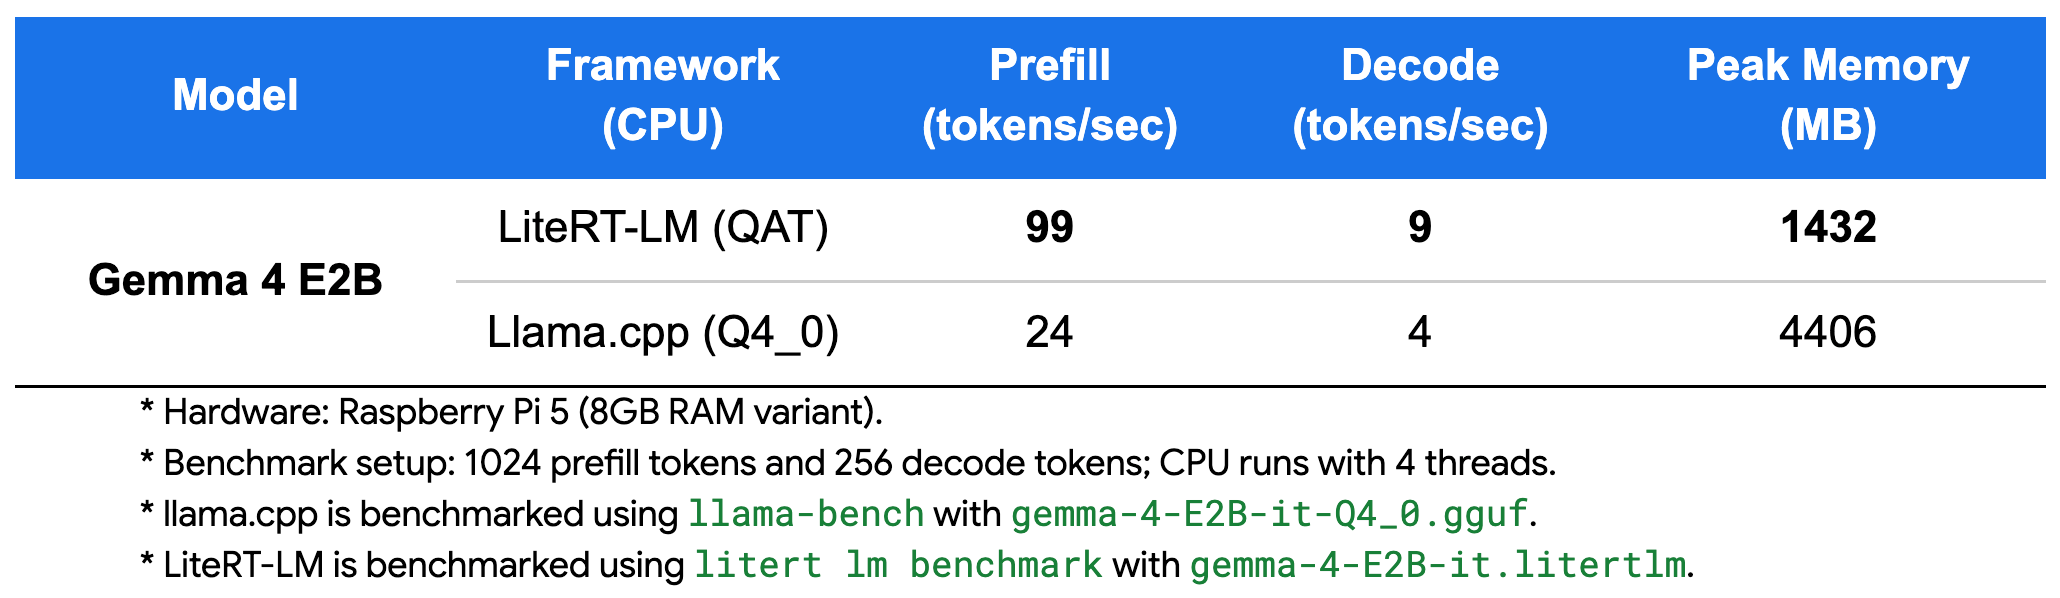
Google đã làm nổi bật các chỉ số hiệu suất cụ thể cho cấu hình này. Trên Raspberry Pi 5, lớp điều phối LiteRT-LM cho phép mô hình Gemma 4 E2B xử lý văn bản ở tốc độ đủ cho tương tác thời gian thực. Hệ thống duy trì mức tiêu thụ bộ nhớ thấp trong khi vẫn cung cấp khả năng tạo nội dung phản hồi nhanh chóng. Buổi demo này đóng vai trò là tài liệu tham khảo thực tế cho các kỹ sư muốn triển khai AI edge trong các môi trường bị giới hạn về tài nguyên.
Hướng dẫn cũng phác thảo hệ sinh thái rộng lớn hơn hỗ trợ cho việc triển khai này. Nó chỉ ra các công cụ hiện có để chuyển đổi mô hình, lượng tử hóa (quantization) và benchmarking. Bằng cách cung cấp các mô hình sẵn sàng sử dụng thông qua Cộng đồng Hugging Face của LiteRT, Google nhằm giảm bớt những rào cản thường gặp khi triển khai các mô hình lớn trên thiết bị edge. Trọng tâm vẫn là làm cho suy luận trên thiết bị hiệu suất cao trở nên dễ tiếp cận thông qua các quy trình làm việc được tối ưu hóa.
Cách thức hoạt động
LiteRT đóng vai trò là engine suy luận cốt lõi, được tối ưu hóa cho cả việc thực thi CPU và GPU trên kiến trúc ARM. Đối với Raspberry Pi 5, hệ thống tận dụng CPU ARM Cortex-A76 bốn lõi và GPU Broadcom VideoCore VII. LiteRT sử dụng XNNPACK để tăng tốc CPU, đảm bảo sử dụng bộ nhớ hiệu quả và thực thi độ trễ thấp. Điều này cho phép thiết bị xử lý các phép toán phức tạp yêu cầu bởi các mô hình ngôn ngữ lớn mà không bị quá nhiệt hoặc đình trệ.
Kiến trúc áp dụng chiến lược thực thi song song dị thể. Thay vì ép tất cả các tác vụ lên CPU, hệ thống giao phó các khối lượng công việc cụ thể cho GPU. Ví dụ, các tác vụ thị giác máy tính liên tục như phát hiện đối tượng chạy trên GPU, giải phóng chu kỳ CPU cho việc xử lý ngôn ngữ và điều phối hệ thống. Sự phân chia lao động này tối đa hóa hiệu quả nhiệt và tính toán của máy tính bảng đơn (single-board computer).
LiteRT-LM hoạt động như một lớp chuyên biệt nằm trên runtime cơ bản, đơn giản hóa việc triển khai các mô hình ngôn ngữ. Nó xử lý hiệu quả các vòng lặp token hóa và tạo sinh. Mô hình Gemma 4 E2B, được thiết kế cho môi trường di động và edge, sử dụng embedding theo từng lớp ánh xạ bộ nhớ (memory-mapped) để giảm thiểu việc sử dụng RAM. Lựa chọn thiết kế này rất quan trọng để duy trì hiệu suất trên các thiết bị có tài nguyên bộ nhớ hạn chế.
Chi tiết chính
- Phần cứng: Buổi demo sử dụng Raspberry Pi 5 với CPU ARM Cortex-A76 và GPU VideoCore VII.
- Mô hình: Gemma 4 E2B được lựa chọn nhờ sự cân bằng giữa khả năng suy luận và kích thước nhỏ gọn, phù hợp cho triển khai edge.
- Hiệu suất: Hệ thống đạt 99 tokens/giây cho giai đoạn prefill và 9 tokens/giây cho giai đoạn decode, với mức tiêu thụ bộ nhớ đỉnh điểm là 1432 MB.
- Tốc độ: Quá trình tạo sinh end-to-end đạt khoảng 27,3 ký tự mỗi giây, tương đương khoảng 300 từ mỗi phút.
- Công cụ: LiteRT CLI cung cấp một bộ lệnh thống nhất để chuyển đổi, lượng tử hóa và chạy các mô hình từ Cộng đồng Hugging Face.
- Quy trình: Demo Reachy Mini chia tách các tác vụ, chạy Ultralytics YOLO trên GPU và Moonshine ASR cùng Gemma trên CPU.
Tại sao điều này quan trọng
Đối với các kỹ sư phần mềm xây dựng sản phẩm IoT hoặc robotics, sự phát triển này loại bỏ một rào cản lớn: nhu cầu kết nối đám mây liên tục. Việc chạy các mô hình cục bộ đảm bảo quyền riêng tư dữ liệu và giảm độ trễ, điều rất quan trọng cho các tương tác thời gian thực. Nó cũng hạ thấp chi phí vận hành bằng cách loại bỏ phí máy chủ cho suy luận. Các nhà phát triển giờ đây có thể thử nghiệm và triển khai các tác nhân AI tinh vi trên phần cứng giá rẻ, phổ biến.
Khả năng chuyển các tác vụ thị giác sang GPU trong khi giữ xử lý ngôn ngữ trên CPU cung cấp một bản thiết kế cho kiến trúc edge hiệu quả. Mẫu hình này cho phép các thiết bị xử lý đồng thời các đầu vào đa phương thức—chẳng hạn như video và âm thanh—mà không gây nghẽn cổ chai cho bộ xử lý chính. Nó chứng minh rằng các máy tính bảng đơn hiện đại có khả năng xử lý các khối lượng công việc trước đây chỉ dành cho các hệ thống mạnh mẽ và đắt tiền hơn.
Hơn nữa, sự sẵn có của các mô hình được tối ưu hóa và các công cụ như LiteRT CLI đẩy nhanh chu kỳ phát triển. Các kỹ sư không còn cần phải quản lý thủ công các dependency phức tạp hoặc viết mã tối ưu hóa tùy chỉnh từ đầu. Sự chuẩn hóa này khuyến khích đổi mới trong AI edge, cho phép các đội ngũ tập trung vào logic ứng dụng thay vì tinh chỉnh hạ tầng.
Bạn có thể làm gì
- Cài đặt LiteRT CLI bằng pip trong một môi trường ảo để truy cập các công cụ AI edge thống nhất.
- Tải xuống mô hình Gemma 4 E2B từ Cộng đồng Hugging Face của LiteRT để kiểm tra trên thiết bị của bạn.
- Sử dụng các đoạn mã được cung cấp để chạy suy luận với tệp đính kèm hình ảnh và lời nhắc văn bản trên Raspberry Pi 5.
- Khám phá repo GitHub LiteRT-Samples để tìm các triển khai tham khảo cho dịch giả giọng nói và phát hiện đối tượng.
- Thử nghiệm việc chuyển các mô hình thị giác máy tính như YOLO sang GPU để bảo toàn tài nguyên CPU cho các tác vụ LLM.
- Giám sát mức sử dụng bộ nhớ và hiệu suất nhiệt để đảm bảo ứng dụng cụ thể của bạn nằm trong giới hạn của thiết bị.



