Raspberry Pi 5でLiteRTを使いGemma LLMを実行する
Googleの2026年ガイドでは、LiteRTを使用してRaspberry Pi 5上でGemmaモデルを実行し、クラウド依存なしでロボティクスやエッジエージェント向けのリアルタイム推論を実現する方法が詳細に説明されています。
英語の原文から自動翻訳されました。
2026年8月のGoogle Developers Blogの投稿で、エンジニアたちはコンパクトなハードウェア上に大規模言語モデル(LLM)を直接デプロイする方法について解説しました。このガイドは、LiteRT推論ランタイムを使用してRaspberry Pi 5上でGoogleのGemmaファミリーモデルを実行することに焦点を当てています。このアプローチにより、ロボティクスやローカルエージェント向けに、完全オフラインかつ低遅延のAIアプリケーションが可能になります。
何が起きたか
この記事は、Reachy Miniロボットのような自律システムを開発者が構築できることを実証しました。これらのシステムはインターネット接続なしで環境を認識し、リアルタイムで反応します。LiteRTとGemmaモデルを組み合わせることで、システムは完全なデータプライバシーと超低遅延を実現します。セットアップは完全にRaspberry Pi 5に依存しており、基本的なタスクのためにクラウドサーバーや外部アクセラレーターが必要なくなります。
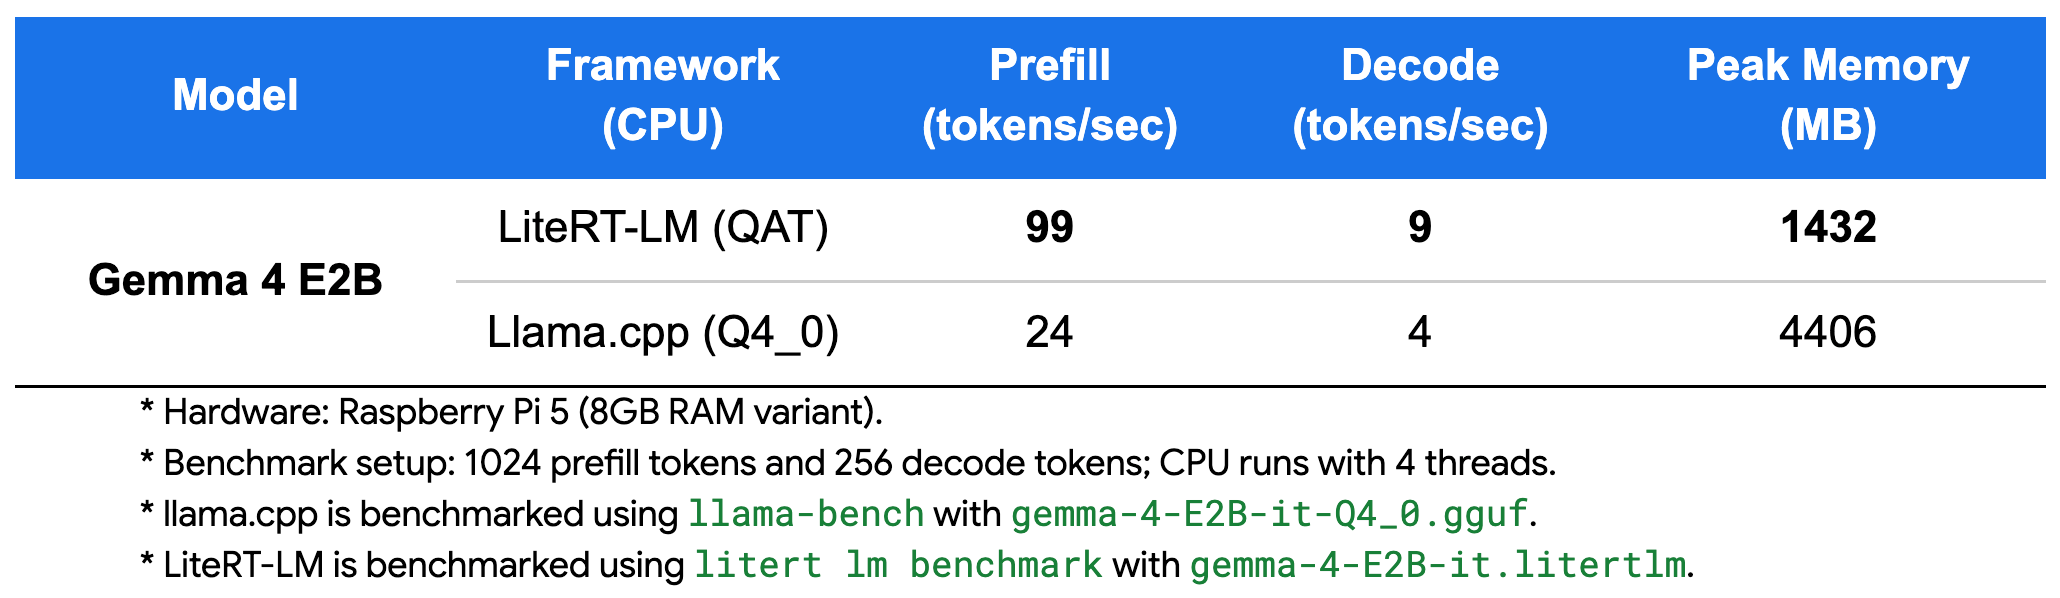
Googleはこの構成における具体的なパフォーマンス指標を強調しました。Raspberry Pi 5上では、LiteRT-LMオーケストレーションレイヤーにより、Gemma 4 E2Bモデルがリアルタイムインタラクションに十分な速度でテキストを処理できました。システムは応答性の高い生成機能を備えつつ、低いメモリフットプリントを維持しました。このデモは、リソース制約のある環境でエッジAIを実装しようとするエンジニアにとっての実用的な参考例となりました。
ガイドでは、このデプロイを支えるより広範なエコシステムも概説されました。モデル変換、量子化、ベンチマーキングのための利用可能なツールが示唆されました。LiteRT Hugging Face Communityを通じてすぐに使えるモデルを提供することで、Googleはエッジデバイス上大規模モデルをデプロイする際によくある摩擦を軽減することを目指しました。焦点は、簡素化されたワークフローを通じて高性能なオンデバイス推論をアクセス可能にする点に置かれました。
仕組み
LiteRTは、ARMアーキテクチャでのCPUおよびGPU実行用に最適化されたコア推論エンジンとして機能します。Raspberry Pi 5の場合、システムはクアッドコアARM Cortex-A76 CPUとBroadcom VideoCore VII GPUを活用します。LiteRTはCPUアクセラレーションにXNNPACKを使用し、効率的なメモリ使用量と低遅延実行を保証します。これにより、デバイスは過熱やスタリングを起こすことなく、大規模言語モデルに必要な複雑な数学的演算を処理できます。
アーキテクチャはヘテロジニアス並列実行戦略を採用しています。すべてのタスクをCPUに強制する代わりに、システムは特定のワークロードをGPUに委任します。例えば、物体検出などの連続的なコンピュータビジョンタスクはGPUで実行され、言語処理とシステムオーケストレーションのためにCPUサイクルを解放します。この分業により、シングルボードコンピュータの熱効率と計算効率が最大化されます。
LiteRT-LMはベースランタイム上の専門的なレイヤーとして機能し、言語モデルのデプロイを簡素化します。トークン化と生成ループを効率的に処理します。モバイルおよびエッジ環境向けに設計されたGemma 4 E2Bモデルは、RAM使用量を最小限に抑えるためにメモリーマップ方式の層別埋め込みを使用します。この設計選択は、メモリリソースが限られたデバイスでパフォーマンスを維持するために重要です。
主要な詳細
- ハードウェア: デモにはARM Cortex-A76 CPUとVideoCore VII GPUを搭載したRaspberry Pi 5が使用されました。
- モデル: Gemma 4 E2Bは、推論能力とコンパクトサイズのバランスがエッジデプロイに適しているため選択されました。
- パフォーマンス: システムはプリフィルで99 tokens/sec、デコードで9 tokens/secを達成し、ピークメモリフットプリントは1432 MBでした。
- 速度: エンドツーエンドの生成は約27.3文字/秒、つまり約300ワード/分に達しました。
- ツール: LiteRT CLIは、Hugging Face Communityからのモデルの変換、量子化、実行のための統一コマンドセットを提供します。
- パイプライン: Reachy Miniデモではタスクを分割し、Ultralytics YOLOをGPUで、Moonshine ASRとGemmaをCPUで実行しました。
なぜ重要なのか
IoTやロボティクス製品を開発するソフトウェアエンジニアにとって、この進展は大きな障壁を取り除きます。それは、絶え間ないクラウド接続の必要性です。モデルをローカルで実行することはデータプライバシーを保証し、遅延を削減します。これはリアルタイムインタラクションにとって不可欠です。また、推論のためのサーバー費用を排除することで運用コストも低減します。開発者は現在、安価で広く入手可能なハードウェア上で洗練されたAIエージェントのプロトタイプ作成とデプロイが可能になりました。
視覚タスクをGPUにオフロードしつつ言語処理をCPUに残す能力は、効率的なエッジアーキテクチャのための青写真を提供します。このパターンにより、デバイスはメインプロセッサをボトルネックにすることなく、ビデオや音声などのマルチモーダル入力を同時に処理できます。これは、現代のシングルボードコンピュータが、以前はより強力かつ高価なシステム専用だったワークロードを処理できる能力を持つことを実証しています。
さらに、LiteRT CLIのような最適化されたモデルとツールの可用性は、開発サイクルを加速します。エンジニアはもはや、複雑な依存関係を手動で管理したり、ゼロからカスタム最適化コードを書いたりする必要がありません。この標準化はエッジAIにおけるイノベーションを奨励し、チームがインフラストラクチャのチューニングではなくアプリケーションロジックに集中できるようにします。
あなたができること
- 仮想環境内のpipを使用してLiteRT CLIをインストールし、統一されたエッジAIツールにアクセスしてください。
- お使いのデバイスでのテスト用に、LiteRT Hugging Face CommunityからGemma 4 E2Bモデルをダウンロードしてください。
- 提供されているコードスニペットを使用して、Raspberry Pi 5上で画像添付とテキストプロンプトを用いた推論を実行してください。
- 音声翻訳者や物体検出のリファレンス実装を見つけるために、LiteRT-Samples GitHubリポジトリを検討してください。
- LLMタスクのためにCPUリソースを確保するため、YOLOなどのコンピュータビジョンモデルをGPUにオフロードすることを試してみてください。
- メモリ使用量と熱性能を監視し、特定のアプリケーションがデバイスの制限内に収まるようにしてください。



