Tối ưu hóa mô hình khuếch tán Avatar IV của HeyGen cho Google Cloud TPU
Các kỹ sư từ HeyGen và Google Cloud chia sẻ chi tiết về cách họ chuyển đổi quy trình tạo video Avatar IV sang các chip TPU Trillium v6e, đạt được tốc độ nhanh hơn 1,86 lần thông qua tối ưu hóa kernel và chiến lược song song hóa.

Được dịch tự động từ bản gốc tiếng Anh.
Trong một bài đăng trên Google Developers Blog vào tháng 8 năm 2026, các kỹ sư từ HeyGen và Google Cloud đã mô tả cách họ chuyển đổi quy trình tạo video Avatar IV sang các Đơn vị Xử lý Tensor (Tensor Processing Units - TPU) Trillium v6e của Google. Sự hợp tác này dẫn đến cải thiện hiệu suất 1,86 lần so với phiên bản TPU ban đầu, cho phép mô hình khuếch tán phức tạp truyền phát trực tiếp các video chân dung nói chuyện chất lượng cao một cách hiệu quả hơn.
Chuyện gì đã xảy ra
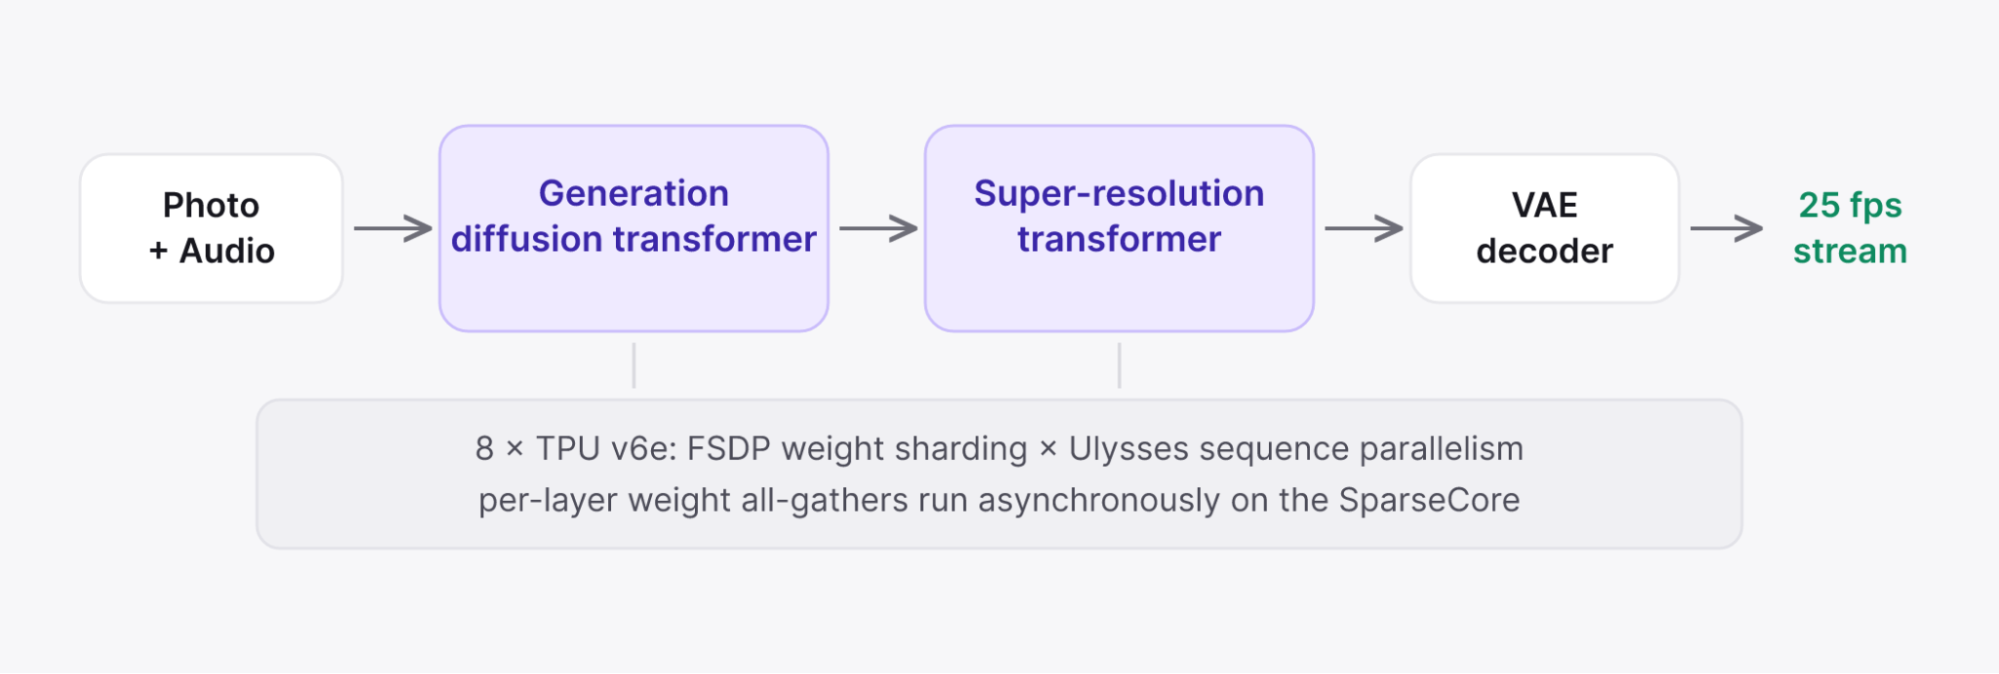
Avatar IV của HeyGen là một mô hình AI quy mô lớn, tạo ra video chân dung nói chuyện từ một bức ảnh duy nhất và một track âm thanh. Hệ thống dựa trên stack khuếch tán với hơn 18 tỷ tham số, bao gồm ba mô hình riêng biệt: một transformer khuếch tán để kết xuất chuyển động, một transformer siêu phân giải và một bộ giải mã VAE. Các mô hình này xử lý video theo từng đoạn nhỏ (chunk) để hỗ trợ phát trực tiếp, nghĩa là bất kỳ độ trễ nào trong quá trình xử lý một đoạn đều gây ra hiện tượng giật lag nhìn thấy được trong video cuối cùng. Để đáp ứng các yêu cầu khắt khe về độ trễ, nhóm đã làm việc với đội ngũ tối ưu hóa hiệu suất cơ sở hạ tầng AI của Google Cloud để di chuyển khối lượng công việc từ GPU sang một máy chủ gồm tám chip Trillium v6e.
Quá trình di chuyển bắt đầu bằng việc chuyển đổi chức năng sử dụng torchax, một frontend PyTorch trên JAX, cho phép chạy mã sản xuất hiện có mà không cần sửa đổi trên TPU. Tuy nhiên, phiên bản ban đầu không đủ nhanh cho các tiêu chuẩn sản xuất. Các nhóm kỹ thuật đã xác định ba nút thắt chính, hay còn gọi là "bức tường", ngăn cản hiệu suất tối ưu: các tập hợp giao tiếp all-to-all bị lộ trong lưới (mesh), các block không đầy đủ trong lưới attention thưa (sparse attention grid) và sự phụ thuộc tuần tự trong vòng lặp softmax bên trong. Qua sáu cột mốc, các nhóm đã hệ thống hóa việc giải quyết những vấn đề này thông qua tùy chỉnh kernel và điều chỉnh trình biên dịch, cuối cùng giảm thời gian xử lý mỗi đoạn video được tạo xuống gần một nửa so với phiên bản TPU hoạt động đầu tiên.
Cách thức hoạt động
Những cải thiện về hiệu suất đạt được bằng cách đồng bộ kiến trúc phần mềm với các đặc điểm phần cứng cụ thể của TPU Trillium. Vì trọng số mô hình vượt quá bộ nhớ băng thông cao của một chip đơn lẻ, nhóm đã sử dụng Fully Sharded Data Parallelism (FSDP) để phân phối trọng số trên lưới tám chip. Họ kết hợp điều này với Ulysses sequence parallelism, phương pháp chia nhỏ chính chuỗi video trên các chip. Một nhận định then chốt là tận dụng SparseCore của Trillium, một bộ đồng xử lý (co-processor) xử lý việc thu thập trọng số một cách bất đồng bộ. Bằng cách chuyển các thao tác di chuyển bộ nhớ này sang SparseCore, các đơn vị ma trận chính vẫn trống cho việc tính toán, qua đó che giấu chi phí của việc phân mảnh dữ liệu.
Để giải quyết các nút thắt giao tiếp, các kỹ sư đã pipeline hóa các tập hợp all-to-all cần thiết bởi Ulysses parallelism. Thay vì thực hiện các chuyển giao dữ liệu này một cách đồng bộ, họ chia các head attention thành các nhóm độc lập. Điều này cho phép việc chuyển giao dữ liệu của một nhóm chồng lấn với việc tính toán của nhóm khác, đưa giao tiếp ra khỏi đường dẫn quan trọng (critical path). Ngoài ra, họ đã tối ưu hóa kernel sparse attention ở giai đoạn siêu phân giải bằng cách điều chỉnh kích thước block khớp chính xác với ranh giới khung hình. Việc căn chỉnh này loại bỏ nhu cầu về các predicate mask phức tạp và padding, đơn giản hóa kernel và giảm lưu lượng thanh ghi. Cuối cùng, họ thay thế phép tính max online softmax tuần tự bằng một cận trên được tính toán trước suy ra từ vector norms, loại bỏ sự phụ thuộc tuần tự khỏi vòng lặp nóng nhất bên trong.
Chi tiết chính
- Quy trình đã tối ưu chạy trên máy chủ tám chip Trillium v6e và nhanh hơn 1,86 lần so với bản chuyển đổi TPU ban đầu.
- Avatar IV sử dụng hơn 18 tỷ tham số và tạo ra video 720p hoặc 1080p ở tốc độ 25 khung hình/giây.
- Nhóm đã sử dụng torchax để chạy mã PyTorch trên JAX, tránh việc phải viết lại hoàn toàn bằng JAX native.
- Ba tối ưu hóa chính bao gồm pipeline hóa các tập hợp all-to-all, căn chỉnh các block sparse attention với ranh giới khung hình và loại bỏ sự phụ thuộc softmax tuần tự.
- Giải pháp cuối cùng tiết kiệm chi phí lên tới 25% mỗi phút video được tạo so với cấu hình GPU 8xH100.
- Tất cả các thay đổi đều vượt qua các cổng kiểm tra chất lượng nghiêm ngặt, bao gồm băm giống hệt nhau từng byte cho việc re-tiling và dải tương đồng hẹp cho các thay đổi thứ tự giảm thiểu (reduction order).
Tại sao điều này quan trọng
Đối với các kỹ sư xây dựng phương tiện truyền thông tạo sinh thời gian thực, nghiên cứu tình huống này nhấn mạnh tầm quan trọng của thiết kế phần mềm nhận biết phần cứng. Chỉ đơn thuần chuyển đổi mô hình sang các bộ tăng tốc mới hiếm khi đủ cho các khối lượng công việc sản xuất. Khoảng cách hiệu suất đáng kể giữa bản chuyển đổi ban đầu và phiên bản đã tối ưu cuối cùng chứng minh rằng những thay đổi sâu ở cấp độ kernel thường là cần thiết để khai thác hết tiềm năng của phần cứng chuyên dụng như TPU. Các kỹ thuật được mô tả, chẳng hạn như pipeline hóa các tập hợp và căn chỉnh cấu trúc dữ liệu với các ràng buộc phần cứng, có thể áp dụng cho các tác vụ suy luận phân tán quy mô lớn khác.
Hơn nữa, việc nhấn mạnh vào duy trì chất lượng đầu ra trong khi tối ưu hóa tốc độ cung cấp một khuôn mẫu quan trọng cho việc triển khai AI đáng tin cậy. Phương pháp thử nghiệm nghiêm ngặt của nhóm, bao gồm so sánh với hai baseline và đánh giá từng khung hình mù (blind review), đảm bảo rằng lợi ích về hiệu suất không đánh đổi bằng độ trung thực hình ảnh. Cách tiếp cận này rất cần thiết cho các sản phẩm hướng tới người dùng, nơi các lỗi hiển thị (artifacts) hoặc sự không nhất quán có thể ảnh hưởng nghiêm trọng đến trải nghiệm người dùng. Kết quả là một hệ thống tương đương về hiệu suất với các cụm GPU cao cấp nhưng mang lại hiệu quả chi phí tốt hơn, giúp việc tạo video chất lượng cao trở nên dễ tiếp cận hơn.
Bạn có thể làm gì
- Kiểm toán các quy trình huấn luyện hoặc suy luận phân tán của bạn để tìm các tập hợp all-to-all bị lộ.
- Căn chỉnh các cấu trúc dữ liệu và kernel với các ràng buộc phần cứng cụ thể.
- Xem xét sử dụng các bộ đồng xử lý hoặc tính năng phần cứng chuyên dụng để che giấu chi phí giao tiếp và bộ nhớ.
- Thiết lập các quy trình kiểm tra chất lượng chặt chẽ để đảm bảo tối ưu hóa hiệu suất không làm giảm chất lượng đầu ra.



