Optimierung des HeyGen-Avatar-IV-Diffusionsmodells für Google Cloud TPUs
Ingenieure von HeyGen und Google Cloud erläutern, wie sie die Video-Generierungspipeline Avatar IV auf Trillium v6e TPUs portiert haben. Durch Kernel-Optimierungen und Parallelisierungsstrategien erzielten sie eine Beschleunigung um den Faktor 1,86.

Automatisch aus dem englischen Original übersetzt.
In einem Beitrag im Google Developers Blog vom August 2026 beschrieben Ingenieure von HeyGen und Google Cloud, wie sie die Pipeline zur Video-Generierung Avatar IV auf Googles Tensor Processing Units (TPUs) der Serie Trillium v6e portiert haben. Die Zusammenarbeit führte zu einer Leistungsverbesserung um den Faktor 1,86 gegenüber der ersten TPU-Version, sodass das komplexe Diffusionsmodell qualitativ hochwertige Talking-Head-Videos effizienter streamen kann.
Was passiert ist
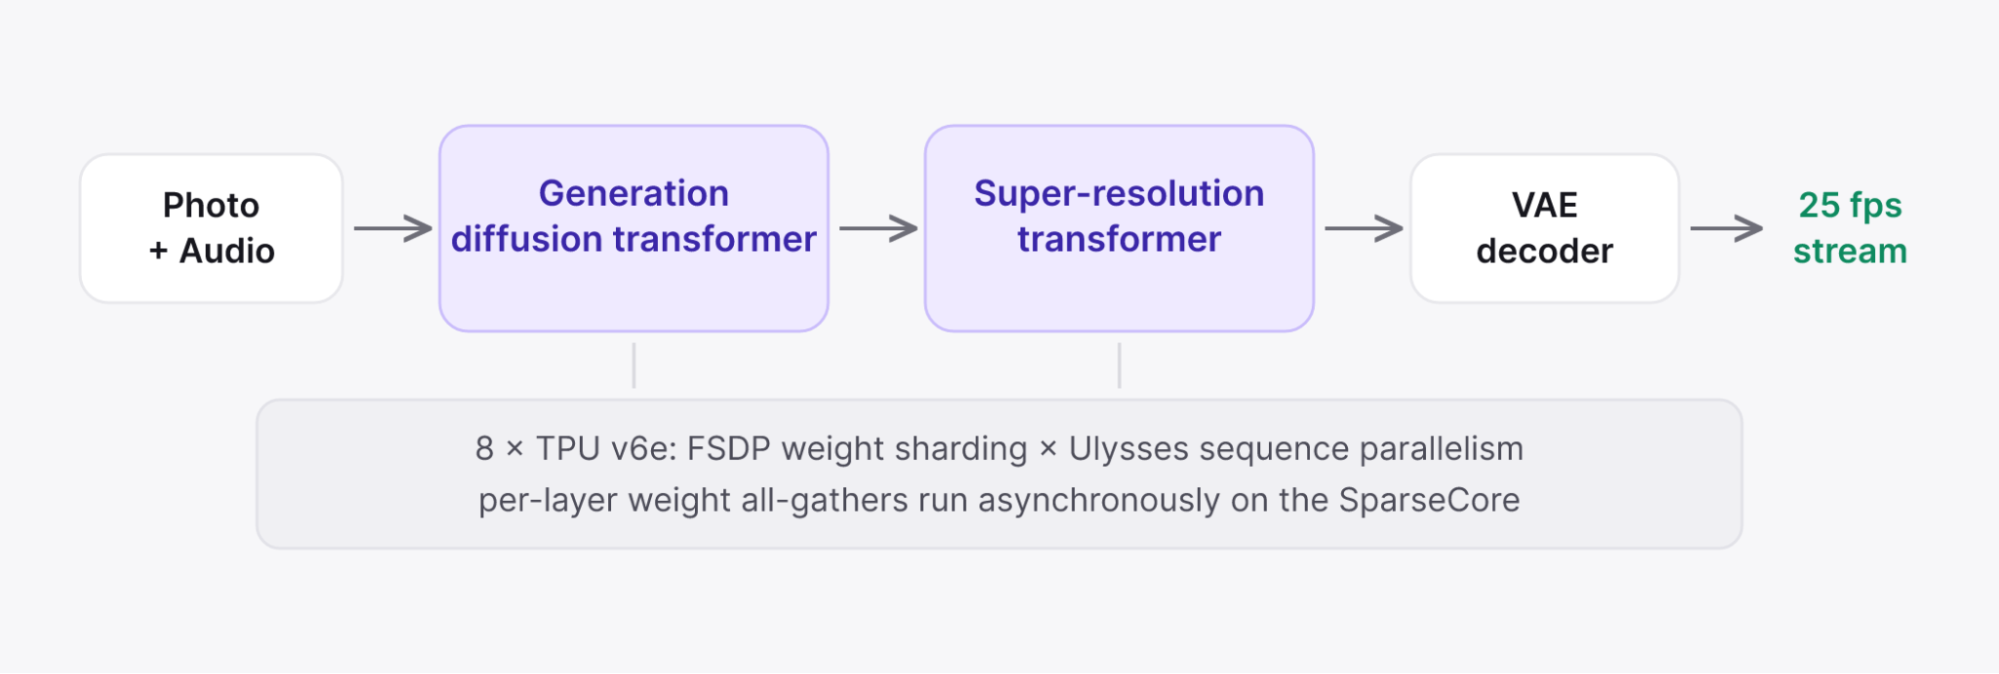
HeyGens Avatar IV ist ein großskaliges KI-Modell, das aus einem einzelnen Foto und einer Audiospur Talking-Head-Videos generiert. Das System basiert auf einem Diffusions-Stack mit mehr als 18 Milliarden Parametern und umfasst drei unterschiedliche Modelle: einen Diffusion Transformer für die Bewegungsrendering, einen Super-Resolution Transformer und einen VAE-Decoder. Diese Modelle verarbeiten Videos in Chunks, um Streaming-Wiedergabe zu ermöglichen; Verzögerungen bei der Verarbeitung eines Chunks führen daher zu sichtbaren Aussetzern im finalen Video. Um strenge Latenzvorgaben einzuhalten, arbeitete das Team mit dem Performance-Optimierungsteam für AI-Infrastruktur von Google Cloud zusammen, um die Workload von GPUs auf einen Host mit acht Trillium-v6e-Chips zu migrieren.
Der Migrationsprozess begann mit einer funktionalen Portierung unter Verwendung von torchax, einer PyTorch-Frontend-Lösung für JAX, die es ermöglichte, den bestehenden Produktionscode ohne Änderungen auf TPUs auszuführen. Die erste Version war jedoch nicht schnell genug für die Produktionsstandards. Die Engineering-Teams identifizierten drei primäre Engpässe oder „Walls“, die eine optimale Leistung verhinderten: exponierte All-to-All-Kommunikationskollektive im Mesh, partielle Blöcke im Sparse-Attention-Grid und eine serielle Abhängigkeit in der inneren Softmax-Schleife. Über sechs Meilensteine hinweg adressierten die Teams diese Probleme systematisch durch Kernel-Anpassungen und Compiler-Tuning. Letztlich konnte die Zeit pro generiertem Video-Chunk im Vergleich zur ersten funktionierenden TPU-Version fast halbiert werden.
Wie es funktioniert
Die Leistungssteigerungen wurden erzielt, indem die Softwarearchitektur an die spezifischen Hardware-Eigenschaften der Trillium-TPUs angepasst wurde. Da die Modellgewichte den High-Bandwidth-Speicher eines einzelnen Chips überstiegen, nutzte das Team Fully Sharded Data Parallelism (FSDP), um die Gewichte über das Acht-Chip-Mesh zu verteilen. Dies wurde mit Ulysses-Sequence-Parallelismus kombiniert, der die Videosequenz selbst über die Chips aufteilt. Ein entscheidender Erkenntnisgewinn war die Nutzung des SparseCore von Trillium, eines Coprozessors, der Weight-Gathers asynchron abwickelt. Durch die Auslagerung dieser Speicherbewegungen auf den SparseCore blieben die Haupt-Matrixeinheiten für Berechnungen frei, was die Kosten des Shardings effektiv versteckte.
Um die Kommunikationsengpässe zu beheben, pipelineden die Ingenieure die für den Ulysses-Parallelismus erforderlichen All-to-All-Kollektive. Anstatt diese Datentransfers synchron auszuführen, teilten sie Attention Heads in unabhängige Gruppen auf. So konnte der Datentransfer für eine Gruppe mit der Berechnung einer anderen überlappen, wodurch die Kommunikation vom kritischen Pfad genommen wurde. Zusätzlich optimierten sie den Sparse-Attention-Kernel in der Super-Resolution-Stufe, indem sie Blockgrößen so anpassten, dass sie exakt mit den Frame-Grenzen übereinstimmten. Diese Ausrichtung eliminierte die Notwendigkeit komplexer Mask-Prädikate und Paddings, vereinfachte den Kernel und reduzierte den Register-Traffic. Schließlich ersetzten sie die serielle Online-Softmax-Maximum-Berechnung durch eine vorab berechnete Obergrenze, die aus Vektornormen abgeleitet wurde, und entfernten damit eine serielle Abhängigkeit aus der am häufigsten ausgeführten inneren Schleife.
Wichtige Details
- Die optimierte Pipeline läuft auf einem Host mit acht Trillium-v6e-Chips und ist 1,86-mal schneller als die erste TPU-Portierung.
- Avatar IV nutzt mehr als 18 Milliarden Parameter und generiert Videos in 720p oder 1080p mit 25 Bildern pro Sekunde.
- Das Team verwendete torchax, um PyTorch-Code auf JAX auszuführen, und vermied so eine vollständige native JAX-Rewrite.
- Drei wesentliche Optimierungen umfassten das Pipelining von All-to-All-Kollektiven, die Ausrichtung von Sparse-Attention-Blöcken an Frame-Grenzen sowie die Entfernung der seriellen Softmax-Abhängigkeit.
- Die finale Lösung ist bis zu 25 % kosteneffizienter pro Minute generiertes Video im Vergleich zu einem 8xH100-GPU-Setup.
- Alle Änderungen bestanden strenge Qualitätskontrollen, einschließlich byte-identischer Hashwerte für Re-Tilings und enger Ähnlichkeitsbänder für Änderungen der Reduktionsreihenfolge.
Warum das wichtig ist
Für Ingenieure, die Echtzeit-generative Medien entwickeln, unterstreicht diese Fallstudie die Bedeutung hardware-bewusster Softwaregestaltung. Eine bloße Portierung eines Modells auf neue Beschleuniger reicht für Produktions-Workloads selten aus. Die erhebliche Leistungslücke zwischen der ersten Portierung und der finalen optimierten Version zeigt, dass tiefgreifende Änderungen auf Kernel-Ebene oft notwendig sind, um das volle Potenzial spezialisierter Hardware wie TPUs auszuschöpfen. Die beschriebenen Techniken, wie das Pipelining von Kollektiven und die Ausrichtung von Datenstrukturen an Hardware-Beschränkungen, sind auf andere großskalige verteilte Inferenz-Aufgaben übertragbar.
Darüber hinaus bietet die Betonung der Aufrechterhaltung der Ausgabequalität bei gleichzeitiger Optimierung der Geschwindigkeit einen wichtigen Bauplan für zuverlässige KI-Bereitstellungen. Die rigorose Testmethodik des Teams, die Dual-Baseline-Vergleiche und blindes Bild-für-Bild-Reviewing umfasste, stellt sicher, dass Leistungssteigerungen nicht auf Kosten der visuellen Treue gehen. Dieser Ansatz ist für verbraucherorientierte Produkte unerlässlich, da Artefakte oder Inkonsistenzen die Nutzererfahrung erheblich beeinträchtigen können. Das Ergebnis ist ein System, das die Leistung von High-End-GPU-Clustern erreicht, dabei aber eine bessere Kosteneffizienz bietet und damit hochwertige Video-Generierung zugänglicher macht.
Was Sie tun können
- Prüfen Sie Ihre verteilten Trainings- oder Inferenz-Pipelines auf exponierte All-to-All-Kollektive und erwägen Sie deren Pipelining, um Kommunikation und Berechnung zu überlappen.
- Richten Sie Ihre Datenstrukturen, wie Attention Masks oder Sequenzlängen, an den Kachelgrößen (Tile Sizes) der darunterliegenden Hardware aus, um partielle Blöcke und unnötiges Padding zu vermeiden.
- Identifizieren Sie serielle Abhängigkeiten in Hot Loops, wie etwa Online-Softmax-Berechnungen, und untersuchen Sie mathematische Approximationen oder Vorabberechnungen, um diese zu entfernen.
- Verwenden Sie Compiler-Flags und explizite Layout-Verträge, um sicherzustellen, dass benutzerdefinierte Kernel reibungslos mit dem Scheduler und der Speicherhierarchie des Beschleunigers integrieren.
- Implementieren Sie strenge Qualitätskontrollen, die Ausgabehashes oder Ähnlichkeitsbänder gegen eine Baseline vergleichen, um numerische Drift während der Optimierung zu erkennen.
- Profilieren Sie Ihre Workload end-to-end statt isoliert, da Optimierungen, die in Mikrobenchmarks vorteilhaft erscheinen, unter voller Pipeline-Tiefe möglicherweise scheitern.



