Optimización del modelo de difusión Avatar IV de HeyGen para las TPUs de Google Cloud
Ingenieros de HeyGen y Google Cloud detallan cómo portaron el flujo de trabajo de generación de video Avatar IV a las TPUs Trillium v6e, logrando una aceleración de 1.86x mediante la optimización de kernels y estrategias de paralelismo.

Traducido automáticamente del original en inglés.
En una publicación en el Blog de Desarrolladores de Google en agosto de 2026, ingenieros de HeyGen y Google Cloud describieron cómo portaron el flujo de trabajo de generación de video Avatar IV a las Unidades de Procesamiento Tensorial (TPU) Trillium v6e de Google. La colaboración resultó en una mejora de rendimiento de 1.86x sobre la versión inicial de TPU, permitiendo que el complejo modelo de difusión transmita videos de cabezas parlantes de alta calidad de manera más eficiente.
Qué ocurrió
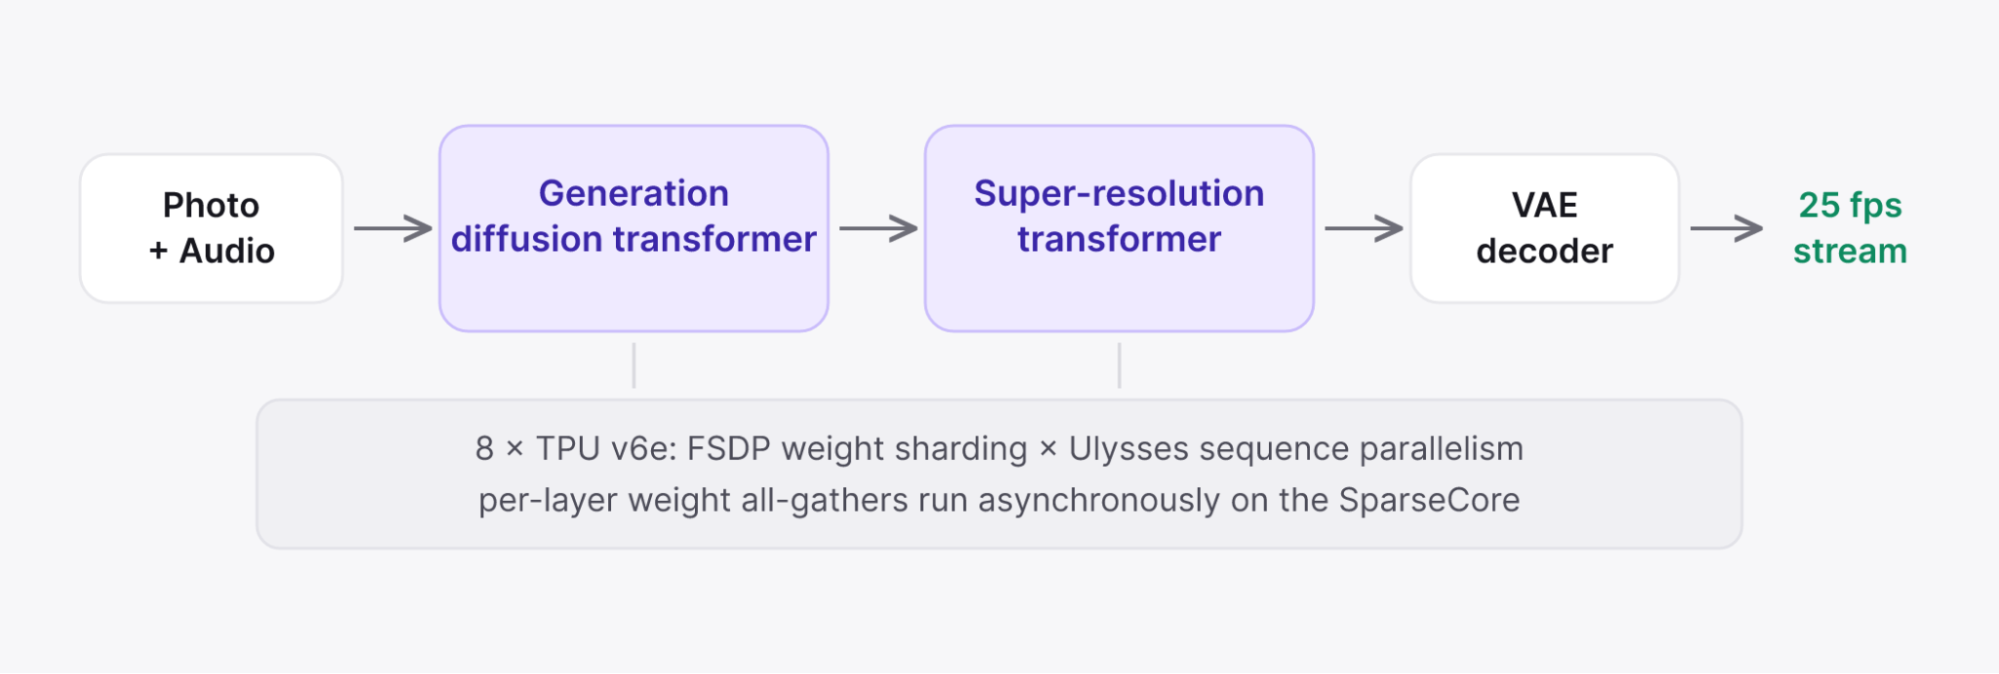
Avatar IV de HeyGen es un modelo de IA a gran escala que genera videos de cabezas parlantes a partir de una sola foto y una pista de audio. El sistema se basa en una pila de difusión con más de 18 mil millones de parámetros, involucrando tres modelos distintos: un transformador de difusión para el renderizado de movimiento, un transformador de superresolución y un decodificador VAE. Estos modelos procesan el video en fragmentos para habilitar la reproducción en streaming, lo que significa que cualquier retraso en el procesamiento de un fragmento provoca pausas visibles en el video final. Para cumplir con plazos estrictos de latencia, el equipo trabajó con el equipo de optimización de rendimiento de infraestructura de IA de Google Cloud para migrar la carga de trabajo desde GPUs a un host de ocho chips Trillium v6e.
El proceso de migración comenzó con un port funcional utilizando torchax, un frontend de PyTorch sobre JAX, que permitió ejecutar el código de producción existente sin modificaciones en las TPUs. Sin embargo, la versión inicial no era lo suficientemente rápida para los estándares de producción. Los equipos de ingeniería identificaron tres cuellos de botella principales, o "muros", que impedían un rendimiento óptimo: colectivos de comunicación all-to-all expuestos en la malla, bloques parciales en la cuadrícula de atención dispersa y una dependencia serial en el bucle interno de softmax. A lo largo de seis hitos, los equipos abordaron sistemáticamente estos problemas mediante la personalización de kernels y la ajuste del compilador, reduciendo finalmente el tiempo por fragmento de video generado casi a la mitad en comparación con la primera versión funcional en TPU.
Cómo funciona
Las mejoras de rendimiento se lograron alineando la arquitectura de software con las características específicas del hardware de la TPU Trillium. Dado que los pesos del modelo excedían la memoria de alto ancho de banda de un solo chip, el equipo utilizó Paralelismo de Datos Totalmente Fragmentado (FSDP) para distribuir los pesos a través de la malla de ocho chips. Combinaron esto con el paralelismo de secuencia Ulysses, que divide la propia secuencia de video entre los chips. Una idea clave fue utilizar SparseCore de Trillium, un coprocesador que maneja las recopilaciones de pesos de forma asincrónica. Al descargar estos movimientos de memoria al SparseCore, las unidades matriciales principales permanecieron libres para el cómputo, ocultando efectivamente el costo de la fragmentación.
Para resolver los cuellos de botella de comunicación, los ingenieros canalizaron (pipelined) los colectivos all-to-all requeridos por el paralelismo Ulysses. En lugar de ejecutar estas transferencias de datos de forma sincronizada, dividieron las cabezas de atención en grupos independientes. Esto permitió que la transferencia de datos de un grupo se solapara con el cómputo de otro, sacando la comunicación del camino crítico. Además, optimizaron el kernel de atención dispersa en la etapa de superresolución ajustando los tamaños de bloque para que coincidieran exactamente con los límites de los fotogramas. Esta alineación eliminó la necesidad de predicados de máscara complejos y relleno (padding), simplificando el kernel y reduciendo el tráfico de registros. Finalmente, reemplazaron el cálculo serial de máximo de softmax online con un límite superior precalculado derivado de normas vectoriales, eliminando una dependencia serial del bucle interno más intensivo.
Detalles clave
- El flujo de trabajo optimizado se ejecuta en un host de ocho chips Trillium v6e y es 1.86x más rápido que el port inicial de TPU.
- Avatar IV utiliza más de 18 mil millones de parámetros y genera video a 720p o 1080p a 25 fotogramas por segundo.
- El equipo usó torchax para ejecutar código de PyTorch sobre JAX, evitando la necesidad de una reescritura nativa completa en JAX.
- Tres optimizaciones mayores incluyeron la canalización de colectivos all-to-all, la alineación de bloques de atención dispersa con los límites de fotograma y la eliminación de la dependencia serial de softmax.
- La solución final es hasta un 25% más rentable por minuto de video generado en comparación con una configuración de GPU 8xH100.
- Todos los cambios pasaron puertas de calidad estrictas, incluyendo hashing idéntico byte a byte para re-tilings y bandas de similitud estrechas para cambios en el orden de reducción.
Por qué importa
Para los ingenieros que construyen medios generativos en tiempo real, este estudio de caso destaca la importancia del diseño de software consciente del hardware. Simplemente portar un modelo a nuevos aceleradores rara vez es suficiente para cargas de trabajo de producción. La brecha significativa de rendimiento entre el port inicial y la versión final optimizada demuestra que los cambios profundos a nivel de kernel son a menudo necesarios para desbloquear todo el potencial de hardware especializado como las TPUs. Las técnicas descritas, como la canalización de colectivos y la alineación de estructuras de datos con restricciones de hardware, son aplicables a otras tareas de inferencia distribuida a gran escala.
Además, el énfasis en mantener la calidad de salida mientras se optimiza la velocidad proporciona un plano crucial para el despliegue fiable de IA. La metodología de pruebas rigurosa del equipo, que incluyó comparaciones de doble línea base y revisiones ciegas fotograma a fotograma, asegura que las ganancias de rendimiento no se obtengan a expensas de la fidelidad visual. Este enfoque es esencial para productos orientados al consumidor donde los artefactos o inconsistencias pueden afectar gravemente la experiencia del usuario. El resultado es un sistema que iguala el rendimiento de clústeres de GPU de gama alta mientras ofrece mejor eficiencia de costos, haciendo la generación de video de alta calidad más accesible.
Qué puedes hacer
- Audita tus flujos de trabajo de entrenamiento o inferencia distribuida para detectar colectivos all-to-all expuestos y considera canalizarlos para solapar la comunicación con el cómputo.
- Alinea tus estructuras de datos, como máscaras de atención o longitudes de secuencia, con los tamaños de tile del hardware subyacente para evitar bloques parciales y relleno innecesario.
- Identifica dependencias seriales en bucles críticos, como cálculos de softmax online, y explora aproximaciones matemáticas o precalculaciones para eliminarlas.
- Usa banderas de compilador y contratos de layout explícitos para asegurar que los kernels personalizados se integren suavemente con el planificador y la jerarquía de memoria del acelerador.
- Implementa puertas de calidad estrictas que comparen hashes de salida o bandas de similitud contra una línea base para detectar deriva numérica durante la optimización.
- Perfilá tu carga de trabajo de extremo a extremo en lugar de aisladamente, ya que las optimizaciones que parecen beneficiosas en microbenchmarks pueden fallar bajo la profundidad completa del flujo de trabajo.



