HeyGenのAvatar IV拡散モデルをGoogle Cloud TPU向けに最適化
HeyGenとGoogle Cloudのエンジニアが、Avatar IV動画生成パイプラインをTrillium v6e TPUへ移植する方法を詳述し、カーネル最適化と並列化戦略により1.86倍の高速化を達成したことを明らかにしました。

英語の原文から自動翻訳されました。
2026年8月のGoogle Developers Blogの投稿で、HeyGenとGoogle Cloudのエンジニアは、Avatar IV動画生成パイプラインをGoogleのTrillium v6e Tensor Processing Units(TPU)へ移植する方法について説明しました。この協力関係により、初期のTPUバージョンと比較してパフォーマンスが1.86倍向上し、複雑な拡散モデルが高品質なトーキングヘッド動画をより効率的にストリーミング配信できるようになりました。
何が起きたか
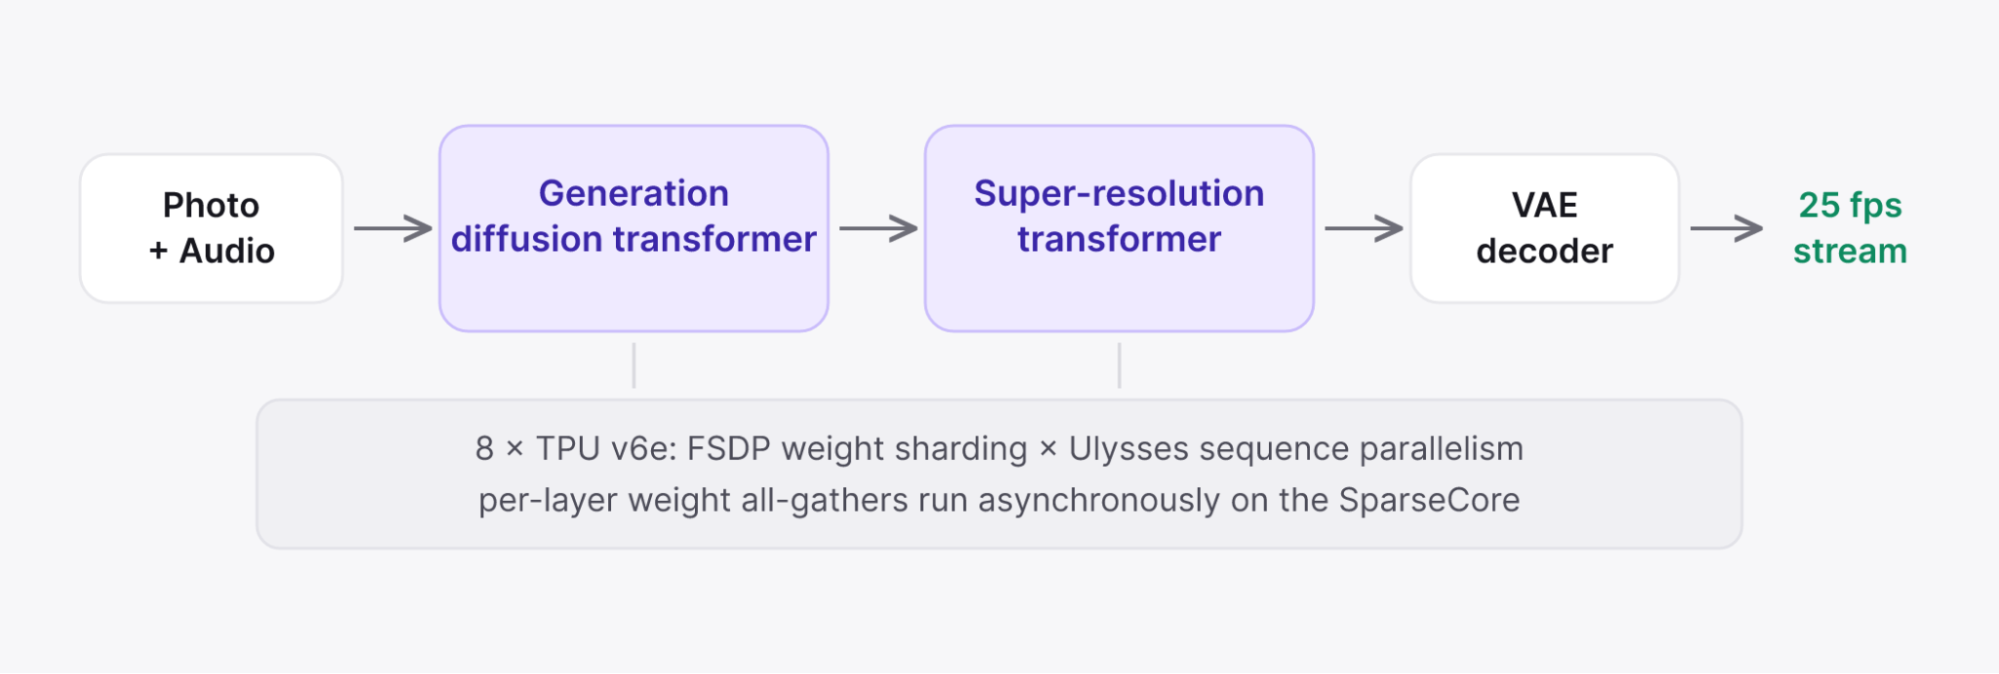
HeyGenのAvatar IVは、単一の画像と音声トラックからトーキングヘッド動画を生成する大規模AIモデルです。このシステムは、動きレンダリング用の拡散トランスフォーマー、スーパーレゾリューション用トランスフォーマー、VAEデコーダーという3つの異なるモデルを含む、180億以上のパラメータを持つ拡散スタックに依存しています。これらのモデルはストリーミング再生を可能にするために動画をチャンク単位で処理するため、チャンクの処理遅延は最終的な動画における目に見える停止を引き起こします。厳格なレイテンシ要件を満たすため、チームはGoogle CloudのAIインフラストラクチャ パフォーマンス最適化チームと連携し、ワークロードをGPUから8チップ構成のTrillium v6eホストへ移行しました。
移行プロセスは、既存の本番コードを変更せずにTPU上で実行できるようにするPyTorchフロントエンドであるtorchaxを使用した機能的なポートから始まりました。しかし、初期バージョンは本番基準に対して十分に高速ではありませんでした。エンジニアチームは、最適なパフォーマンスを妨げる3つの主要なボトルネック、つまり「壁」を特定しました。それは、メッシュ内の露出したall-to-all通信コレクティブ、スパースアテンショングリッド内の部分ブロック、そしてsoftmax内部ループ内の直列依存関係です。6つのマイルストーンを通じて、チームはカーネルのカスタマイズとコンパイラのチューニングによってこれらの問題を体系的に対処し、最終的に最初の動作するTPUバージョンと比較して、生成される動画チャンクあたりの時間をほぼ半分に削減しました。
仕組み
パフォーマンスの向上は、ソフトウェアアーキテクチャをTrillium TPUの特定のハードウェア特性に合わせることで実現されました。モデルの重みが単一チップのハイバンド幅メモリを超えていたため、チームはFully Sharded Data Parallelism(FSDP)を使用して、重みを8チップのメッシュ全体に分散させました。これに、動画シーケンス自体をチップ間で分割するUlyssesシーケンス並列性を組み合わせました。重要な洞察は、重み収集を非同期で処理するコプロセッサであるTrilliumのSparseCoreを活用することでした。これらのメモリ移動をSparseCoreへオフロードすることで、メインのマトリックスユニットは計算用に空き状態を保ち、シャーディングのコストを効果的に隠蔽しました。
通信ボトルネックを解消するために、エンジニアはUlysses並列性が必要とするall-to-allコレクティブをパイプライン化しました。これらのデータ転送を同期的に実行する代わりに、アテンションヘッドを独立したグループに分割しました。これにより、あるグループのデータ転送を別のグループの計算とオーバーラップさせることができ、通信をクリティカルパスから外すことができました。さらに、スーパーレゾリューション段階のスパースアテンションカーネルを最適化し、ブロックサイズをフレーム境界に正確に合わせて調整しました。この整列により、複雑なマスク述語やパディングの必要性が排除され、カーネルが簡素化されてレジスタトラフィックが削減されました。最後に、直列のオンラインsoftmax最大値計算を、ベクトルノームから導出された事前計算済み上限値に置き換えることで、最も負荷の高い内部ループから直列依存関係を除去しました。
主要な詳細
- 最適化されたパイプラインは8チップ構成のTrillium v6eホスト上で動作し、初期のTPUポートと比較して1.86倍高速です。
- Avatar IVは180億以上のパラメータを使用し、毎秒25フレームで720pまたは1080pの動画を生成します。
- チームはtorchaxを使用してJAX上でPyTorchコードを実行し、完全なネイティブJAXへの書き直しを回避しました。
- 3つの主要な最適化には、all-to-allコレクティブのパイプライン化、スパースアテンションブロックのフレーム境界への整列、および直列softmax依存関係の除去が含まれます。
- 最終的なソリューションは、8xH100 GPUセットアップと比較して、生成動画1分あたりのコスト効率が最大25%向上しています。
- すべての変更は、リタイリングに対するバイト単位で同一のハッシュ、および還元順序の変更に対する狭い類似性帯域を含む、厳格な品質ゲートを通過しました。
なぜ重要なのか
リアルタイム生成メディアを構築するエンジニアにとって、このケーススタディはハードウェア認識型のソフトウェア設計の重要性を浮き彫りにしています。モデルを新しいアクセラレータへ単純に移植するだけでは、本番ワークロードには通常不十分です。初期ポートと最終最適化バージョンとの間の顕著なパフォーマンスギャップは、TPUのような専用ハードウェアの潜在能力を完全に引き出すためには、深いレベルでのカーネル変更がしばしば必要であることを示しています。コレクティブのパイプライン化やデータ構造をハードウェア制約に整列させるなどの記載された手法は、他の大規模分散推論タスクにも適用可能です。
さらに、速度を最適化する一方で出力品質を維持することに重点を置くことは、信頼性の高いAI展開のための重要な青写真を提供します。デュアルベースライン比較やブラインドによるフレームバイフレームレビューを含むチームの厳格なテスト手法は、パフォーマンス向上が視覚的忠実度を犠牲にしないことを保証します。アーティファクトや矛盾がユーザー体験に深刻な影響を与える可能性がある消費者向け製品において、このアプローチは不可欠です。その結果、ハイエンドGPUクラスタのパフォーマンスに匹敵しつつ、より優れたコスト効率を提供するシステムが生まれ、高品質な動画生成がよりアクセスしやすくなります。
あなたができること
- 分散トレーニングまたは推論パイプラインを監査し、露出したall-to-allコレクティブを探して、通信と計算をオーバーラップさせるためのパイプライン化を検討してください。
- アテンションマスクやシーケンス長などのデータ構造を、基盤となるハードウェアのタイルサイズに整列させ、部分ブロックや不要なパディングを避けてください。
- オンラインsoftmax計算など、ホットループ内の直列依存関係を特定し、それらを除去するための数学的近似法や事前計算を検討してください。
- コンパイラフラグと明示的なレイアウト契約を使用して、カスタムカーネルがアクセラレータのスケジューラとメモリ階層にスムーズに統合されるようにしてください。
- 最適化中の数値ドリフトを検出するために、出力ハッシュや類似性帯域をベースラインと比較する厳格な品質ゲートを実装してください。
- マイクロベンチマークでは有益に見える最適化も、完全なパイプライン深度下では失敗する可能性があるため、ワークロードを分離してではなく、エンドツーエンドでプロファイルしてください。



