Optimisation du modèle de diffusion Avatar IV de HeyGen pour les TPUs de Google Cloud
Les ingénieurs de HeyGen et de Google Cloud détaillent la manière dont ils ont porté le pipeline de génération vidéo Avatar IV sur les TPUs Trillium v6e, atteignant une accélération de 1,86x grâce à l'optimisation des kernels et aux stratégies de parallélisme.

Traduit automatiquement depuis l'original anglais.
Dans un article publié sur le blog des développeurs Google en août 2026, des ingénieurs de HeyGen et de Google Cloud ont décrit comment ils ont porté le pipeline de génération vidéo Avatar IV sur les unités de traitement tensoriel (TPU) Trillium v6e de Google. Cette collaboration a permis d'améliorer les performances de 1,86x par rapport à la première version TPU, permettant au complexe modèle de diffusion de diffuser plus efficacement des vidéos de haute qualité avec des têtes parlantes.
Ce qui s'est passé
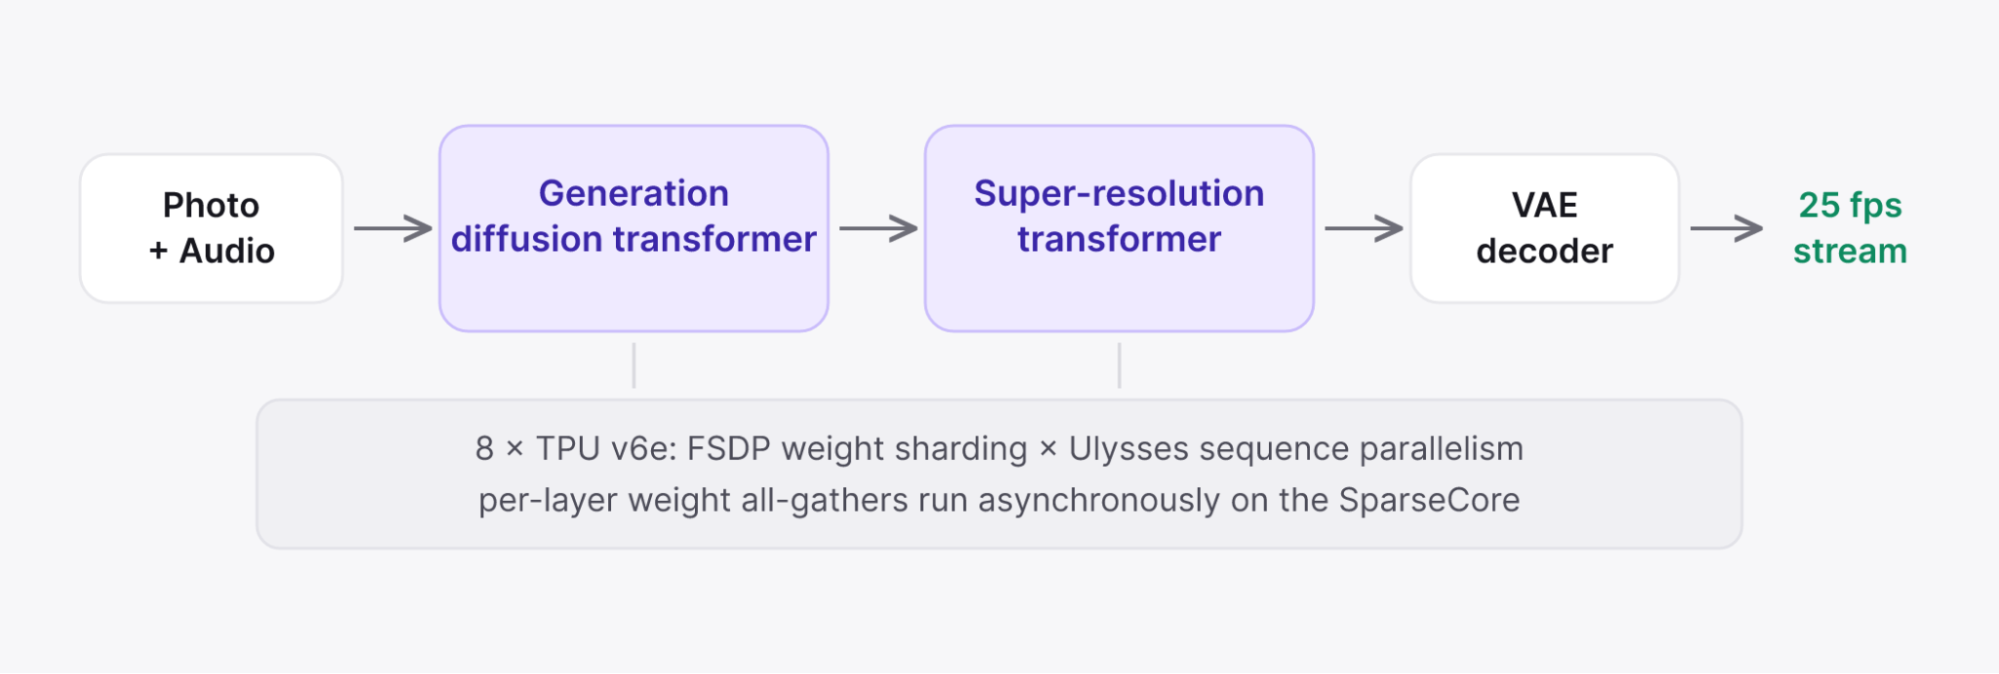
Avatar IV de HeyGen est un grand modèle d'IA qui génère des vidéos de têtes parlantes à partir d'une seule photo et d'une piste audio. Le système repose sur une pile de diffusion comportant plus de 18 milliards de paramètres, impliquant trois modèles distincts : un transformateur de diffusion pour le rendu des mouvements, un transformateur de super-résolution et un décodeur VAE. Ces modèles traitent la vidéo par blocs afin de permettre une lecture en streaming, ce qui signifie que tout retard dans le traitement d'un bloc provoque des arrêts visibles dans la vidéo finale. Pour respecter des délais de latence stricts, l'équipe a collaboré avec l'équipe d'optimisation des performances de l'infrastructure IA de Google Cloud pour migrer la charge de travail des GPU vers un hôte Trillium v6e à huit puces.
Le processus de migration a commencé par un portage fonctionnel utilisant torchax, un frontend PyTorch sur JAX, qui permettait au code de production existant de s'exécuter sans modification sur les TPUs. Cependant, la version initiale n'était pas assez rapide pour les normes de production. Les équipes d'ingénierie ont identifié trois principaux goulets d'étranglement, ou « murs », qui empêchaient des performances optimales : des collectifs de communication all-to-all exposés dans la mesh, des blocs partiels dans la grille d'attention sparse, et une dépendance séquentielle dans la boucle interne du softmax. Au cours de six jalons, les équipes ont systématiquement résolu ces problèmes grâce à la personnalisation des kernels et au réglage du compilateur, réduisant finalement le temps par bloc vidéo généré de près de moitié par rapport à la première version TPU fonctionnelle.
Comment cela fonctionne
Les gains de performance ont été obtenus en alignant l'architecture logicielle sur les caractéristiques matérielles spécifiques du TPU Trillium. Étant donné que les poids du modèle dépassaient la mémoire à large bande passante d'une seule puce, l'équipe a utilisé le Fully Sharded Data Parallelism (FSDP) pour répartir les poids sur la mesh de huit puces. Ils ont combiné cela avec le parallélisme de séquence Ulysses, qui divise la séquence vidéo elle-même entre les puces. Une idée clé a été d'utiliser le SparseCore de Trillium, un coprocesseur qui gère les rassemblements de poids de manière asynchrone. En déchargeant ces mouvements de mémoire sur le SparseCore, les unités matricielles principales sont restées libres pour le calcul, masquant ainsi efficacement le coût du sharding.
Pour résoudre les goulets d'étranglement liés à la communication, les ingénieurs ont mis en pipeline les collectifs all-to-all requis par le parallélisme Ulysses. Au lieu d'exécuter ces transferts de données de manière synchrone, ils ont divisé les têtes d'attention en groupes indépendants. Cela a permis au transfert de données d'un groupe de se chevaucher avec le calcul d'un autre, sortant ainsi la communication du chemin critique. De plus, ils ont optimisé le kernel d'attention sparse dans l'étape de super-résolution en ajustant les tailles de bloc pour qu'elles correspondent exactement aux limites des images. Cet alignement a éliminé le besoin de prédicats de masque complexes et de padding, simplifiant le kernel et réduisant le trafic de registres. Enfin, ils ont remplacé le calcul max du softmax online séquentiel par une borne supérieure précalculée dérivée des normes vectorielles, supprimant une dépendance séquentielle de la boucle interne la plus chaude.
Détails clés
- Le pipeline optimisé s'exécute sur un hôte Trillium v6e à huit puces et est 1,86x plus rapide que le premier portage TPU.
- Avatar IV utilise plus de 18 milliards de paramètres et génère des vidéos 720p ou 1080p à 25 images par seconde.
- L'équipe a utilisé torchax pour exécuter du code PyTorch sur JAX, évitant la nécessité d'une réécriture native complète en JAX.
- Trois optimisations majeures incluaient la mise en pipeline des collectifs all-to-all, l'alignement des blocs d'attention sparse sur les limites des images et la suppression de la dépendance séquentielle du softmax.
- La solution finale est jusqu'à 25 % plus rentable par minute de vidéo générée par rapport à une configuration GPU 8xH100.
- Toutes les modifications ont passé des contrôles de qualité stricts, y compris des hachages identiques au bit près pour les re-tilings et des bandes de similarité étroites pour les changements d'ordre de réduction.
Pourquoi c'est important
Pour les ingénieurs développant des médias génératifs en temps réel, cette étude de cas souligne l'importance d'une conception logicielle consciente du matériel. Le simple portage d'un modèle sur de nouveaux accélérateurs est rarement suffisant pour les charges de travail de production. L'écart significatif de performance entre le portage initial et la version finale optimisée démontre que des changements profonds au niveau des kernels sont souvent nécessaires pour libérer tout le potentiel de matériels spécialisés comme les TPUs. Les techniques décrites, telles que la mise en pipeline des collectifs et l'alignement des structures de données sur les contraintes matérielles, sont applicables à d'autres tâches d'inférence distribuée à grande échelle.
De plus, l'accent mis sur le maintien de la qualité de sortie tout en optimisant la vitesse fournit un plan crucial pour un déploiement fiable de l'IA. La méthodologie de test rigoureuse de l'équipe, qui incluait des comparaisons à double base de référence et des revues image par image en aveugle, garantit que les gains de performance ne se font pas au détriment de la fidélité visuelle. Cette approche est essentielle pour les produits destinés aux consommateurs, où les artefacts ou les incohérences peuvent gravement affecter l'expérience utilisateur. Le résultat est un système qui égale les performances des clusters GPU haut de gamme tout en offrant une meilleure rentabilité, rendant la génération vidéo de haute qualité plus accessible.
Ce que vous pouvez faire
- Auditez vos pipelines d'entraînement ou d'inférence distribués pour détecter les collectifs all-to-all exposés et envisagez leur mise en pipeline pour les chevaucher.
- Alignez vos structures de données sur les contraintes matérielles pour éviter les blocs partiels et les paddings inutiles.
- Identifiez les dépendances séquentielles dans les boucles internes critiques et cherchez à les remplacer par des calculs préchargés ou parallèles.



