Cách bộ nhớ đệm của controller-runtime ngăn chặn tình trạng quá tải API server
Tìm hiểu sâu về mô hình list-watch và cơ chế lưu trữ cục bộ trong các Kubernetes controller, giải thích lý do tại sao thao tác đọc có chi phí thấp nhưng tính nhất quán chỉ là cuối cùng (eventual consistency).
Được dịch tự động từ bản gốc tiếng Anh.
Trong một bài đăng trên Kubernetes Blog vào tháng 7 năm 2026, các kỹ sư đã trình bày chi tiết về cơ chế hoạt động bên trong của bộ nhớ đệm controller-runtime. Bài viết làm rõ cách các controller được viết bằng Go tương tác với Kubernetes API server, đồng thời sửa lại những hiểu lầm phổ biến về tính nhất quán dữ liệu và mức độ sử dụng bộ nhớ trong môi trường production.
Chuyện gì đã xảy ra
Bài viết giải quyết một hiểu lầm lan rộng trong giới phát triển khi xây dựng các Kubernetes operator: rằng mỗi thao tác đọc bên trong một reconciler đều kích hoạt một yêu cầu HTTP trực tiếp đến API server. Trên thực tế, controller-runtime dựa vào một bộ nhớ đệm cục bộ trong RAM, được cập nhật thông qua mô hình list kết hợp với watch. Lựa chọn kiến trúc này đảm bảo rằng các controller có thể xử lý hàng trăm lần reconciliation mỗi giây mà không gây quá tải cho control plane hoặc etcd.
Tuy nhiên, hiệu quả này đi kèm với những đánh đổi cụ thể. Vì các controller đọc từ bản sao cục bộ thay vì nguồn sự thật trực tiếp (live source of truth), chúng có thể gặp phải dữ liệu cũ ngay sau một thao tác ghi. Bài viết nhấn mạnh rằng trong khi các thao tác ghi được gửi trực tiếp đến API server, thì các thao tác đọc được phục vụ từ bộ nhớ, nghĩa là hệ thống ưu tiên tính sẵn sàng cao và độ trễ thấp hơn là tính nhất quán mạnh tức thời. Các nhà phát triển bỏ qua mô hình này có nguy cơ tạo ra những controller tiêu tốn quá nhiều bộ nhớ hoặc thực hiện các quét tuyến tính kém hiệu quả trên tập dữ liệu lớn.
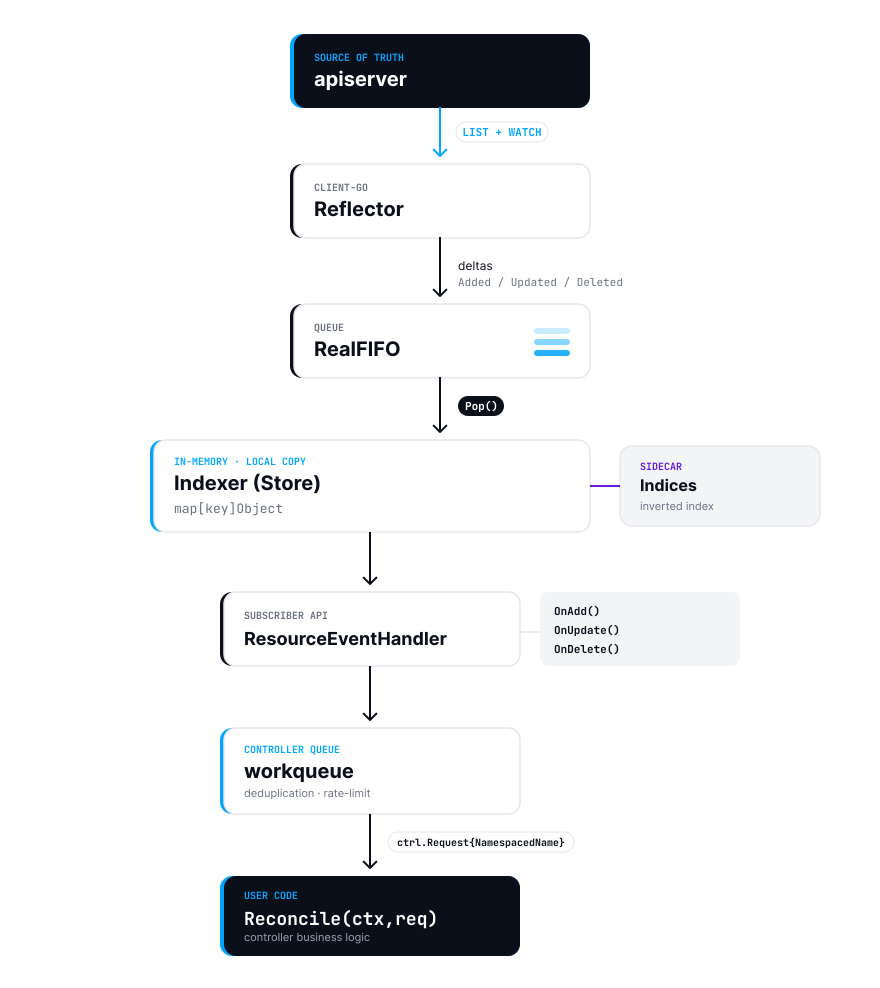
Lời giải thích đóng vai trò như một hướng dẫn chỉnh sửa dành cho các kỹ sư đã quan sát thấy hành vi bất ngờ trong các kịch bản tải cao. Bằng cách vẽ ra luồng dữ liệu từ API server đến kho lưu trữ informer cục bộ, các tác giả cung cấp một mô hình tư duy mạch lạc để gỡ lỗi các vấn đề liên quan đến áp lực bộ nhớ, lưu lượng mạng và lỗi logic trong reconciler.
Cách thức hoạt động
Cơ chế cốt lõi dựa vào Reflector, một thành phần trong client-go duy trì việc theo dõi liên tục (continuous watch) đối với các loại tài nguyên cụ thể. Khi khởi động, Reflector lấy một ảnh chụp nhanh ban đầu của các đối tượng mà nó quan tâm. Các phiên bản cài đặt hiện đại sử dụng phương pháp danh sách dòng chảy (streaming list), nơi API server gửi các sự kiện ADDED tổng hợp cho các đối tượng hiện có trước khi chuyển sang các sự kiện thay đổi trực tiếp. Điều này loại bỏ nhu cầu gọi danh sách hàng loạt riêng biệt, giúp giảm bớt chi phí kết nối.
Sau khi trạng thái ban đầu được nắm bắt, Reflector giữ mở một watch, sử dụng resourceVersion để đảm bảo không bỏ sót sự kiện nào. Nếu kết nối bị ngắt, Reflector sẽ kết nối lại bằng phiên bản cuối cùng đã biết. Nếu phiên bản đó quá cũ, API server sẽ trả về lỗi 410 Gone, buộc Reflector phải lấy một ảnh chụp nhanh mới và khởi động lại quy trình. Điều này đảm bảo bộ nhớ đệm cục bộ vẫn đạt được tính nhất quán cuối cùng (eventually consistent) với trạng thái cụm.
Các thay đổi đầu vào được xử lý thông qua một hàng đợi delta. Các phiên bản gần đây của client-go (1.36+) sử dụng RealFIFO, một hàng đợi tuân thủ nghiêm ngặt thứ tự nhằm bảo toàn chuỗi sự kiện toàn cục. Khác với các phiên bản cũ vốn khử trùng lặp sự kiện theo từng đối tượng, RealFIFO truyền mọi thông báo theo đúng thứ tự. Điều này có nghĩa là nếu một đối tượng được cập nhật ba lần liên tiếp nhanh chóng, bộ xử lý sự kiện của controller sẽ nhận được ba thông báo cập nhật riêng biệt, đảm bảo không có trạng thái trung gian nào bị âm thầm loại bỏ trước khi đến logic ứng dụng.
Chi tiết chính
r.Get()vàr.List()bên trong một reconciler đọc từ bộ nhớ đệm cục bộ trong RAM, không phải từ API server.- Các thao tác ghi bỏ qua bộ nhớ đệm và đi trực tiếp đến API server, nghĩa là các thao tác đọc tiếp theo có thể trả về dữ liệu cũ.
- Bộ nhớ đệm sử dụng mô hình list + watch, với các phiên bản hiện đại dùng danh sách dòng chảy (streaming lists) để đồng bộ hóa ban đầu.
RealFIFOđã thay thếDeltaFIFOtrong các phiên bảnclient-gogần đây, loại bỏ cơ chế khử trùng lặp tự động ở tầng informer.- Mức tiêu thụ bộ nhớ phụ thuộc vào kích thước của bộ nhớ đệm cục bộ và số lượng trường được lập chỉ mục (indexed fields), chứ không chỉ dựa vào số lượng đối tượng.
APIReadercung cấp quyền truy cập trực tiếp vào API server nhưng nên được sử dụng hạn chế do độ trễ cao hơn và gây tải nặng hơn.
Tại sao điều này quan trọng
Đối với các kỹ sư phần mềm xây dựng operator, việc hiểu mô hình bộ nhớ đệm này là rất quan trọng để tinh chỉnh hiệu suất. Vì các thao tác đọc là cục bộ, việc thêm nhiều chỉ mục hoặc theo dõi các loại tài nguyên không cần thiết có thể dẫn đến mức sử dụng bộ nhớ lên tới gigabyte mà không có sự gia tăng rõ rệt nào về tải trên API server. Chi phí ẩn này thường chỉ biểu hiện ở quy mô production, khiến việc chẩn đoán trở nên khó khăn trong giai đoạn phát triển. Nhận thức được rằng các thao tác List() có thể kích hoạt các quét tuyến tính trên toàn bộ kho lưu trữ cục bộ giúp các nhà phát triển tránh viết logic lọc kém hiệu quả làm giảm khả năng phản hồi của controller.
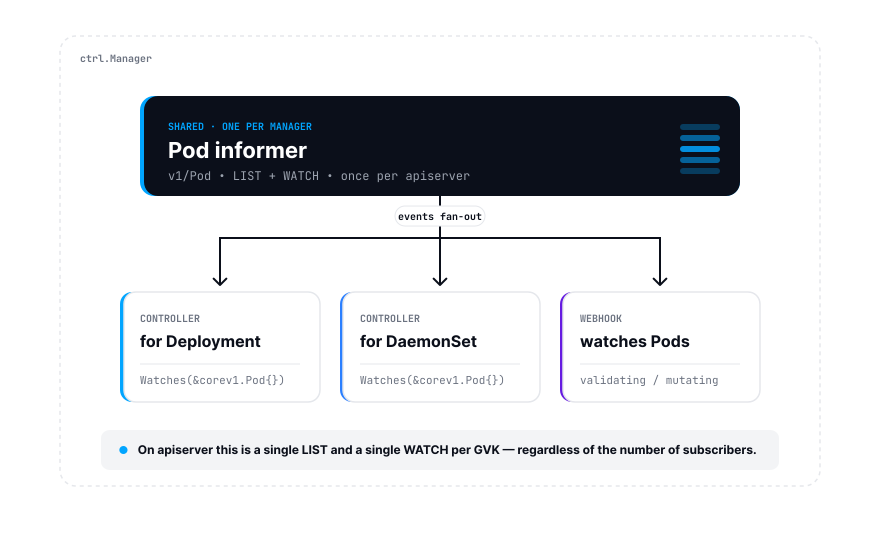
Hơn nữa, mô hình nhất quán cuối cùng ảnh hưởng đến cách các reconciler xử lý các chuyển đổi trạng thái. Giả định rằng một lệnh gọi Get() phản ánh ngay lập tức một lệnh Update() trước đó có thể dẫn đến các điều kiện tranh chấp (race conditions) và lỗi logic. Các kỹ sư phải thiết kế các reconciler sao cho có tính idempotent (lặp lại không thay đổi kết quả) và chống chịu tốt với các đọc dữ liệu cũ, coi bộ nhớ đệm cục bộ như một gợi ý chứ không phải nguồn sự thật xác định. Sự thay đổi tư duy này ngăn ngừa các controller mong manh dễ hỏng hóc khi cụm đang chịu tải nặng hoặc khi phân vùng mạng gây ra mất đồng bộ tạm thời.
Bạn có thể làm gì
- Kiểm tra các
Watchescủa controller để đảm bảo bạn chỉ lưu trữ đệm các loại tài nguyên thực sự cần thiết cho logic reconciliation. - Sử dụng các predicate để lọc sự kiện ở tầng informer, ngăn chặn các yêu cầu reconcile không cần thiết đi vào workqueue.
- Tránh giả định tính nhất quán tức thời sau các thao tác ghi; hãy thiết kế các reconciler để xử lý các trường hợp bộ nhớ đệm cục bộ chậm hơn so với API server.
- Giám sát mức sử dụng bộ nhớ của các pod controller, vì các bộ nhớ đệm lớn với nhiều chỉ mục có thể gây ra sự cố hết bộ nhớ (out-of-memory crashes).
- Chỉ sử dụng
APIReadercho các trường hợp cụ thể đòi hỏi tính nhất quán mạnh, chẳng hạn như xác minh trạng thái cuối cùng trước khi hoàn tất một workflow. - Kiểm thử hành vi của controller dưới tốc độ thay đổi tài nguyên cao (high churn rates) để xác định các vấn đề liên quan đến đọc dữ liệu cũ hoặc lỗi hàng đợi.



