Cómo la caché de controller-runtime evita la sobrecarga del API server
Un análisis profundo del patrón list-watch y el almacenamiento en caché local en los controladores de Kubernetes, explicando por qué las lecturas son baratas pero la consistencia es eventual.
Traducido automáticamente del original en inglés.
En una publicación del blog de Kubernetes en julio de 2026, los ingenieros detallaron la mecánica interna de la caché de controller-runtime. El artículo aclara cómo interactúan los controladores basados en Go con el API server de Kubernetes, corrigiendo conceptos erróneos comunes sobre la consistencia de datos y el uso de memoria en entornos de producción.
Qué ocurrió
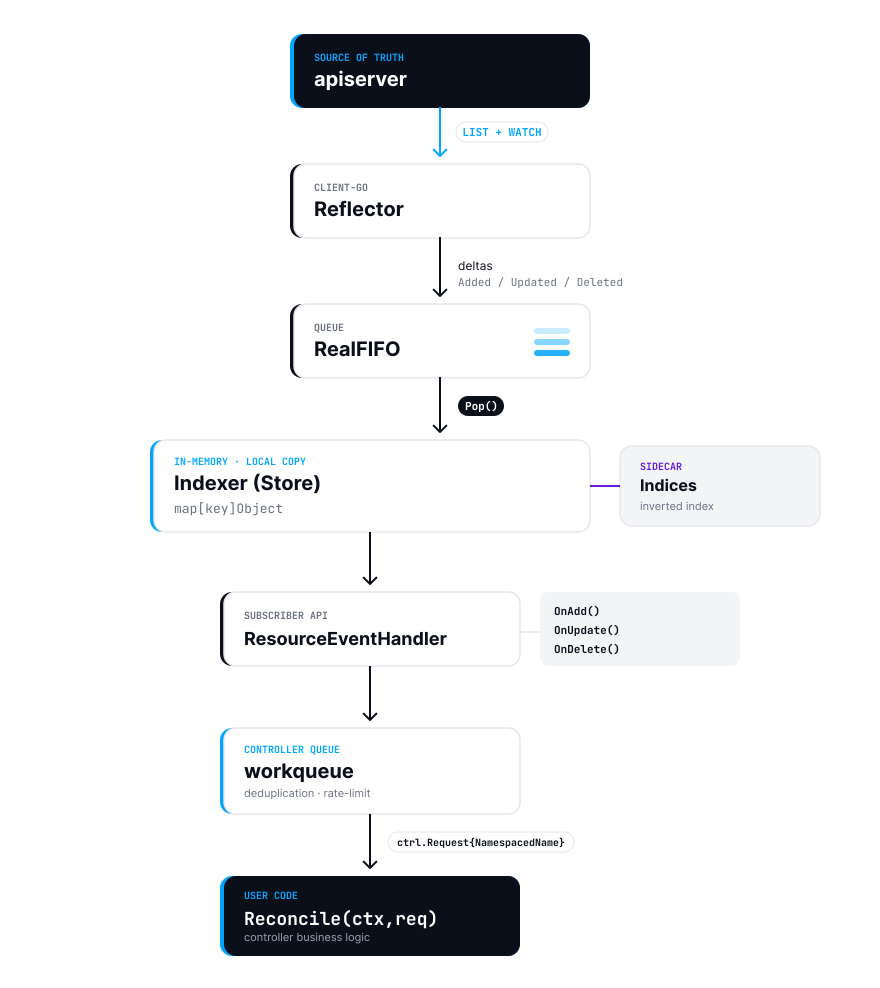
La publicación aborda un malentendido generalizado entre los desarrolladores que construyen operadores de Kubernetes: la creencia de que cada operación de lectura dentro de un reconciliador dispara una solicitud HTTP directa al API server. En realidad, controller-runtime depende de una caché local en memoria poblada mediante un patrón list más watch. Esta elección arquitectónica garantiza que los controladores puedan manejar cientos de reconciliaciones por segundo sin abrumar el plano de control o etcd.
Sin embargo, esta eficiencia conlleva compensaciones específicas. Dado que los controladores leen desde una copia local en lugar de la fuente de verdad viva, pueden encontrar datos obsoletos inmediatamente después de una operación de escritura. El artículo destaca que, si bien las escrituras van directamente al API server, las lecturas se sirven desde la memoria, lo que significa que el sistema prioriza la disponibilidad y la baja latencia sobre la fuerte consistencia inmediata. Los desarrolladores que ignoran este modelo corren el riesgo de crear controladores que consuman memoria excesiva o realicen escaneos lineales ineficientes sobre grandes conjuntos de datos.
La explicación sirve como guía correctiva para ingenieros que han observado comportamientos inesperados en escenarios de alta carga. Al mapear el flujo desde el API server hasta el almacén local del informer, los autores proporcionan un modelo mental coherente para depurar problemas relacionados con la presión de memoria, el tráfico de red y errores en la lógica del reconciliador.
Cómo funciona
El mecanismo central depende del Reflector, un componente dentro de client-go que mantiene una vigilancia continua sobre tipos de recursos específicos. Al iniciarse, el Reflector obtiene una instantánea inicial de los objetos que le interesan. Las implementaciones modernas utilizan un enfoque de lista en streaming, donde el API server envía eventos sintéticos ADDED para los objetos existentes antes de cambiar a eventos de cambio en vivo. Esto elimina la necesidad de una llamada de lista masiva separada, reduciendo la sobrecarga de conexión.
Una vez capturado el estado inicial, el Reflector mantiene abierto un watch, utilizando resourceVersion para asegurar que no se pierdan eventos. Si la conexión se interrumpe, el Reflector se reconecta usando la última versión conocida. Si esa versión es demasiado antigua, el API server devuelve un error 410 Gone, forzando al Reflector a obtener una nueva instantánea y reiniciar el proceso. Esto asegura que la caché local permanezca eventualmente consistente con el estado del clúster.
Los cambios entrantes se procesan a través de una cola delta. Las versiones recientes de client-go (1.36+) usan RealFIFO, una cola estrictamente ordenada que preserva la secuencia global de eventos. A diferencia de las implementaciones anteriores que deduplicaban eventos por objeto, RealFIFO pasa cada notificación en orden. Esto significa que si un objeto se actualiza tres veces rápidamente, el manejador de eventos del controlador recibirá tres notificaciones de actualización distintas, asegurando que ningún estado intermedio sea descartado silenciosamente antes de llegar a la lógica de la aplicación.
Detalles clave
r.Get()yr.List()dentro de un reconciliador leen desde una caché local en memoria, no desde el API server.- Las escrituras evitan la caché y van directamente al API server, lo que significa que las lecturas posteriores pueden devolver datos obsoletos.
- La caché utiliza un patrón list + watch, con implementaciones modernas que usan listas en streaming para la sincronización inicial.
RealFIFOreemplazó aDeltaFIFOen versiones recientes declient-go, eliminando la deduplicación automática en la capa del informer.- El consumo de memoria está impulsado por el tamaño de la caché local y el número de campos indexados, no solo por el número de objetos.
APIReaderproporciona acceso directo al API server, pero debe usarse con moderación debido a la mayor latencia y carga.
Por qué importa
Para los ingenieros de software que construyen operadores, comprender este modelo de caché es crítico para la optimización del rendimiento. Dado que las lecturas son locales, agregar más índices o vigilar tipos de recursos innecesarios puede llevar a gigabytes de uso de memoria sin ningún aumento visible en la carga del API server. Este costo oculto a menudo se manifiesta solo bajo escala de producción, dificultando su diagnóstico durante el desarrollo. Reconocer que las operaciones List() pueden disparar escaneos lineales sobre todo el almacén local ayuda a los desarrolladores a evitar escribir lógica de filtrado ineficiente que degrada la capacidad de respuesta del controlador.
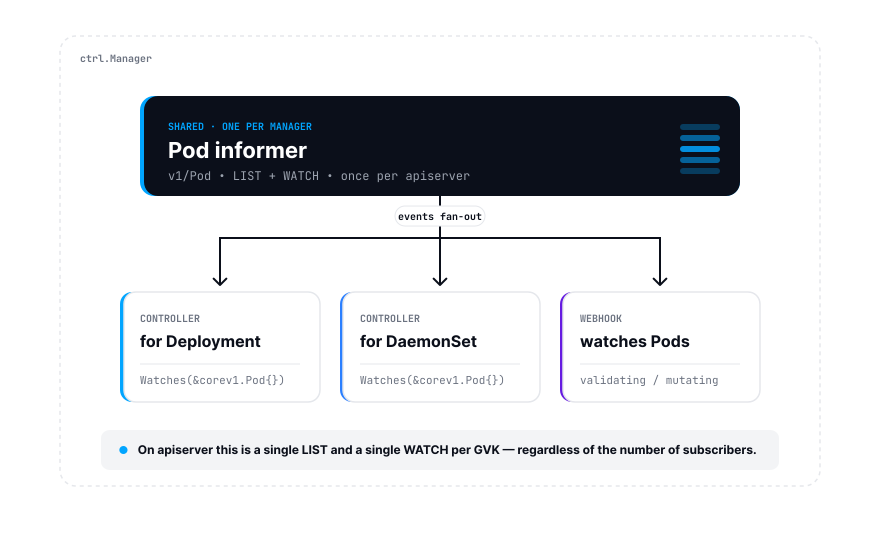
Además, el modelo de consistencia eventual impacta cómo los reconciliadores manejan las transiciones de estado. Asumir que una llamada Get() refleja inmediatamente una Update() anterior puede llevar a condiciones de carrera y errores lógicos. Los ingenieros deben diseñar reconciliadores que sean idempotentes y resilientes a lecturas obsoletas, tratando la caché local como una pista en lugar de una fuente definitiva de verdad. Este cambio de mentalidad previene controladores frágiles que fallan cuando el clúster está bajo carga pesada o cuando las particiones de red causan desincronización temporal.
Qué puedes hacer
- Audita los
Watchesde tu controlador para asegurarte de que solo estás almacenando en caché los tipos de recursos estrictamente necesarios para la lógica de reconciliación. - Usa predicados para filtrar eventos a nivel de informer, evitando que solicitudes de reconciliación innecesarias entren en la workqueue.
- Evita asumir consistencia inmediata después de las escrituras; diseña reconciliadores para manejar casos donde la caché local va detrás del API server.
- Monitorea el uso de memoria de tus pods de controlador, ya que las cachés grandes con muchos índices pueden causar fallos por falta de memoria (out-of-memory).
- Usa
APIReadersolo para casos específicos donde se requiera fuerte consistencia, como validar el estado final antes de completar un flujo de trabajo. - Prueba el comportamiento del controlador bajo altas tasas de cambio (churn) para identificar problemas con lecturas obsoletas o acumulaciones en la cola.



