Comment le cache de controller-runtime empêche la surcharge du serveur API
Une analyse approfondie du pattern list-watch et du cache local dans les contrôleurs Kubernetes, expliquant pourquoi les lectures sont peu coûteuses mais que la cohérence est éventuelle.
Traduit automatiquement depuis l'original anglais.
Dans un article publié sur le blog Kubernetes en juillet 2026, des ingénieurs ont détaillé la mécanique interne du cache controller-runtime. L'article clarifie la manière dont les contrôleurs écrits en Go interagissent avec le serveur API Kubernetes, corrigeant les idées reçues courantes concernant la cohérence des données et l'utilisation de la mémoire dans les environnements de production.
Ce qui s'est passé
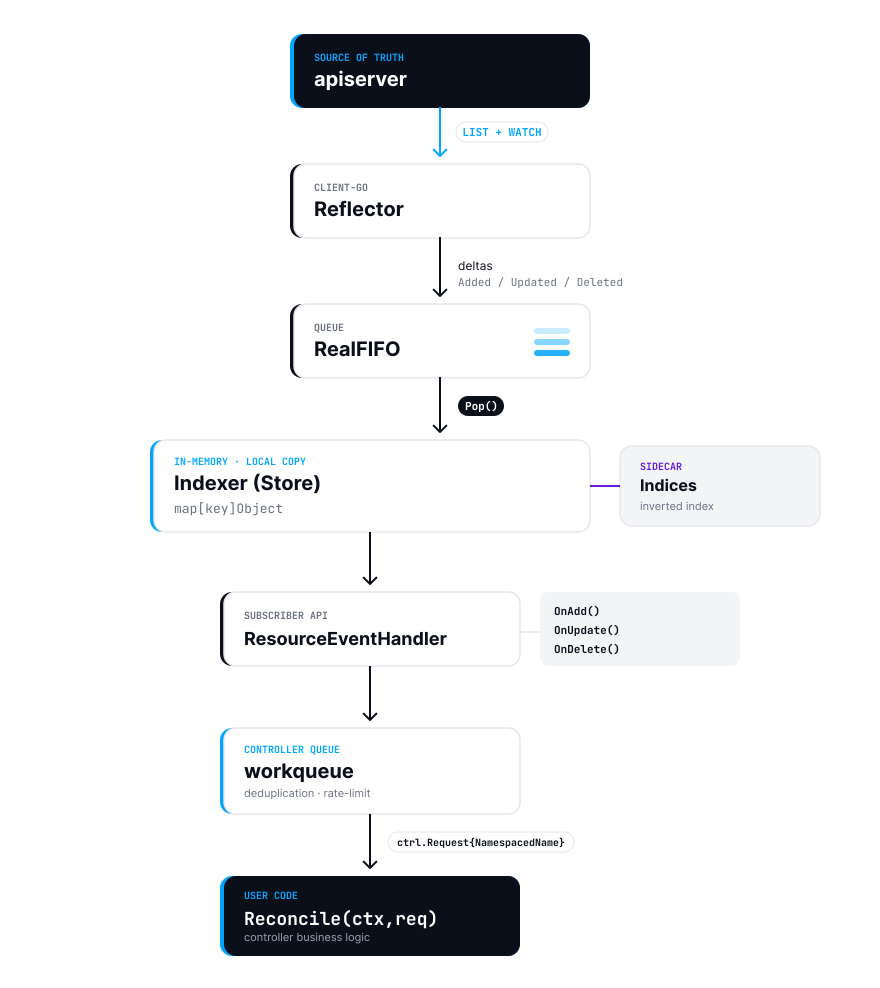
La publication aborde une incompréhension répandue parmi les développeurs créant des opérateurs Kubernetes : l'idée que chaque opération de lecture au sein d'un reconciler déclenche une requête HTTP directe vers le serveur API. En réalité, controller-runtime repose sur un cache local en mémoire, alimenté par un pattern list combiné à watch. Ce choix architectural garantit que les contrôleurs peuvent traiter des centaines de réconciliations par seconde sans submerger le plan de contrôle ni etcd.
Cependant, cette efficacité implique des compromis spécifiques. Comme les contrôleurs lisent depuis une copie locale plutôt que depuis la source de vérité en temps réel, ils peuvent rencontrer des données obsolètes immédiatement après une opération d'écriture. L'article souligne que si les écritures sont transmises directement au serveur API, les lectures sont servies depuis la mémoire, ce qui signifie que le système privilégie la disponibilité et la faible latence plutôt qu'une forte cohérence immédiate. Les développeurs ignorant ce modèle risquent de créer des contrôleurs consommant une mémoire excessive ou effectuant des scans linéaires inefficaces sur de grands jeux de données.
Cette explication sert de guide correctif pour les ingénieurs ayant observé des comportements inattendus dans des scénarios à forte charge. En cartographiant le flux allant du serveur API jusqu'au store informer local, les auteurs fournissent un modèle mental cohérent pour déboguer les problèmes liés à la pression mémoire, au trafic réseau et aux erreurs de logique de reconciliation.
Comment cela fonctionne
Le mécanisme central repose sur le Reflector, un composant de client-go qui maintient une surveillance continue (watch) sur des types de ressources spécifiques. Au démarrage, le Reflector récupère un instantané initial des objets qui l'intéressent. Les implémentations modernes utilisent une approche de liste en streaming, où le serveur API envoie des événements synthétiques ADDED pour les objets existants avant de passer aux événements de changement en direct. Cela élimine le besoin d'un appel bulk distinct pour la liste initiale, réduisant ainsi la surcharge de connexion.
Une fois l'état initial capturé, le Reflector maintient une connexion watch ouverte, utilisant le resourceVersion pour garantir qu'aucun événement n'est manqué. Si la connexion tombe, le Reflector se reconnecte en utilisant la dernière version connue. Si cette version est trop ancienne, le serveur API renvoie une erreur 410 Gone, forçant le Reflector à récupérer un nouvel instantané et à redémarrer le processus. Cela assure que le cache local reste éventuellement cohérent avec l'état du cluster.
Les changements entrants sont traités via une file d'attente delta. Les versions récentes de client-go (1.36+) utilisent RealFIFO, une file strictement ordonnée qui préserve la séquence globale des événements. Contrairement aux anciennes implémentations qui dédupliquaient les événements par objet, RealFIFO transmet chaque notification dans l'ordre. Cela signifie que si un objet est mis à jour trois fois rapidement, le gestionnaire d'événements du contrôleur recevra trois notifications de mise à jour distinctes, garantissant qu'aucun état intermédiaire n'est silencieusement ignoré avant d'atteindre la logique applicative.
Détails clés
r.Get()etr.List()au sein d'un reconciler lisent depuis un cache local en mémoire, et non depuis le serveur API.- Les écritures contournent le cache et vont directement au serveur API, ce qui signifie que les lectures suivantes peuvent retourner des données obsolètes.
- Le cache utilise un pattern list + watch, les implémentations modernes utilisant des listes en streaming pour la synchronisation initiale.
RealFIFOa remplacéDeltaFIFOdans les versions récentes declient-go, supprimant la déduplication automatique au niveau de la couche informer.- La consommation de mémoire est déterminée par la taille du cache local et le nombre de champs indexés, et pas seulement par le nombre d'objets.
APIReaderfournit un accès direct au serveur API mais doit être utilisé avec parcimonie en raison d'une latence et d'une charge plus élevées.
Pourquoi c'est important
Pour les ingénieurs logiciels développant des opérateurs, comprendre ce modèle de cache est crucial pour l'optimisation des performances. Puisque les lectures sont locales, ajouter plus d'index ou surveiller des types de ressources inutiles peut entraîner une utilisation de plusieurs gigaoctets de mémoire sans aucune augmentation visible de la charge du serveur API. Ce coût caché ne se manifeste souvent qu'à l'échelle de la production, rendant le diagnostic difficile lors du développement. Reconnaître que les opérations List() peuvent déclencher des scans linéaires sur l'ensemble du store local aide les développeurs à éviter d'écrire des logiques de filtrage inefficaces qui dégradent la réactivité du contrôleur.
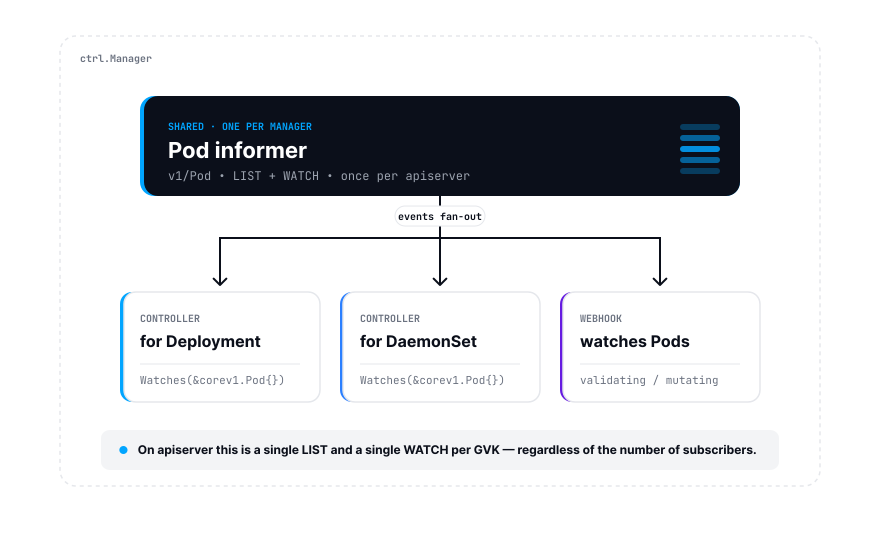
De plus, le modèle de cohérence éventuelle impacte la manière dont les reconcilers gèrent les transitions d'état. Supposer qu'un appel Get() reflète immédiatement un Update() précédent peut conduire à des conditions de course et à des erreurs logiques. Les ingénieurs doivent concevoir des reconcilers idempotents et résilients face aux lectures obsolètes, traitant le cache local comme une indication plutôt que comme une source de vérité définitive. Ce changement de mentalité prévient la création de contrôleurs fragiles qui échouent lorsque le cluster est sous forte charge ou lorsque des partitions réseau causent une désynchronisation temporaire.
Ce que vous pouvez faire
- Auditez les
Watchesde votre contrôleur pour vous assurer que vous ne mettez en cache que les types de ressources strictement nécessaires à la logique de reconciliation. - Utilisez des prédicats pour filtrer les événements au niveau de l'informer, empêchant les demandes de reconciliation inutiles d'entrer dans la workqueue.
- Évitez de supposer une cohérence immédiate après les écritures ; concevez des reconcilers capables de gérer les cas où le cache local est en retard par rapport au serveur API.
- Surveillez l'utilisation mémoire de vos pods de contrôleurs, car de grands caches avec beaucoup d'index peuvent provoquer des plantages dus à un manque de mémoire (OOM).
- N'utilisez
APIReaderque pour des cas spécifiques nécessitant une forte cohérence, tels que la validation de l'état final avant de compléter un workflow. - Testez le comportement du contrôleur sous des taux élevés de renouvellement (churn) pour identifier les problèmes liés aux lectures obsolètes ou aux arriérés de files d'attente.



