Wie der controller-runtime-Cache eine Überlastung des API-Servers verhindert
Ein tiefgehender Blick auf das List-Watch-Muster und lokales Caching in Kubernetes-Controllern, mit einer Erklärung, warum Lesevorgänge kostengünstig sind, die Konsistenz aber eventual ist.
Automatisch aus dem englischen Original übersetzt.
In einem Beitrag im Kubernetes Blog vom Juli 2026 haben Ingenieure die internen Mechanismen des controller-runtime-Caches detailliert beschrieben. Der Artikel klärt auf, wie Go-basierte Controller mit dem Kubernetes-API-Server interagieren, und korrigiert weit verbreitete Missverständnisse regarding Datenkonsistenz und Speichernutzung in Produktionsumgebungen.
Was passiert ist
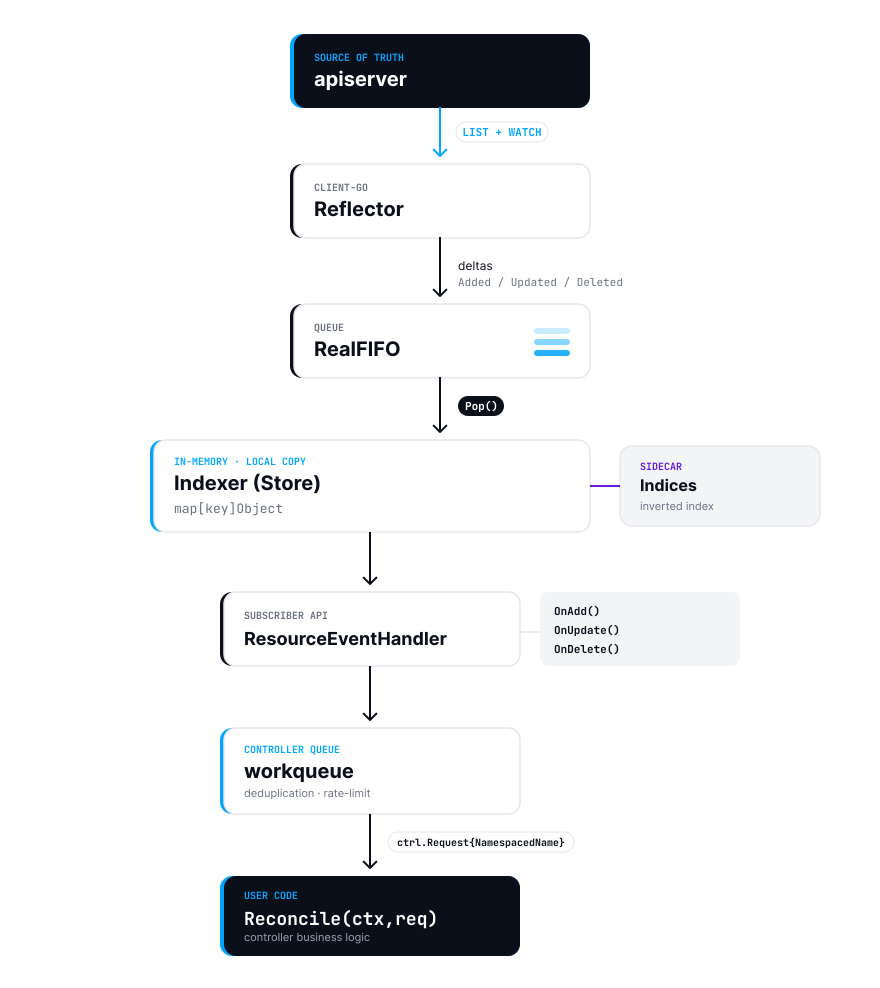
Die Veröffentlichung adressiert ein weit verbreitetes Missverständnis unter Entwicklern, die Kubernetes-Operatoren erstellen: die Annahme, dass jeder Lesevorgang innerhalb eines Reconcilers einen direkten HTTP-Antrag an den API-Server auslöst. In Wirklichkeit verlässt sich controller-runtime auf einen lokalen In-Memory-Cache, der über ein List- plus Watch-Muster befüllt wird. Diese architektonische Entscheidung stellt sicher, dass Controller Hunderte von Reconciliation-Vorgängen pro Sekunde verarbeiten können, ohne die Control Plane oder etcd zu überlasten.
Diese Effizienz bringt jedoch spezifische Kompromisse mit sich. Da Controller aus einer lokalen Kopie lesen, statt direkt aus der Live-Quelle der Wahrheit, können sie unmittelbar nach einem Schreibvorgang auf veraltete Daten stoßen. Der Artikel hebt hervor, dass während Schreibvorgänge direkt an den API-Server gehen, Lesevorgänge aus dem Speicher bedient werden, was bedeutet, dass das System Verfügbarkeit und niedrige Latenz gegenüber starker sofortiger Konsistenz priorisiert. Entwickler, die dieses Modell ignorieren, riskieren, Controller zu erstellen, die übermäßig viel Speicher verbrauchen oder ineffiziente lineare Scans über große Datensätze durchführen.
Die Erklärung dient als Korrekturleitfaden für Ingenieure, die unerwartetes Verhalten in Hochlastszenarien beobachtet haben. Durch die Abbildung des Flusses vom API-Server zum lokalen Informer-Store bieten die Autoren ein kohärentes mentales Modell zur Fehlersuche bei Problemen im Zusammenhang mit Speicherdruck, Netzwerkverkehr und Logikfehlern im Reconciler.
Wie es funktioniert
Der Kernmechanismus basiert auf dem Reflector, einer Komponente innerhalb von client-go, die einen kontinuierlichen Watch auf bestimmte Ressourcentypen aufrechterhält. Beim Start ruft der Reflector eine anfängliche Momentaufnahme der Objekte ab, die ihn interessieren. Moderne Implementierungen nutzen einen Streaming-List-Ansatz, bei dem der API-Server synthetische ADDED-Ereignisse für vorhandene Objekte sendet, bevor er auf Live-Änderungsereignisse umschaltet. Dies eliminiert die Notwendigkeit eines separaten Bulk-List-Aufrufs und reduziert den Verbindungsaufwand.
Sobald der Anfangszustand erfasst ist, hält der Reflector einen Watch offen und nutzt resourceVersion, um sicherzustellen, dass keine Ereignisse verpasst werden. Wenn die Verbindung abbricht, verbindet sich der Reflector unter Verwendung der zuletzt bekannten Version neu. Ist diese Version zu alt, gibt der API-Server einen 410 Gone-Fehler zurück, was den Reflector zwingt, eine neue Momentaufnahme abzurufen und den Prozess neu zu starten. Dies stellt sicher, dass der lokale Cache schließlich konsistent mit dem Cluster-Zustand bleibt.
Eingehende Änderungen werden über eine Delta-Queue verarbeitet. Neuere Versionen von client-go (1.36+) verwenden RealFIFO, eine streng geordnete Queue, die die globale Sequenz der Ereignisse beibehält. Im Gegensatz zu älteren Implementierungen, die Ereignisse pro Objekt deduplizierten, leitet RealFIFO jede Benachrichtigung der Reihe nach weiter. Das bedeutet, wenn ein Objekt dreimal schnell hintereinander aktualisiert wird, erhält der Event-Handler des Controllers drei separate Update-Benachrichtigungen, sodass kein Zwischenzustand vor Erreichen der Anwendungslogik stillschweigend verworfen wird.
Wichtige Details
r.Get()undr.List()innerhalb eines Reconcilers lesen aus einem lokalen In-Memory-Cache, nicht vom API-Server.- Schreibvorgänge umgehen den Cache und gehen direkt an den API-Server, was bedeutet, dass folgende Lesevorgänge veraltete Daten zurückgeben können.
- Der Cache nutzt ein List + Watch-Muster, wobei moderne Implementierungen Streaming-Listen für die initiale Synchronisation verwenden.
RealFIFOhatDeltaFIFOin neuerenclient-go-Versionen ersetzt und damit die automatische Deduplizierung in der Informer-Ebene entfernt.- Der Speicherverbrauch wird durch die Größe des lokalen Caches und die Anzahl der indizierten Felder bestimmt, nicht nur durch die Anzahl der Objekte.
APIReaderbietet direkten Zugriff auf den API-Server, sollte jedoch aufgrund höherer Latenz und Last sparsam eingesetzt werden.
Warum das wichtig ist
Für Software-Ingenieure, die Operatoren entwickeln, ist das Verständnis dieses Cache-Modells entscheidend für die Performance-Tuning. Da Lesevorgänge lokal stattfinden, kann das Hinzufügen weiterer Indizes oder das Beobachten unnötiger Ressourcentypen zu Gigabytes an Speichernutzung führen, ohne dass eine sichtbare Erhöhung der Last auf dem API-Server entsteht. Diese versteckten Kosten manifestieren sich oft erst im Maßstab der Produktion, was die Diagnose während der Entwicklung erschwert. Die Erkenntnis, dass List()-Operationen lineare Scans über den gesamten lokalen Store auslösen können, hilft Entwicklern, ineffiziente Filterlogiken zu vermeiden, die die Reaktionsfähigkeit des Controllers beeinträchtigen.
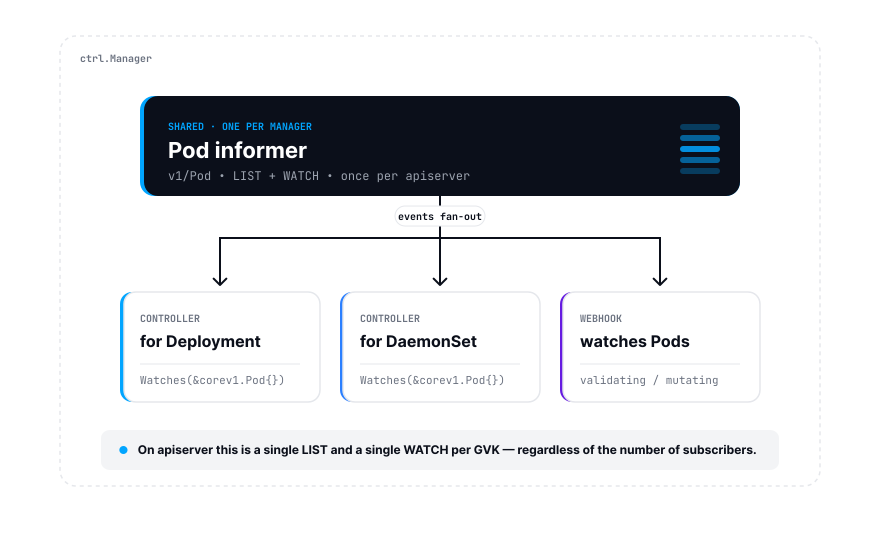
Darüber hinaus beeinflusst das Modell der eventual consistency, wie Reconciler Zustandsübergänge handhaben. Die Annahme, dass ein Get()-Aufruf sofort ein vorheriges Update() widerspiegelt, kann zu Race Conditions und logischen Fehlern führen. Ingenieure müssen Reconciler so gestalten, dass sie idempotent sind und robust gegen veraltete Lesezugriffe, indem sie den lokalen Cache als Hinweis und nicht als definitive Quelle der Wahrheit behandeln. Dieser Wandel im Mindset verhindert fragilen Controllern, die versagen, wenn der Cluster unter hoher Last steht oder wenn Netzwerkpartitionen zu temporären Desynchronisationen führen.
Was Sie tun können
- Prüfen Sie die
WatchesIhres Controllers, um sicherzustellen, dass Sie nur Ressourcentypen cachen, die für die Reconciliation-Logik strikt notwendig sind. - Verwenden Sie Prädikate, um Ereignisse auf der Informer-Ebene zu filtern, und verhindern Sie so, dass unnötige Reconciliation-Anfragen in die Workqueue gelangen.
- Gehen Sie nicht von sofortiger Konsistenz nach Schreibvorgängen aus; gestalten Sie Reconciler so, dass sie Fälle handhaben, in denen der lokale Cache hinter dem API-Server liegt.
- Überwachen Sie die Speichernutzung Ihrer Controller-Pods, da große Caches mit vielen Indizes zu Out-of-Memory-Abstürzen führen können.
- Nutzen Sie
APIReadernur für spezifische Fälle, in denen starke Konsistenz erforderlich ist, wie etwa die Validierung des Endzustands vor Abschluss eines Workflows. - Testen Sie das Verhalten des Controllers unter hohen Churn-Rates, um Probleme mit veralteten Lesezugriffen oder Queue-Staus zu identifizieren.



