Kubernetesのリソース制限:予測可能性と効率性のバランス
2023年の分析によると、KubernetesでCPUおよびメモリ制限を設定することは、クラスタの生効率を低下させる可能性があるものの、パフォーマンスの予測可能性を向上させると主張されています。
英語の原文から自動翻訳されました。
2023年11月のKubernetes Blogの投稿において、Grafana LabsのMilan Plžík氏は、コンテナオーケストレーションにおけるリソース制限の使用を支持する詳細な議論を展開しました。多くのエンジニアが速度向上のためにCPU制限の撤廃を提唱する中、この視点では、制限が本番システムにとって不可欠な安定性と予測可能性を提供する方法を強調しています。
何が起きたか
技術コミュニティでは、KubernetesユーザーがPodにCPU制限を設定すべきではないというアドバイスが増加しています。この見解の支持者は、制限がパフォーマンスを人工的にスロットリングし、アイドル期間中に利用可能な計算能力を無駄にすると主張します。「For the Love of God, Stop Using CPU Limits on Kubernetes」といった記事などにより、これらの制約を取り除くことで、隣接するワークロードから未使用のサイクルを借用してサービスをより高速に実行できるという考え方が普及しました。
Grafana Labsのサイト信頼性エンジニア(SRE)であるPlžík氏は、無制限のリソース消費に伴う運用リスクに焦点を当てることで、この主流の知見に異議を唱えました。彼は、制限を撤廃することで即時のパフォーマンス指標が改善される可能性がある一方で、重大な予測不可能性が導入されると指摘しました。定義された境界線がない状態でPodが共有ノードのリソースを競い合う場合、その動作は同じマシン上で実行されている他のアプリケーションの特定の組み合わせに大きく依存することになります。この変動性は、特にトラフィックスパイクやインフラ変更の際に一貫したサービスレベルを保証することを困難にします。
議論の核心は、追加リソースの隠れたコストが可観測性と制御の欠如にあるということです。制限がない場合、ある時点でPodがどの程度の容量を利用可能であったかを正確に判断することはほぼ不可能です。この不確実性は、Black Fridayなどの高トラフィックイベントのためのキャパシティプランニングを複雑にします。なぜなら、Podのビンパッキング(配置)が変われば、過去データが将来の制約を反映しない可能性があるからです。結果として、効率的に見えるリソース使用量は、予備容量が消滅した際にカスケード障害へと急速に変化することがあります。
仕組み
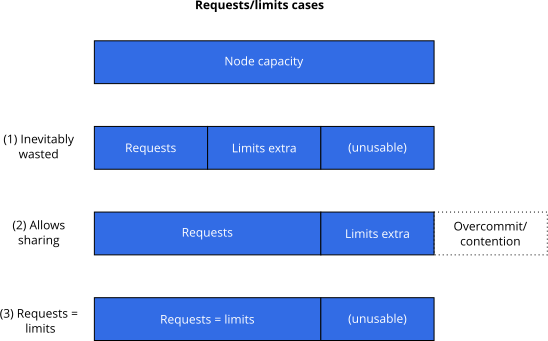
Kubernetesは、リクエストと制限を通じてリソースを管理します。リクエストはPodの実行に必要な最小限のCPUまたはメモリ量を指定し、制限は使用できる最大量を定義します。制限が削除されるか非常に高く設定されると、Podは上限に関してベストエフォートモードで動作します。ノード上の任意の空きリソースを消費できますが、これは各Podのパフォーマンスが隣接するPodの現在の負荷に完全に依存する「特別な雪片(special snowflake)」シナリオを生み出します。
Podがノードの物理的リソースを超えた場合、設定された制限に達した場合と同様に、スロットリングやアウトオブメモリ(OOM)キルに直面します。しかし、明示的な制限がない場合、これらの事象は予測およびデバッグがより困難になります。ワークロードが常に可変量の予備容量を吸収しているため、ワークロードが破綻点に近づいている時期に関する明確なシグナルがシステムから欠落します。これにより、プロファイリングやパフォーマンスチューニングが難しくなります。データサンプルが、稀だが重要なリソース使用量のスパイクを捕捉できない可能性があるためです。
予測可能性を回復するために、Plžík氏は2つの主要な構成戦略を提案しています。1つ目は「固定割合ヘッドルーム」であり、リクエストよりわずかに高いパーセンテージで制限を設定します。これにより、ある程度のバースト性を許容しつつ、各ノードでのオーバーコミット比率を範囲内に収めます。2つ目の戦略は、リクエストと制限を等しく設定することです。これにより、Podは保証付きサービス品質(Guaranteed QoS)クラスに配置され、専用リソースを受け取り、低優先度のPodよりも後にのみ退避(eviction)されることを保証します。両方のアプローチとも、安定した再現性のあるパフォーマンス特性を得るために、潜在的な効率の一部を犠牲にします。
主要な詳細
- 制限のないPodはノードの追加リソースを消費するため、そのパフォーマンスは隣接するPodの予測不可能な負荷に依存します。
- 特定の時点でPodがどの程度の予備容量を使用していたかを追跡するのは、広範なデータマイニングなしには困難であるため、可観測性が損なわれます。
- 制限のないPodからの過去のパフォーマンスデータは、高トラフィックイベント中にクラスタのビンパッキングが変化する場合、キャパシティプランニングに対して誤解を招く可能性があります。
- リクエストと制限を等しく設定すると、Guaranteed QoSクラスが割り当てられ、BestEffortおよびBurstable Podが削除されるまでPodが退避から保護されます。
- 固定割合ヘッドルームは、ノードごとのオーバーコミットを既知の範囲内に保ちながら、制限付きのバーストを可能にし、パフォーマンスの変動を減らします。
- 制限を撤廃すると、製品チームがコードを最適化するインセンティブが失われます。効率的な設計ではなく、無料の予備リソースに依存するようになるためです。
なぜ重要なのか
ソフトウェアエンジニアやプラットフォームチームにとって、制限を使用するかどうかの決定は、生の効率性と運用信頼性との間のトレードオフです。制限を撤廃することで、アイドルサイクルを活用してハードウェアからより多くの価値を引き出すことができますが、リソース競合のリスクをアプリケーション層に移転します。これにより、クラスタが圧力を受けているときに突然のレイテンシスパイクやOOMキルが発生し、緊急かつ反応的な容量増加が必要になることがあります。対照的に、制限を設定することは、ワークロードが既知のパラメータ内で動作するように強制する安全網を提供し、インシデントの診断と予防を容易にします。
このアプローチは、クラウドインフラのエコノミックモデルにも影響を与えます。チームが無制限の予備リソースへのアクセス権を持っている場合、最適化努力を怠り、制約のある条件下でパフォーマンスが低下する肥大化したサービスにつながる可能性があります。制限を課すことにより、組織は開発者にアプリケーションを適切なサイズに調整し、リソース不足に対処するように促します。この規律は、サービスレベル契約(SLA)の維持に役立ち、周囲のクラスタ状態に関係なくパフォーマンスが一貫していることを保証します。
さらに、予測可能なリソース使用量は、サイト信頼性エンジニアの作業を簡素化します。競合するPod間の複雑な相互作用をデバッグする代わりに、問題の分離のために定義された境界線に頼ることができます。この明確さは、予期せぬリソース競合が大規模な混乱を引き起こす可能性のある主要なアップグレードやスケーリングイベント中に極めて重要です。最終的な目標は、単に計算コストを節約することではなく、ストレス下で一貫して動作するレジリエントなシステムを構築することです。
実施できること
- 現在のKubernetesワークロードを監査し、CPUまたはメモリ制限なしで実行されているPodを特定してください。
- 時折バースト容量が必要なサービスについては、リクエストよりわずかに高い制限を設定することで、固定割合ヘッドルームを実装してください。
- クリティカルで遅延に敏感なサービスについては、リクエストと制限を等しく設定し、リソース圧力時にGuaranteed QoSと優先度を確保してください。
- 過去の監視データをレビューし、パフォーマンスの改善が真の最適化によるものか、それとも単にノードの予備リソースへのアクセスによるものかを検出してください。
- 最悪ケースの仮定ではなく、実際の使用パターンに基づいてリソースリクエストを適切なサイズに調整するためのガイドラインを製品チーム用に確立してください。
- 厳格なリクエスト-制限構成を使用する場合、Karpenterやノード自動プロビジョニングなどの自動化ツールを使用して、ビンパッキング効率を向上させてください。



