Límites de recursos en Kubernetes: equilibrar la previsibilidad y la eficiencia
Un análisis de 2023 sostiene que establecer límites de CPU y memoria en Kubernetes mejora la previsibilidad del rendimiento, aunque reduzca la eficiencia bruta del clúster.
Traducido automáticamente del original en inglés.
En una publicación en el Blog de Kubernetes en noviembre de 2023, Milan Plžík de Grafana Labs presentó un argumento detallado a favor del uso de límites de recursos en la orquestación de contenedores. Mientras muchos ingenieros abogan por eliminar los límites de CPU para aumentar la velocidad, esta perspectiva destaca cómo los límites proporcionan estabilidad y previsibilidad esenciales para los sistemas de producción.
Qué ocurrió
La comunidad técnica ha visto un aumento en los consejos que sugieren que los usuarios de Kubernetes deberían dejar de establecer límites de CPU en sus pods. Los defensores de esta visión argumentan que los límites estrangulan artificialmente el rendimiento y desperdician capacidad de cómputo pagada que podría utilizarse durante períodos de inactividad. Artículos como "Por el amor de Dios, deja de usar límites de CPU en Kubernetes" han popularizado la idea de que eliminar estas restricciones permite que los servicios se ejecuten más rápido al tomar prestados ciclos no utilizados de cargas de trabajo vecinas.
Plžík, Ingeniero de Fiabilidad del Sitio (SRE) en Grafana Labs, desafió esta sabiduría predominante centrándose en los riesgos operativos del consumo ilimitado de recursos. Señaló que, si bien eliminar los límites podría mejorar las métricas de rendimiento inmediatas, introduce una imprevisibilidad significativa. Cuando los pods compiten por recursos compartidos del nodo sin fronteras definidas, su comportamiento depende en gran medida de la mezcla específica de otras aplicaciones que se ejecutan en la misma máquina. Esta variabilidad dificulta garantizar niveles de servicio consistentes, especialmente durante picos de tráfico o cambios en la infraestructura.
El núcleo del argumento es que el costo oculto de los recursos adicionales es la falta de observabilidad y control. Sin límites, resulta casi imposible determinar exactamente cuánta capacidad tenía disponible un pod en cualquier momento dado. Esta incertidumbre complica la planificación de capacidad para eventos de alto tráfico como el Black Friday, donde los datos históricos pueden no reflejar las restricciones futuras si cambia el empaquetado binario subyacente de los pods. En consecuencia, lo que parece ser un uso eficiente de recursos puede convertirse rápidamente en fallos en cascada cuando desaparece la capacidad sobrante.
Cómo funciona
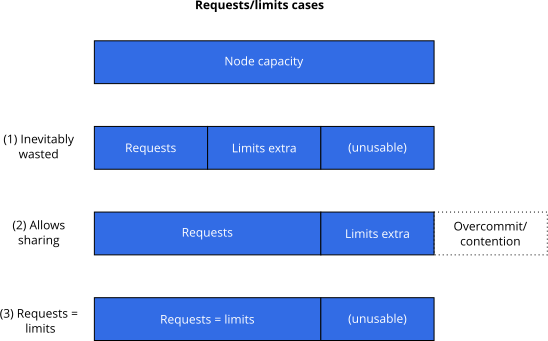
Kubernetes gestiona los recursos mediante solicitudes y límites. Una solicitud especifica la cantidad mínima de CPU o memoria que un pod necesita para ejecutarse, mientras que un límite define la cantidad máxima que puede usar. Cuando se eliminan los límites o se establecen muy altos, los pods operan en un modo de mejor esfuerzo con respecto a los límites superiores. Pueden consumir cualquier recurso libre en el nodo, pero esto crea un escenario de "copo de nieve único" donde el rendimiento de cada pod depende completamente de la carga actual de sus vecinos.
Si un pod supera los recursos físicos de su nodo, enfrenta limitación de velocidad (throttling) o terminaciones por falta de memoria (OOM), similar a alcanzar un límite configurado. Sin embargo, sin límites explícitos, estos eventos son más difíciles de predecir y depurar. El sistema carece de señales claras sobre cuándo una carga de trabajo se acerca a su punto de ruptura porque absorbe constantemente cantidades variables de capacidad sobrante. Esto dificulta el perfilado y la optimización del rendimiento, ya que las muestras de datos pueden no capturar picos raros pero críticos en el uso de recursos.
Para restaurar la previsibilidad, Plžík sugiere dos estrategias principales de configuración. La primera es el "margen de fracción fija", donde los límites se establecen en un pequeño porcentaje por encima de las solicitudes. Esto permite cierta capacidad de ráfaga mientras limita la proporción de sobrecompromiso en cada nodo. La segunda estrategia es igualar las solicitudes a los límites. Esto coloca al pod en la clase de Calidad de Servicio (QoS) Garantizada, asegurando que reciba recursos dedicados y solo sea desalojado después de los pods de menor prioridad. Ambos enfoques sacrifican algo de potencial eficiencia para ganar características de rendimiento estables y reproducibles.
Detalles clave
- Los pods sin límites consumen recursos adicionales del nodo, haciendo que su rendimiento dependa de la carga impredecible de los pods vecinos.
- La observabilidad sufre porque es difícil rastrear exactamente cuánta capacidad sobrante usó un pod en un momento específico sin una minería de datos extensa.
- Los datos de rendimiento histórico de pods ilimitados pueden ser engañosos para la planificación de capacidad si el empaquetado binario del clúster cambia durante eventos de alto tráfico.
- Establecer solicitudes iguales a límites asigna la clase QoS Garantizada, que protege a los pods del desalojo hasta que se eliminen los pods BestEffort y Burstable.
- El margen de fracción fija permite ráfagas limitadas manteniendo el sobrecompromiso por nodo dentro de un límite conocido, reduciendo la varianza del rendimiento.
- Eliminar los límites elimina los incentivos para que los equipos de producto optimicen su código, ya que dependen de recursos sobrantes gratuitos en lugar de un diseño eficiente.
Por qué importa
Para los ingenieros de software y los equipos de plataforma, la decisión de usar límites es un equilibrio entre la eficiencia bruta y la fiabilidad operativa. Si bien eliminar los límites puede exprimir más valor del hardware utilizando ciclos inactivos, transfiere el riesgo de contención de recursos a la capa de aplicación. Esto puede llevar a picos súbitos de latencia o terminaciones OOM cuando el clúster está bajo presión, requiriendo aumentos urgentes y reactivos de capacidad. En contraste, establecer límites proporciona una red de seguridad que obliga a las cargas de trabajo a comportarse dentro de parámetros conocidos, haciendo que los incidentes sean más fáciles de diagnosticar y prevenir.
Este enfoque también impacta el modelo económico de la infraestructura en la nube. Cuando los equipos tienen acceso a recursos sobrantes ilimitados, pueden descuidar los esfuerzos de optimización, lo que lleva a servicios inflados que funcionan mal bajo condiciones restringidas. Al imponer límites, las organizaciones animan a los desarrolladores a dimensionar correctamente sus aplicaciones y manejar la escasez de recursos con gracia. Esta disciplina ayuda a mantener los acuerdos de nivel de servicio (SLA) y asegura que el rendimiento permanezca consistente independientemente del estado circundante del clúster.
Además, el uso predecible de recursos simplifica el trabajo de los ingenieros de fiabilidad del sitio. En lugar de depurar interacciones complejas entre pods competidores, pueden confiar en fronteras definidas para aislar problemas. Esta claridad es crucial durante grandes actualizaciones o eventos de escalado, donde la contención inesperada de recursos puede causar interrupciones generalizadas. En última instancia, el objetivo no es solo ahorrar dinero en costos de cómputo, sino construir un sistema resiliente que se comporte de manera consistente bajo estrés.
Qué puedes hacer
- Los pods sin límites consumen recursos adicionales del nodo, haciendo que su rendimiento dependa de la carga impredecible de los pods vecinos.
- La observabilidad sufre porque es difícil rastrear exactamente cuánta capacidad sobrante usó un pod en un momento específico sin una minería de datos extensa.
- Los datos de rendimiento histórico de pods ilimitados pueden ser engañosos para la planificación de capacidad si el empaquetado binario del clúster cambia durante eventos de alto tráfico.
- Establecer solicitudes iguales a límites asigna la clase QoS Garantizada, que protege a los pods del desalojo hasta que se eliminen los pods BestEffort y Burstable.
- El margen de fracción fija permite ráfagas limitadas manteniendo el sobrecompromiso por nodo dentro de un límite conocido, reduciendo la varianza del rendimiento.
- Eliminar los límites elimina los incentivos para que los equipos de producto optimicen su código, ya que dependen de recursos sobrantes gratuitos en lugar de un diseño eficiente.



