Limites de ressources Kubernetes : équilibrer prévisibilité et efficacité
Une analyse de 2023 soutient que la définition des limites de CPU et de mémoire dans Kubernetes améliore la prévisibilité des performances, même si elle réduit l'efficacité brute du cluster.
Traduit automatiquement depuis l'original anglais.
Dans un article publié sur le blog Kubernetes en novembre 2023, Milan Plžík de Grafana Labs a présenté une argumentation détaillée en faveur de l'utilisation des limites de ressources dans l'orchestration de conteneurs. Alors que de nombreux ingénieurs prônent la suppression des limites de CPU pour accroître la vitesse, cette perspective met en lumière la manière dont les limites offrent une stabilité et une prévisibilité essentielles aux systèmes de production.
Ce qui s'est passé
La communauté technique a vu une augmentation des conseils suggérant aux utilisateurs de Kubernetes d'arrêter de définir des limites de CPU sur leurs pods. Les partisans de ce point de vue affirment que les limites brident artificiellement les performances et gaspillent la puissance de calcul payée qui pourrait autrement être utilisée pendant les périodes d'inactivité. Des articles tels que "For the Love of God, Stop Using CPU Limits on Kubernetes" ont popularisé l'idée selon laquelle la suppression de ces contraintes permet aux services de s'exécuter plus rapidement en empruntant des cycles inutilisés aux charges de travail voisines.
Plžík, ingénieur en fiabilité des sites (SRE) chez Grafana Labs, a remis en question cette sagesse dominante en se concentrant sur les risques opérationnels liés à une consommation illimitée des ressources. Il a noté que si la suppression des limites peut améliorer les métriques de performance immédiates, elle introduit une imprévisibilité significative. Lorsque les pods se disputent les ressources partagées d'un nœud sans frontières définies, leur comportement devient fortement dépendant du mélange spécifique d'autres applications exécutées sur la même machine. Cette variabilité rend difficile la garantie de niveaux de service cohérents, surtout lors des pics de trafic ou des changements d'infrastructure.
Le cœur de l'argument est que le coût caché des ressources supplémentaires est un manque d'observabilité et de contrôle. Sans limites, il devient presque impossible de déterminer exactement quelle capacité était disponible pour un pod à un moment donné. Cette incertitude complique la planification de la capacité pour les événements à fort trafic comme le Black Friday, où les données historiques peuvent ne pas refléter les futures contraintes si l'empilement (bin-packing) des pods change. Par conséquent, ce qui semble être une utilisation efficace des ressources peut rapidement se transformer en défaillances en cascade lorsque la capacité excédentaire disparaît.
Comment cela fonctionne
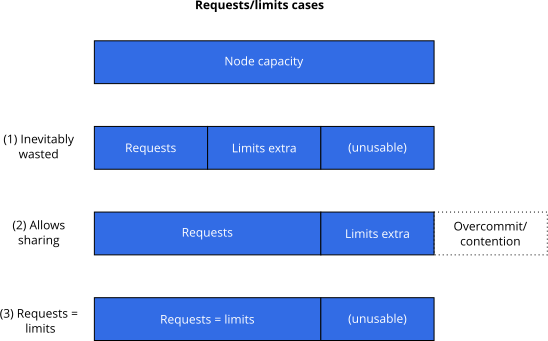
Kubernetes gère les ressources via les demandes (requests) et les limites (limits). Une demande spécifie la quantité minimale de CPU ou de mémoire dont un pod a besoin pour fonctionner, tandis qu'une limite définit la quantité maximale qu'il peut utiliser. Lorsque les limites sont supprimées ou fixées très haut, les pods fonctionnent dans un mode « best-effort » concernant les bornes supérieures. Ils peuvent consommer toutes les ressources libres du nœud, mais cela crée une situation de « flocon de neige spécial » où les performances de chaque pod dépendent entièrement de la charge actuelle de ses voisins.
Si un pod dépasse les ressources physiques de son nœud, il subit un étranglement (throttling) ou des tueries hors mémoire (OOM kills), semblable à l'atteinte d'une limite configurée. Cependant, sans limites explicites, ces événements sont plus difficiles à prédire et à déboguer. Le système manque de signaux clairs indiquant quand une charge de travail approche de son point de rupture, car il absorbe constamment des quantités variables de capacité excédentaire. Cela rend le profilage et l'optimisation des performances difficiles, car les échantillons de données peuvent ne pas capturer des pics rares mais critiques dans l'utilisation des ressources.
Pour rétablir la prévisibilité, Plžík suggère deux stratégies de configuration principales. La première est la « marge fixe fractionnaire » (fixed-fraction headroom), où les limites sont définies à un petit pourcentage au-dessus des demandes. Cela permet une certaine capacité de rafale tout en bornant le ratio de sur-engagement (overcommit) sur chaque nœud. La deuxième stratégie consiste à définir les demandes égales aux limites. Cela place le pod dans la classe de qualité de service (QoS) Guaranteed, garantissant qu'il reçoit des ressources dédiées et n'est évicté qu'après les pods de priorité inférieure. Ces deux approches sacrifient une partie de l'efficacité potentielle pour obtenir des caractéristiques de performance stables et reproductibles.
Détails clés
- Les pods sans limites consomment des ressources supplémentaires du nœud, rendant leurs performances dépendantes de la charge imprévisible des pods voisins.
- L'observabilité souffre car il est difficile de suivre exactement combien de capacité excédentaire un pod a utilisée à un moment précis sans fouille approfondie des données.
- Les données de performance historiques provenant de pods sans limites peuvent être trompeuses pour la planification de la capacité si l'empilement des pods du cluster change lors d'événements à fort trafic.
- Définir les demandes égales aux limites attribue la classe QoS Guaranteed, qui protège les pods contre l'éviction jusqu'à ce que les pods BestEffort et Burstable soient retirés.
- La marge fixe fractionnaire permet des rafales limitées tout en maintenant le sur-engagement par nœud dans une borne connue, réduisant ainsi la variance des performances.
- La suppression des limites élimine les incitations pour les équipes produit à optimiser leur code, car elles comptent sur des ressources excédentaires gratuites plutôt que sur une conception efficace.
Pourquoi c'est important
Pour les ingénieurs logiciels et les équipes de plateforme, la décision d'utiliser des limites est un compromis entre l'efficacité brute et la fiabilité opérationnelle. Bien que la suppression des limites puisse extraire plus de valeur du matériel en utilisant les cycles inactifs, elle transfère le risque de contention des ressources à la couche applicative. Cela peut entraîner des pics soudains de latence ou des tueries OOM lorsque le cluster est sous pression, nécessitant des augmentations urgentes et réactives de la capacité. En revanche, la définition de limites fournit un filet de sécurité qui force les charges de travail à se comporter dans des paramètres connus, rendant les incidents plus faciles à diagnostiquer et à prévenir.
Cette approche impacte également le modèle économique de l'infrastructure cloud. Lorsque les équipes ont accès à des ressources excédentaires illimitées, elles peuvent négliger les efforts d'optimisation, conduisant à des services gonflés qui fonctionnent mal dans des conditions contraintes. En imposant des limites, les organisations encouragent les développeurs à dimensionner correctement leurs applications et à gérer la rareté des ressources avec élégance. Cette discipline aide à maintenir les accords de niveau de service (SLA) et garantit que les performances restent cohérentes indépendamment de l'état environnant du cluster.
De plus, une utilisation prévisible des ressources simplifie le travail des ingénieurs en fiabilité des sites. Au lieu de déboguer des interactions complexes entre des pods concurrents, ils peuvent compter sur des frontières définies pour isoler les problèmes. Cette clarté est cruciale lors des mises à jour majeures ou des événements de mise à l'échelle, où une contention inattendue des ressources peut causer des perturbations généralisées. En fin de compte, l'objectif n'est pas seulement d'économiser de l'argent sur les coûts de calcul, mais de construire un système résilient qui se comporte de manière cohérente sous contrainte.
Ce que vous pouvez faire
- Identifiez les pods sans limites qui consomment des ressources supplémentaires du nœud, rendant leurs performances dépendantes de la charge imprévisible des pods voisins.
- Mettez en œuvre des outils d'observabilité adaptés pour mieux suivre l'utilisation réelle des ressources, y compris la capacité excédentaire consommée.
- Revoyez vos données de performance historiques pour vérifier si elles restent pertinentes pour la planification de la capacité, surtout si la stratégie d'empilement des pods évolue.
- Évaluez l'attribution de la classe QoS Guaranteed aux pods critiques en définissant les demandes égales aux limites pour les protéger contre l'éviction.
- Implémentez la stratégie de « marge fixe fractionnaire » pour permettre des rafales limitées tout en contrôlant le sur-engagement par nœud.
- Encouragez les équipes produit à optimiser leur code en instaurant des limites de ressources, afin de ne pas dépendre uniquement de la disponibilité des ressources excédentaires.
- Utilisez des outils automatisés comme Karpenter ou Cluster Autoscaler pour améliorer l'efficacité de l'empilement des pods tout en respectant les limites définies.



